


最近整个 AI 圈都被一个叫 Jev 的新模型刷屏了。这家名为 TypeSafe AI 的旧金山团队刚发布 Jev 就拿下了 4000 万美元的种子轮融资,引发无数开发者排队试用。
但最让人称奇的是它的反差感:在这个大家都比拼谁的 AI 更会聊天、谁能写出更长文章的时代,Jev 却是一个根本“不会说话”的 AI。它不能陪你闲聊,不会写诗写文案,甚至连一句简单的“总结”都生成不了。
一个连话都不会说的 AI,凭什么引爆全网?它究竟是什么、有什么与众不同的特性、相比普通大模型又有何优势?本文将用最通俗易懂的语言,为你拆解这个 AI 圈的“另类黑马”。
一、Jev 是什么:教会 AI 说话的人,做出了一个“拒绝说话”的 AI
要理解 Jev,得先看它的创造者——Diogo Almeida。
这位前 OpenAI 研究员有一个极其硬核的履历:他是 RLHF(人类反馈强化学习) 训练方法的共同发明者之一。正是当年这套技术,把原本只会吐字的冷冰冰底层模型,驯化成了今天能言善辩、体贴入微的 ChatGPT。
按理说,这位“教会大模型说话”的核心功臣,应该继续把 AI 调教得更能聊才对。但他却被一个困扰了四年的问题卡住了:
“大模型在聊天这件事上早就超越了普通人,行业砸进去了几万亿美元,但现实生活中的大部分软件,为什么依然没有变得真正自动化、真正智能?”
答案藏在现实软件的本质里。
能聊天的“顾问”,成不了流水线的“质检员”
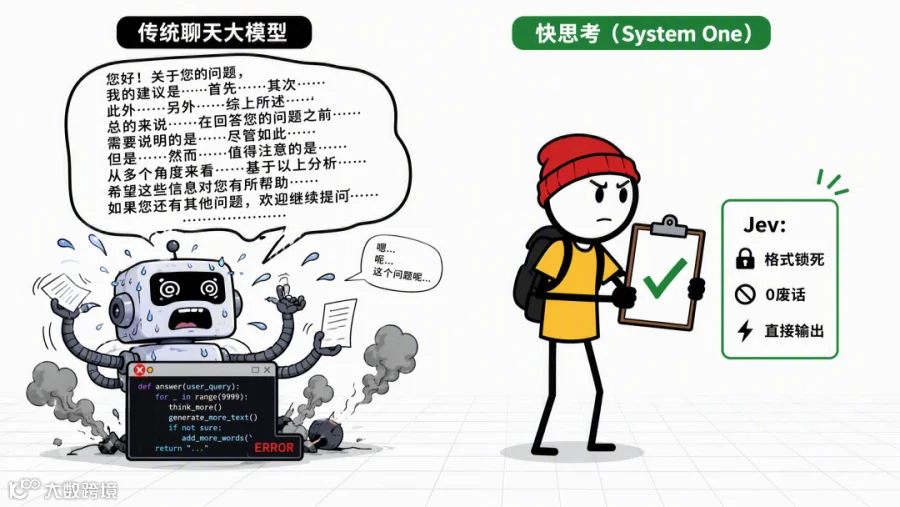
我们平时用的 ChatGPT、豆包或 Claude,就像一位满腹经纶、口若悬河的咨询顾问。无论你抛出什么话题,它都能引经据典、长篇大论地跟你聊上半天。
但在真实的工业系统和软件业务中,程序最需要的往往不是一篇洋洋洒洒的小作文,而是一个干脆利落的开关判断:
如果你把这些任务交给传统聊天大模型,实际流程往往苦不堪言:
这种自由发散的文本生成能力,在陪人聊天时是优点;但一旦放到没人盯守的自动化流水线上,不可控就是致命伤。哪怕万分之一的概率格式崩盘,整个系统都会报错宕机。
Jev 的物种定位:直觉判断系统(System One)
Jev 彻底颠覆了这种逻辑。它不是文本生成模型,而是一个专门做“分类与决策”的确定性模型。
用心理学常说的“快思考与慢思考”来类比:
你不需要跟 Jev 对话。你只要递给它一份“材料(状态)”,再给它一张固定好的“调查问卷”,它就会像一个面无表情但极其专注的质检员,在你划好的格子里打勾。
二、Jev 有什么特点:三道题型、自知之明与超级并行
Jev 的运行方式与传统的 Prompt 提示词完全不同。它拥有三个极为鲜明的核心特点:
1. 只有三种极简“问法”
在 Jev 的世界里,所有复杂的问题都被规约成了三种最基础的积木(Primitives):
0.99,意味着几乎确定是退款。
1.3 分——既不是生硬的 1 也不是 2,而是告诉你“属于功能损坏但微偏向严重”。
2. 数学上保证“格式零幻觉”
传统大模型所谓“保证输出 JSON”,本质上依然是在用文字概率一个个猜括号和逗号,随时可能少个引号或逗号导致代码崩溃。
而 Jev 从底层架构上就把答案的类型给死死锁定了。你问它单选题,它物理上不可能输出第四个你没写过的选项;你让它打分,它绝不可能蹦出一句中文长篇大论。它输出给你的数据永远是干净、强类型、开箱即用的,后端程序拿到直接可以写 if...else... 做业务分流。
3. 老实坦白“把握度”(Confidence)
传统大模型有个坏毛病:无论自己懂不懂,回答时都显得无比笃定、信心满满,哪怕瞎编乱造也面不改色。
Jev 每次给出判断时,会同时附带一个把握度指标(Confidence)和完整的概率分布。
这种“拿不准就坦诚露怯”的机制,为工程落地带来了前所未有的安全感。开发者可以轻松实现梯级路由:

4. 极致的并行处理:“多问不加时”
普通大模型回答的问题越多、生成的字数越长,花费的时间和费用就呈线性暴增。
而 Jev 的提问是彼此独立且高度并行的。在同一份材料上,你哪怕同时问它 10 个甚至 20 个问题:
它会几乎在同一瞬间把所有答案并行计算出来,耗时几乎没有任何增加。这彻底颠覆了过去“为了省钱省时间,能少问大模型一句就少问一句”的开发心智,鼓励开发者把所有的细微特征一次性问完。
三、Jev 的核心优势:为什么它被称为自动化革命?
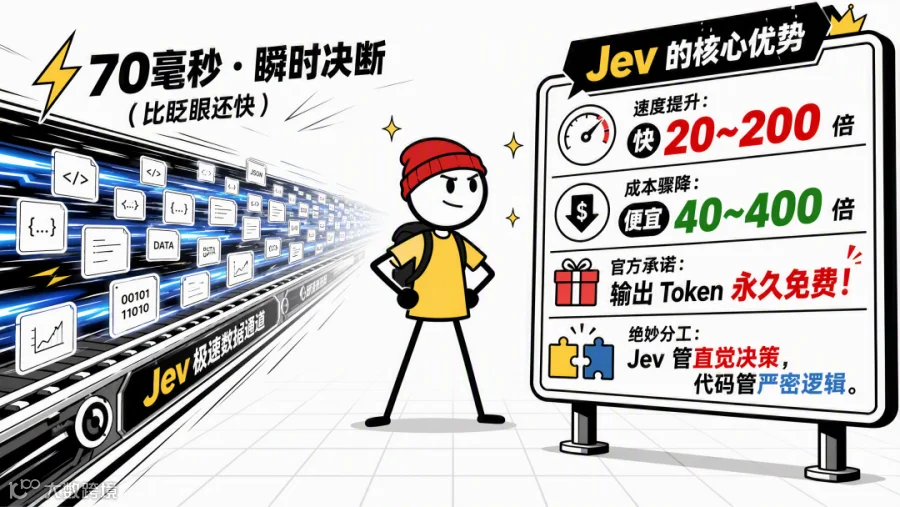
相比于动辄百亿千亿参数的聊天大模型,Jev 的优势可以用十二个字概括:快如眨眼、便宜至极、架构自然。
1. 速度快 20 到 200 倍:进入百毫秒响应时代
传统大模型生成一句话,像挤牙膏一样一个词一个词地往外吐(自回归生成),往往需要 2 秒到 5 秒甚至更久。
而 Jev 不需要逐字写话,它的单次全量判断仅需 70 毫秒到 500 毫秒。 500 毫秒是什么概念?人类眨一次眼睛大概需要 300 毫秒。这意味着在用户点击网页按钮的刹那,或者数据流经网关的瞬间,Jev 就能完成数十个维度的语义审视并完成路由,用户完全感受不到任何延迟。
2. 成本降 40 到 400 倍:输出直接免费
由于 Jev 不需要耗费海量算力去生成文字 Token,它的定价直接打破了行业的收费常理:
这种成本降维打击,打开了一大片过去“想都不敢想”的场景。比如数据库里堆积的千万条历史聊天记录、每天产生的大规模用户反馈、全网抓取的海量行业新闻,过去用大模型清洗一次可能要花几万甚至几十万元;换用 Jev,几十块钱就能全部筛一遍。
3. 与现代软件代码的天然契合
现代软件架构的核心是确定的控制流(分支、循环、规则引擎)。Jev 完美充当了传统代码与 AI 之间的“粘合剂”:
二者各司其职,不仅消除了提示词工程中无休止的“猜谜”调试,也让自动化系统具备了工业级的可测性与鲁棒性。
四、理性看待:Jev 的能力边界与避坑指南
了解一个工具的局限,比了解它的优点更重要。Jev 之所以能做到极快极廉价,是因为它做了极具勇气的舍弃。
TypeSafe AI 官方非常坦诚地列出了 Jev 目前的“笨拙之处”,使用时必须牢记:
|
|
|
|---|---|
| 模糊常识判断
|
精确数学与计算
|
| 海量内容初筛
|
时间日期前后比较
|
| 智能体快速反应
|
长篇文本与文案生成
|
| 作为守门员
|
需要严密多步逻辑推演的任务
|
此外,Jev 不会像传统大模型那样说“抱歉,我无法回答该问题”,它对任何提问都会强行给出一个概率,因此在涉及敏感内容或权限管控的场景下,外部必须由业务代码做好安全围栏。
总结:智能成本骤降带来的新机会
如果用一句话总结 Jev:它牺牲了“写作与聊天”的能力,换来了在“分类与决策”上的极致速度与极致低价。
它并不打算取代 ChatGPT,而是为 AI 应用落地补上了最缺失的一块拼图。当一个具备人类常识判断能力的模型,速度快到了百毫秒以内、成本降低了数百倍时,真正的大规模自动化才有了落地的土壤。
对于开发者和普通人而言,学会将“快思考的 Jev”与“慢思考的逻辑代码/大模型”组合使用,将是未来构建高效 AI 原生系统的关键基本功。