

⭐ 设为星标 · 第一时间收到推送
这也是它突然火起来的原因。把“写字”砍掉之后,速度、价格和输出稳定性都变了。但要把它用对,关键不在模型多聪明,而在问题能不能被拆成边界清楚的小决定。
Jev 到底是什么
9 月 15 日,TypeSafe AI 发布了首个“System One Model”——Jev。创始人 Diogo Almeida 称,团队为它设计了新的模型架构、并行采样器,以及一套名为 RLCD(Reinforcement Learning for Calibrated Decisions)的训练方法。
Jev 不是 Agent,也不是缩小版 ChatGPT。它接收一段 state,也就是程序当前的状态,再回答开发者提前定义好的问题。输出被限制在三种形式里:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
假设客户说:“鞋码不对,而且退款还没到账。”你可以让 Jev 同时判断该转给哪个部门、客户是否要求退款、情绪有多激烈。它不写解释,直接返回选项、分数和概率。

这些问题会并行处理。代码再根据置信度决定自动执行、调用更强模型,还是转给人工。官方文档把它形容成“会理解语义的函数调用”,这个比喻很准确。
目前 Jev 只接受文本、JSON 对象和文本数组,不支持图片、音频和视频,也不会生成回复、代码或推理解释。TypeSafe API 使用 jev-latest,Vercel AI Gateway 的模型名是 typesafe-ai/jev,OpenRouter 上则是 typesafe/jev-1.13。
它为什么能这么快
普通大模型需要一个 Token 接一个 Token 地生成结果。哪怕最后只要一个 JSON,它也得先“写”完整段内容,再由程序解析。
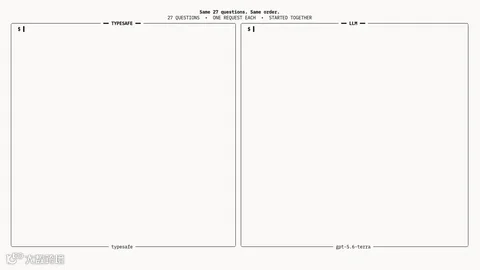
Jev 不走这条路。它直接计算各个候选答案的概率,而且多个问题可以同时算。下面这段官方对比视频里,两边接收相同问题:普通大模型仍在逐字输出,Jev 已经把全部判断一起返回。
OpenRouter 当前标价是 每百万输入 Token 0.042 美元,输出免费,上下文窗口 32K,页面显示的 P50 延迟约 0.23 秒。TypeSafe 给出的常见响应时间是 70—500 毫秒。
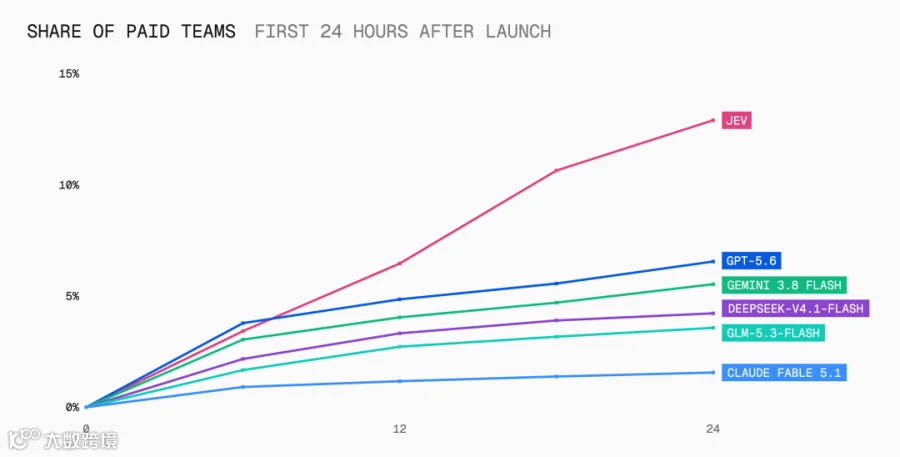
Vercel 的数据更能说明开发者为什么兴奋:Jev 上线 AI Gateway 后,24 小时内被接近 13% 的付费团队使用,成为该平台采用速度最快的新模型。
TypeSafe 的内部工作流评测给出的最高结果是 193.6 倍更快、444.6 倍更便宜。这不是所有任务都能复制的平均成绩,官方博客也承认,四个工作流由内部团队制作,数字更接近现实收益的高端区间。
真要接进系统,应该怎么用
Jev 最容易用错的地方,是把它当成另一个通用模型。更合适的接法分四步。
第一步,只给它当前判断需要的 state。工单分类就放客户消息、订单状态和已有标签,不要把几万字历史记录全部塞进去。创始人在 X 上专门把这件事叫作“state engineering”。
第二步,把一个模糊大问题拆成多个小问题。不要问“接下来该怎么办”,而是分别问:转给哪个部门?是否要求退款?紧急程度属于哪一级?这三项可以并行返回。
思路大致可以写成这样,下面是结构示意,不是可直接复制的 SDK 请求:
{ "state": { "message": "鞋码不对,而且退款还没到账", "order_status": "returned" }, "questions": [ {"type": "choice", "options": ["售后", "物流", "财务"]}, {"type": "noul", "question": "客户是否在要求退款"}, {"type": "score", "scale": [0, 1, 2, 3, 4]} ] } 第三步,在代码里设置信心阈值。比如高于 0.92 才自动执行,中间区间交给更强模型,低置信度或高风险请求转人工。具体数字要用自己的数据校准,不能照抄示例。
第四步,把执行和验证留在代码里。Jev 可以判断“该退款”,真正调用退款接口之前仍要检查金额、权限和幂等性;浏览器操作也要在点击后确认页面状态有没有变化。

确定性规则继续写在代码里,模糊但边界清楚的判断交给 Jev,复杂推理和内容生成再调用大模型。
哪些场景适合,哪些不适合
Jev 最适合的,不是“替代所有 LLM”,而是从软件循环里拿走那些高频、重复、答案有限的判断。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
创始人还用 Jev 玩了一段《Doom》。模型每秒大约做 10 次判断,持续读取游戏状态,选择射击、躲避、寻找补给等动作。官方估算成本约每小时 7 美元。

这个 demo 有意思,但它首先证明的是吞吐和低延迟,不等于 Jev 已经会做复杂规划。游戏循环里真正执行动作、读取地图和检查结果的,仍然是外部代码。
反过来,下面几类任务不要硬塞给 Jev:写文章、写代码、总结会议、解释推理过程;需要理解整份长文档才能下结论的任务;付款、删库、医疗或合规审批等不可逆操作;以及已经积累大量标注数据、可以用本地小模型稳定解决的固定分类任务。
一些值得看的真实测试
我筛选了一些使用案例,只保留有原始截图或演示视频、并且经过充分传播的案例。下面四个测试分别对应规模化分类、工程接入、第三方性能测试和高风险反例,比单纯复述“快多少倍、便宜多少倍”更容易看懂 Jev 到底能做什么。
第一个是 10 万条 X 帖子的批量分析。开发者给每条帖子设置了 14 个判断题,例如“开头有没有制造悬念”“首行有没有数字”“证据是真实还是声称的”。Jev 在 20.4 秒内处理完 10 万条帖子,总成本 0.67 美元。画面右侧能看到每个问题的判断和置信度,左侧则不断切换被分析的帖子。
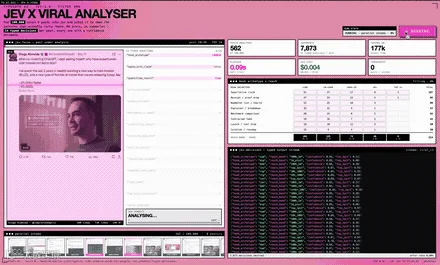
这很像 Jev 的标准用法:不是让模型总结 10 万条帖子,而是把一项模糊分析拆成 14 个窄问题,再并行跑完。作者还拿 Claude Opus 5 做了同机对照,但这不是严格的标准基准,调度方式、并发和提供商链路都会影响数字。真正值得参考的是工作负载本身:任务重复、答案有限、单次输入短,正好适合决策模型。
第二个案例是 Hono 的 JevRouter。普通 Web 路由依赖 URL 和请求方法,它尝试按请求的“含义”分流。图里的两条规则分别匹配“来自 AI Agent 的请求”和“来自人类浏览器的请求”,然后返回不同格式的文档。
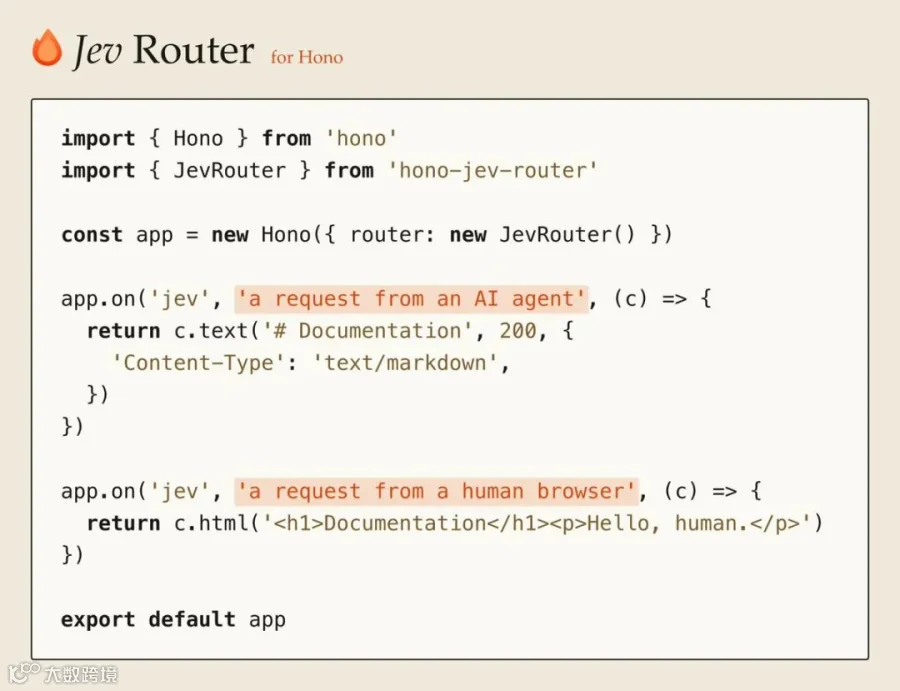
这个例子看起来没有游戏 demo 炫,但更接近真实工程。Jev 不负责生成页面,只在现有程序里回答“这次请求更像哪一类”,代码仍然控制响应内容、权限和后续动作。客服分流、工具选择、权限前置判断,都可以用同样的结构。
第三个案例来自 OpenRouter 的 Ori Eval。他们把 200 条合成请求平均分到 30 个任务类型,让五个模型逐条、无状态地完成分类。Jev 1.13 的中位延迟是 154 毫秒,第二名 GPT-5.6 Luna 是 860 毫秒;这组任务里,五个模型的分类正确数只差几个样本。
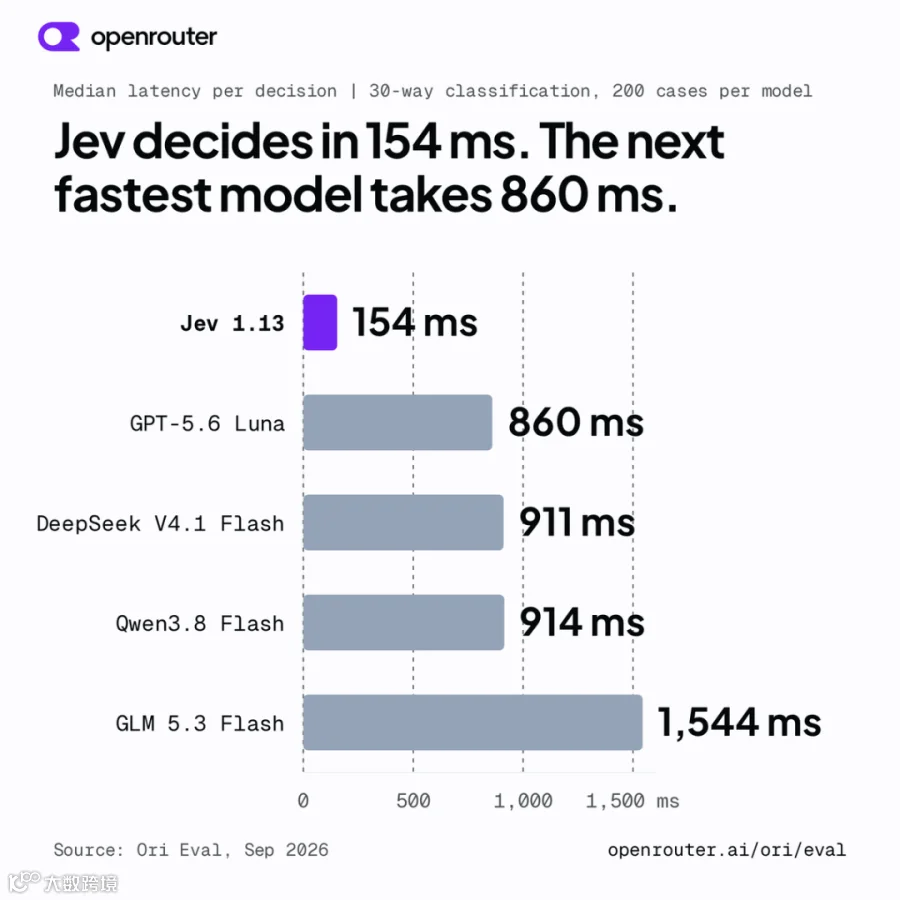
这张图能证明 Jev 在窄分类任务上确实快,但不能外推到所有 Agent 工作流。样本是合成的,类别分布也刻意做得很均匀;真实流量通常会头重脚轻,还会混入脏数据和长尾请求。更稳妥的做法,是拿自己的历史流量重跑一次,再决定阈值和兜底模型。
最后一个案例反而最该看。一位开发者用一晚加一个上午做了自动交易机器人,让 Jev 持续读取链上、链下数据并选择买入或卖出。界面很流畅,概率也很“像回事”,但作者报告的结果是亏损 31,680 美元。

它把 Jev 的边界展示得比成功案例更清楚:低延迟只能让决策更快执行,不能自动补上交易策略、风险控制和因果判断。付款、交易、删库这类不可逆动作,不能把模型概率直接接到执行接口。至少要有仓位上限、止损、回测、模拟盘和人工批准。
所以,“Jev 不会幻觉”只能听一半。准确说法是:它不会返回预定义类型之外的内容。 让它从“售后、物流、财务”里三选一,它不会编出第四个部门;但一个格式完全正确的“财务”,照样可能是错的。
Jev 不是大模型的替代品。它更像一把手术刀:把高频、受限、可以验证的判断从大模型里剥出来。能提前写清选项、能用数据校准阈值、出错后能验证和回滚,这类任务值得试;否则,便宜和快只会让错误跑得更勤。