

⭐ 设为星标 · 第一时间收到推送

它不写摘要,只决定哪些记录还能删
普通的上下文压缩,会让模型把前面的对话重新写成一份短摘要。问题也很直白:文件路径、精确报错、限制条件和已经试过的失败方案,都可能在改写时消失。
fast-jev-compaction 换了一个思路。它把每个 tool_use 和对应的 tool_result 配成一组,再让 TypeSafe 的 Jev 分别回答两个问题:这个调用还需要保留吗?它的结果还需要原样保留吗?
Jev 不是聊天模型。它接收一段状态和一组结构化问题,返回概率,让代码自己决定下一步。这个插件的默认阈值是 0.5:
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
演示里,绿色是保留,红色是删除。插件在一轮请求中给旧工具记录打分,最近 6 条消息和第一条消息默认不会动。

为什么这个点子一看就很香
它最吸引人的地方是不改写保留下来的内容。一条路径、一段报错或者一条命令只要被留下,就还是原文,不会变成摘要器眼里的“大概意思”。
项目也给自己留了退路:Jev 请求失败、返回格式不对,或者压缩幅度不够,Claude Code 插件会回退到内置摘要。开发者还能单独设置保留阈值、最近消息数量和最大状态长度。
这很适合一种常见的 Agent 会话:模型读了很多文件,也跑了很多搜索和测试。大部分旧结果后来已经没用,少数错误信息却必须原样留下。此时可以先剪掉明显的噪音,再决定要不要做完整摘要。
项目地址:https://github.com/tamaratran/fast-jev-compaction

Theo 为什么说“压缩不是筛选”
Theo(t3.gg)看过演示后写了一篇措辞很重的长评,开头就说:"Compaction isn't a filter"。他的核心区分是:整理任务状态和逐条过滤工具记录并不是一回事。
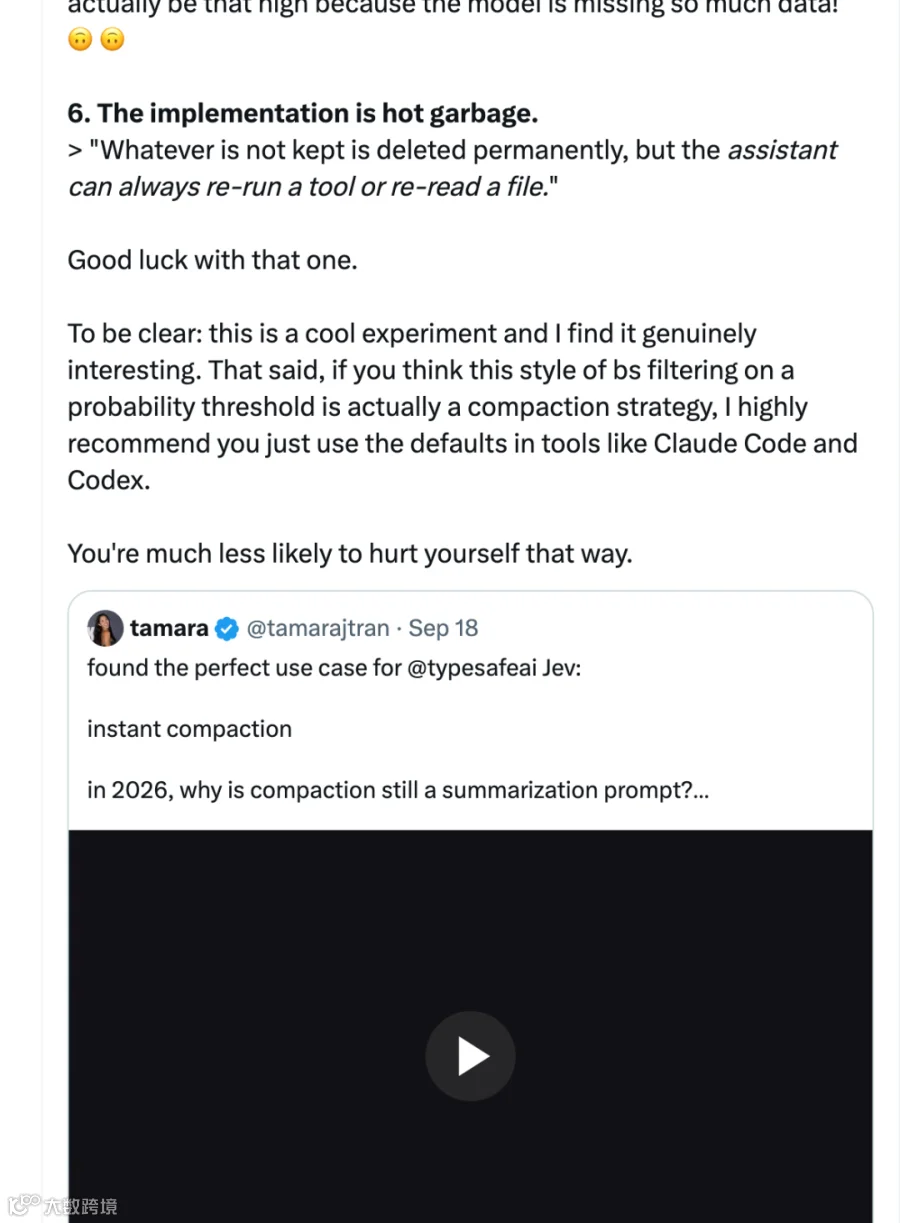
下面三张截图是他的完整长评。原文一共列了六条,其中五条直接关系到使用效果。
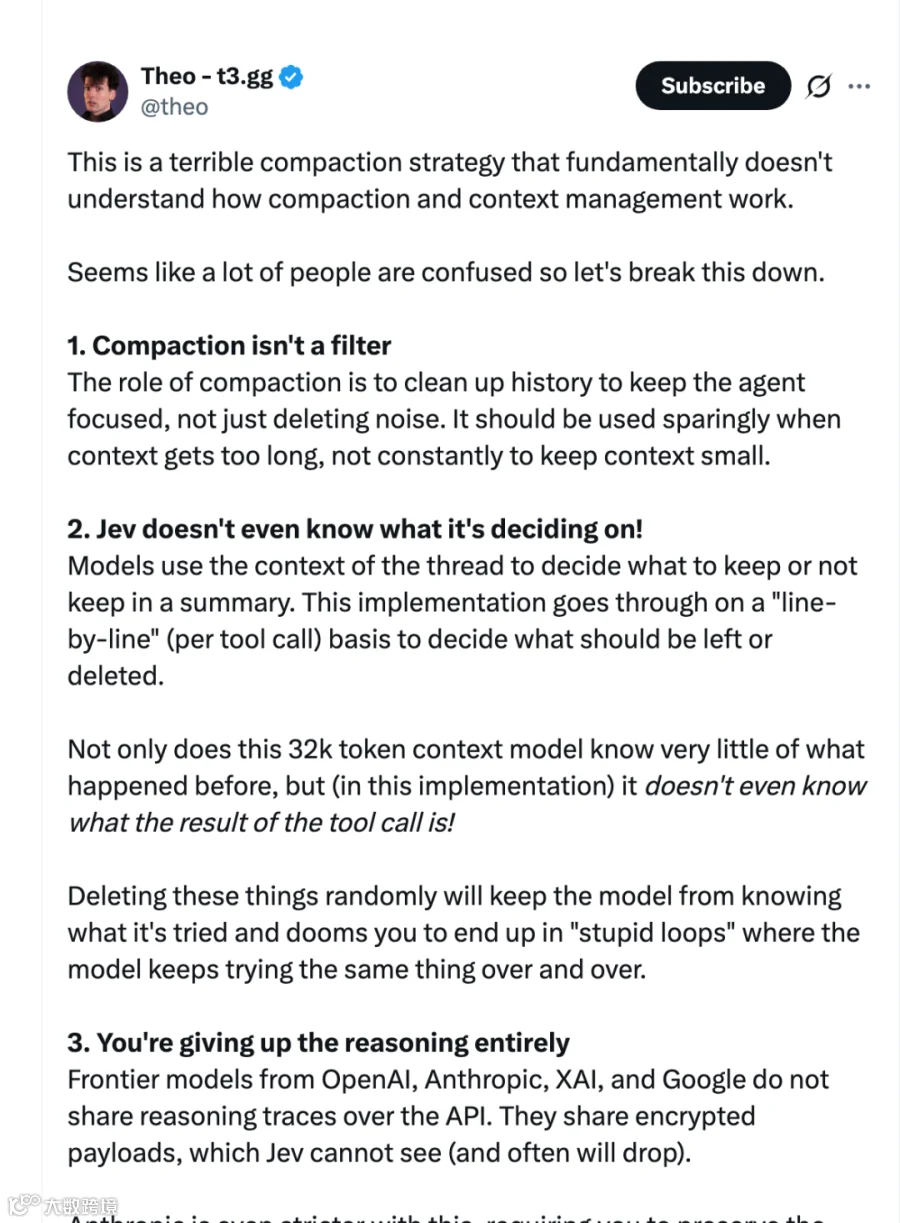

第一,压缩的任务不只是删噪音。 Theo 认为,模型做摘要时会利用整段对话,重新整理当前目标、已经确认的事实、失败路径和下一步动作。fast-jev-compaction 则按单个工具调用逐项决定保留或删除,局部判断可能保住一条“看起来有用”的记录,却丢掉它和前后步骤的关系。
第二,Jev 可能不知道自己在判断什么。 插件要在有限的状态窗口里评估大量记录,因此不会把完整工具结果都交给 Jev。它能看到调用了哪个工具、传了什么参数、结果有多长,却可能只看到 ok, 4213 chars (omitted) 这样的占位信息。Theo 担心,失败原因一旦被删,Agent 就会忘记哪些方案已经试过,随后进入他所说的“stupid loops”:反复执行同一种失败操作。
第三,推理状态也可能一起断掉。 Theo 的说法是,OpenAI、Anthropic、xAI 和 Google 的 API 不会把完整推理轨迹直接交给外部评分器,而是返回加密载荷。Jev 看不到这些内容,却可能删除与它们相邻的历史。对 Anthropic 模型来说,历史序列是否完整还会影响推理数据能否继续复用。这是 Theo 认为它会让 Claude Code “变笨”的原因,不过这是他的判断,不是项目已经完成的基准结论。
第四,删掉 token 不一定更省钱。 提示词缓存依赖历史前缀不变。Theo 用 1,2,3,4,5,6 举例:如果删掉中间的 2,后面的 3,4,5,6 都可能需要重新写入缓存。在他个人使用 Claude Code 和 Codex 的账单里,cache write 曾超过总模型开销的 60%。所以频繁改写历史,可能拿更贵的缓存写入去换更小的上下文。
第五,“删了还能重跑”不是可靠兜底。 项目 README 提到,没保留的内容会永久删除,但 Agent 可以重新运行工具或重读文件。Theo 对这句话的回应只有一句“Good luck with that one”。落到实际操作里,读文件可以重来,写文件、调用外部 API、改变环境状态却未必能无成本复现;而且失败结果本身就是防止重复踩坑的记忆。
评论原文:https://x.com/theo/status/2100762304862384257
回放测试,刚好打中了他的担心
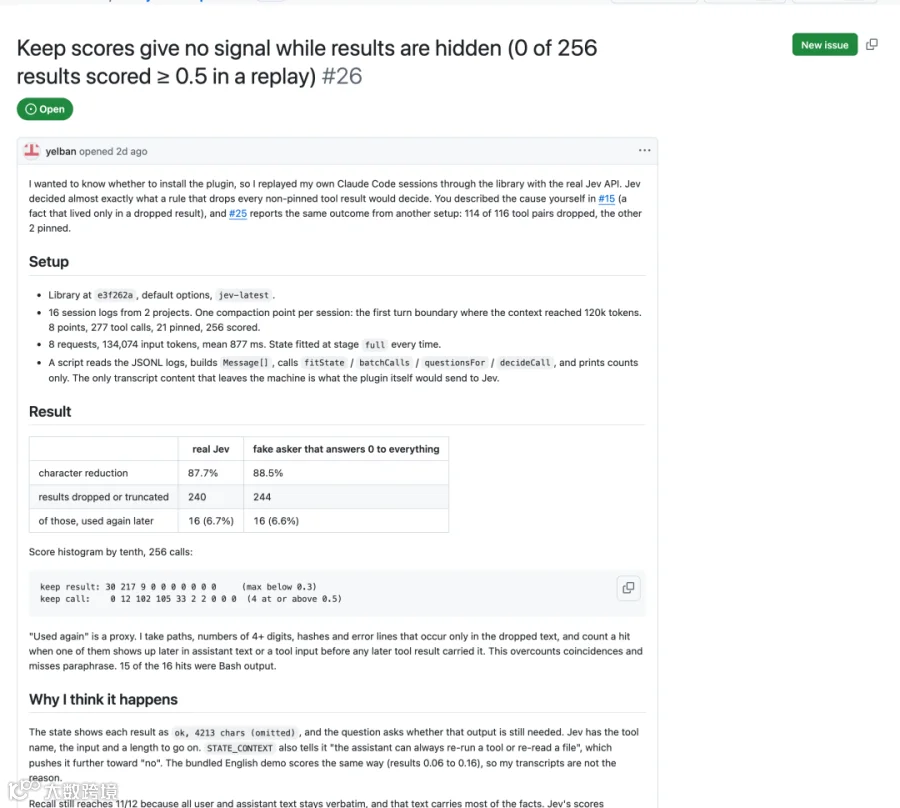
GitHub issue #26 随后给这场方法争论补了一组回放数据:测试者拿 2 个项目的 16 段 Claude Code 会话,在上下文达到 12 万 token 时触发压缩,一共让 Jev 评估 256 个非固定工具调用。
结果有点尴尬:256 个工具结果,没有一个保留分数达到 0.5。 240 个结果被删除或截断,字符数减少 87.7%。而一个永远回答“都不要保留”的假评分器,字符数减少 88.5%,两者几乎一样。
原因藏在实现里。为了把整段历史塞进 Jev 的状态上限,插件不会把完整工具结果发给 Jev,而是把它写成 ok, 4213 chars (omitted) 这样的占位信息。Jev 能看到工具名、输入和长度,却看不到那 4213 个字符里到底有没有关键报错。
另一位开发者公开了一组更激进的对比测试:Jev 删掉了 98.7% 的上下文,但在复杂会话里丢了 7 个关键测试与边界事实中的 6 个。这个结果还不是大规模基准,不过它点中了风险:Agent 忘掉之前为什么失败,很容易重新走一遍老路。
issue 的作者也给了边界说明:样本只来自一个用户、两个项目,而且会话大多是中文;测试只看了单次压缩,没有覆盖连续多轮压缩。所以现在能确定的是“默认策略存在明显盲区”,还不能直接下结论说这种路线一定行不通。
它更像预清理,不是完整压缩的替代品
Anthropic 现在同时提供两类上下文管理:服务端 compaction 会总结早期对话;context editing 则可以清除旧工具结果。fast-jev-compaction 和后者更接近,但它不是按时间一刀切,而是让 Jev 逐项判断保留、截断或删除。
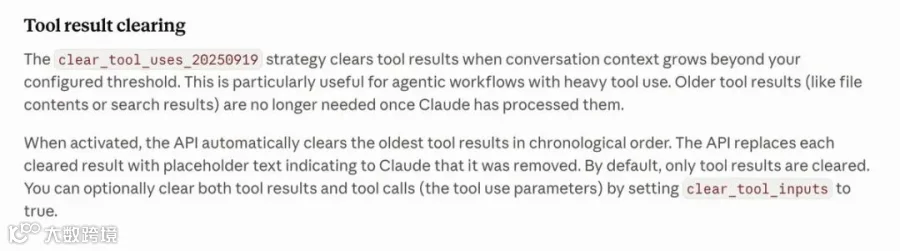
作者 Tamara Tran 也用这一点回应了“它只是在删 tool results”的批评:厂商自己的上下文管理同样会清理工具结果。区别在于,Jev 想把这件事做得更有选择性。
这段回应说明“删除旧工具结果”本身并不是禁区,却没有直接回答两个实现问题:Jev 看不到被删结果的正文,历史中间内容被修改后也可能触发缓存重写。
另一个未解决的问题是递减回报。工具结果越删越少,后面能释放的空间也会减少。长会话最终仍然需要真正的摘要或外部记忆,不能只靠不断过滤旧记录维持下去。
fast-jev-compaction 目前更适合当成“摘要前的预清理”:先删除高置信度噪音,压不动或判断不稳时回退。要把它用于长时间编码任务,至少还要补上三层保护:让 Jev 看见工具结果的关键片段;默认固定失败、编辑和不可重跑的输出;用任务成功率与缓存成本评估效果,而不是只看压缩率。