

在MiniMax H3上加一条帧级delta rule线性分支,Video DeltaNet让14.3秒768p视频的DiT去噪在8×B200上只要6.70秒,质量五项指标不降反升,代码与权重全部开源,24GB单卡也能跑。
视频扩散模型的attention开销一直是大问题。在实测的MiniMax H3负载里,Softmax attention占去噪器runtime的85%以上,稠密注意力让每个query直连全部key,计算量随序列长度二次增长。
线性注意力是语言模型那边已经跑通的路:把远距离上下文压进固定大小的循环状态,代价随token数线性增长。但直接搬到视频上会明显掉画质,因为压缩后的固定大小状态装不下Softmax能保留的全部细粒度交互。
UC Berkeley、Impossible, Inc.与UT Austin的团队提出Video DeltaNet(VDN)(arXiv:2609.20744,2026-09-17提交v1),并在MiniMax H3上实例化为VDN-H3。它不是从头训一个新底座,而是给预训练模型加一条线性注意力分支:近处帧保留精确Softmax,远处上下文交给双向线性记忆,两个分支各自配sigmoid门、RMSNorm和独立输出投影。配合8步蒸馏和与SGLang团队协作优化的推理栈,VDN-H3在8×NVIDIA B200上完成14.3秒768p视频的DiT去噪只要6.70秒,相对同GPU数量的50步稠密H3基线加速14.5倍。
需要注意的一点:这个14.5倍是8卡分布式下的数字。单卡B200上,混合注意力架构本身带来的backbone加速是2.6倍(H200上3.2倍),剩下靠8步蒸馏的6.3倍和8卡并行的7.4倍叠出来。
相关链接
-
论文:https://arxiv.org/abs/2609.20744 -
代码:https://github.com/OpenVDN/vdn-minimax-h3 -
主页:https://openvdn.github.io/ -
模型权重:https://huggingface.co/OpenVDN/vdn-minimax-h3 -
开源协议:代码Apache-2.0;权重遵循MiniMax H3 Community License Agreement
内容介绍
VDN-H3做的是一件事:在不重训底座的前提下,把视频DiT里最贵的注意力换成混合架构,让长视频生成跑得比播放快。
与常见的「换一个更快的注意力kernel」不同,它的核心特点是:
-
分角色处理注意力——近处帧token-to-token精确匹配,远处上下文线性压缩,首尾帧做全局anchor,音频和文本交互完全保留Softmax; -
帧级delta rule——不再逐token更新循环状态,而是让一帧内全部spatial token共同决定新状态,用闭式解耦合同帧内重叠key的写入; -
即插即用——checkpoint只是新增的linear branch加两小段LoRA,推理时可合并进主干,不改动预训练权重;同一份checkpoint支持T2VA、I2VA、FL2VA、L2VA和Ref2VA-like。
适用场景:直播流式视频生成、长视频(345帧/14.4秒)快速出片、需要首尾帧控制的视频编辑。
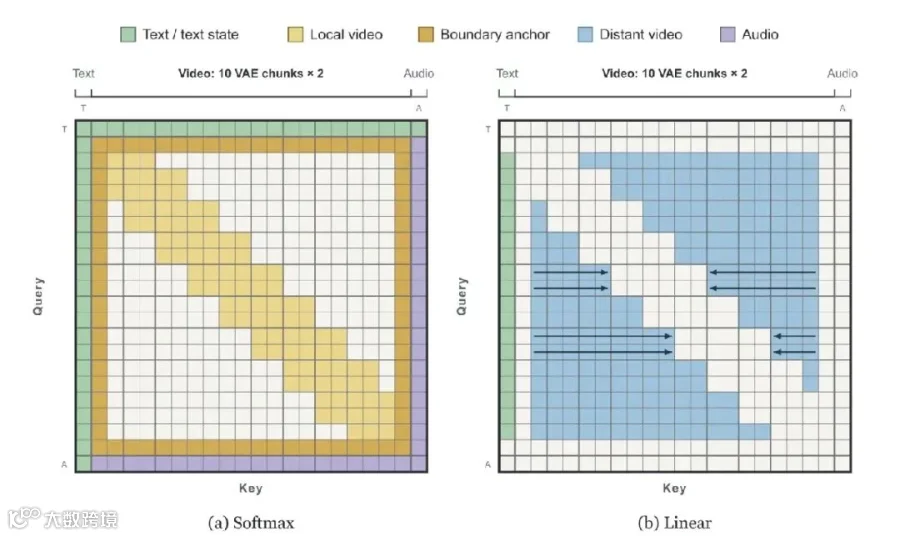 每个query chunk只attend自身与前后各一个VAE chunk,首尾帧做边界anchor,剩余远距离上下文由双向线性记忆承载。
方法概述
一套机制管「哪些交互保留精确匹配」,一套机制管「远距离记忆怎么高效写入」。
1. 分角色的混合注意力分配(Sliding-Window Softmax + Boundary Anchors)
近处帧包含决定纹理、物体边界和短期运动的局部对应关系,这些交互需要直接token-to-token匹配。VDN在双向时间窗口内保留精确Softmax,窗口大小对齐H3的VAE——每5个latent帧合成1个temporal chunk,所以每个query chunk只attend自己和前后各一个chunk,形成15帧窗口。另加两个边界anchor做四向连通:每一帧都attend首尾latent帧的全部token,首尾帧也attend整个序列,这样首尾作为全局参照始终可达,而只有两行两列的token付出稠密代价。文本与audio的交互全部保留Softmax,线性分支只负责剩余的视频上下文。
2. 帧级delta rule(Video Delta Attention, VDA)
标准delta rule一次更新一个token,适配自回归解码;但视频扩散里一整帧的全部spatial token是同时可得的,硬排patch顺序既不自然,也会让相关写入互相干扰。VDA把帧级状态定义成一个联合优化问题的解:第一项让新状态靠近衰减后的旧状态,第二项让同一个状态同时拟合这一帧全部key–value关联。求一次微分得到闭式解S_t = (S̄_t + B_t)(I + A_t)⁻¹,其中A_t汇总key相关性、B_t汇总value–key写入。关键区别在于:batched做法里每个残差都基于旧的S̄_t,重叠key会产生互相冲突的写入;VDA里每个残差都基于共享的新状态S_t,重叠key的内积会同时影响两个有效修正。论文还证明了它的inherited-state transition是非扩张的(‖M_t‖₂≤1),早期帧的贡献不会被后续更新放大——这一点SANA-WM要靠额外的1/√U缩放才能做到。
3. 分支校准与三阶段适配(Staged Architecture Adaptation)
两条分支输出尺度不同,必须分别校准:Softmax分支因概率质量集中在更少key上,配content-dependent sigmoid门;线性分支做RMSNorm后过独立sigmoid输出门,两条分支再各自配独立输出投影后相加。适配分三阶段、预训练权重全程冻结:A1对每层linear branch独立对齐200步(Softmax门固定0.99,逐层梯度裁剪0.1);A2把全部混合层装在一起端到端对齐500步,修正单层训练时看不见的组合误差;Stage B在Q/K/V/O投影上加LoRA,与linear pathway和Softmax门联合训练2000步。之后再做8步蒸馏:用不带GAN项的DMD2目标,student从社区版MiniMax-H3-Turbo-LoRA初始化,对着VDN-H3自己的50步采样器蒸馏,generator、real-score、fake-score共享一个FSDP主干,released checkpoint训练250个generator step。
实验结果
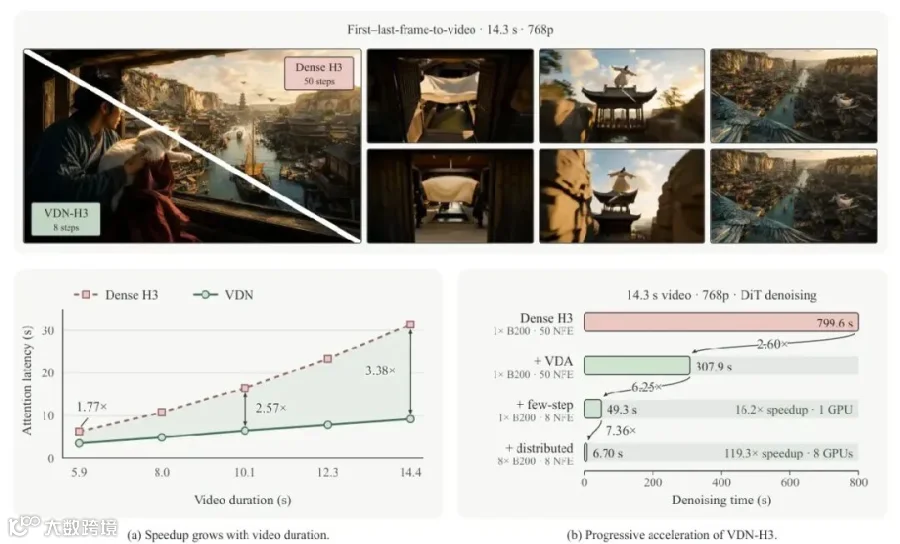
效率阶梯
训练数据为10,015个1344×768、345帧(14.375秒/24fps)的clip。B200上以单卡稠密H3(50 NFE,799.6秒)为基准:
|
|
|
|
|
|
|
|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
6.70s |
|
119.3× |
H200对应数字为1767.3s → 557.9s(3.2×)→ 89.3s(19.8×)→ 12.5s(141.6×)。
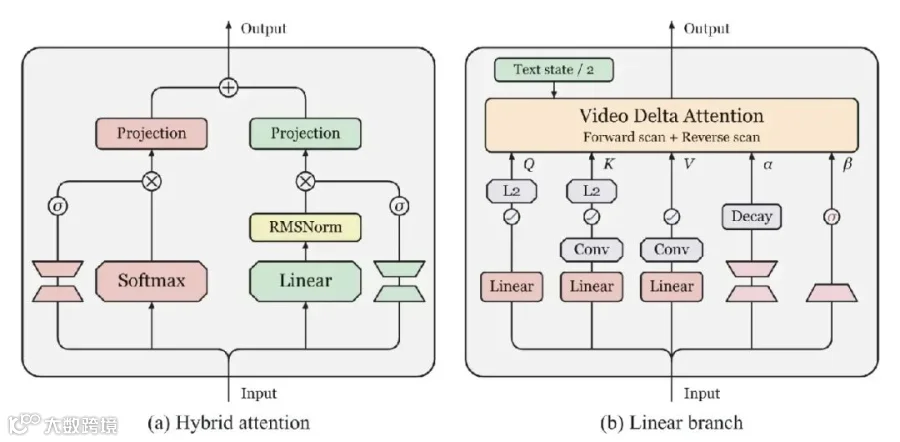
左为Softmax与Linear双分支的门控与独立投影结构,右为Video Delta Attention的前向加反向扫描。
backbone加速随序列长度增长:latent帧从42到102,Softmax注意力密度从42.08%降到19.98%,端到端加速从1.8×升到3.2×(H200)。MXFP8下8步去噪在B200上1/2/4/8卡分别为47.6、25.9、13.1、6.9秒,8卡端到端约9.0秒出14.4秒视频。
质量
8步VDN-H3在5个无参考质量指标上与50步Dense H3持平或略高(差距+0.06到+1.00),FastH3则全面落后2.70到12.74。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
28.03 |
|
|
|
|
89.20 |
|
|
|
|
93.13 |
|
|
|
|
83.41 |
|
|
|
|
3.28 |
|
|
|
|
11.71 |
|
|
2.25 |
|
|
|
|
|
|
4.45 |
|
|
1.84 |
|
|
|
|
28.85 |
|
|
|
|
0.833 |
|
|
|
|
0.104 |
|
|
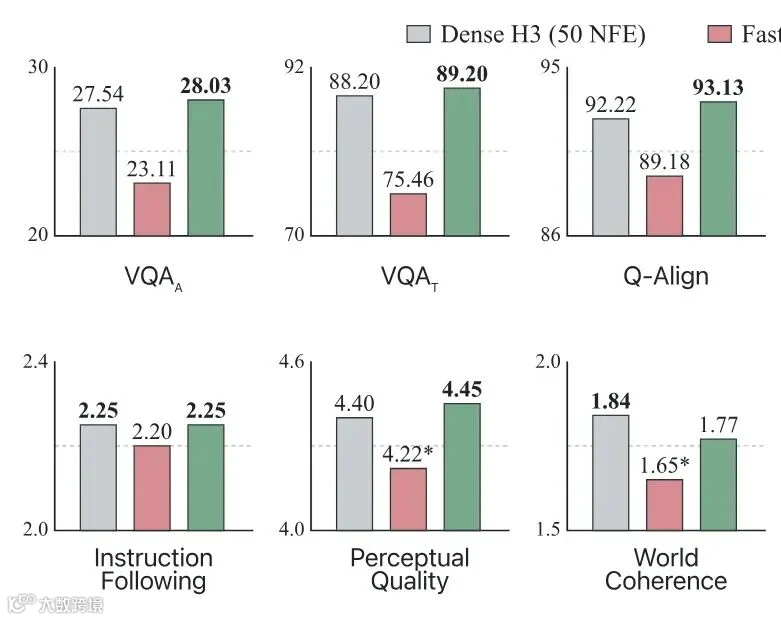 VDN-H3在VQA_A、VQA_T、Q-Align、FAST-VQA、DOVER++上均为最高,RAFT运动幅度11.71像素也高于Dense H3的11.55。
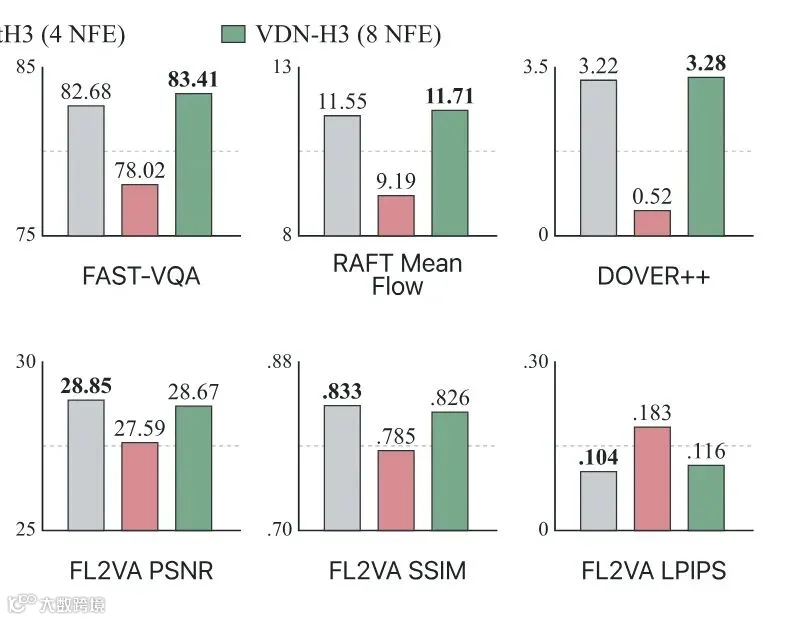 VDN-H3的World Coherence 1.77略低于Dense H3的1.84,FL2VA端点保真度也有小幅差距。
消融
在102个latent帧下测核心算子:VDA-Prep从18.0ms降到1.6ms(H200),VDA-Gather加速7.2×/7.5×,VDA-Epilogue加速7.3×/9.1×,小矩阵求逆用fused Gauss–Jordan替代多kernel Cholesky路径带来4.6–5.0×加速。一个反向数据点:Window Softmax在B200上从69.5ms降到56.1ms,但在H200上几乎没有变化(112.6对112.1ms),说明这套kernel优化对不同代GPU的收益并不均匀。
局限与未来方向
首先,头条的14.5倍要拆开看。相对8卡稠密基线是14.5×,相对单卡稠密基线的累计加速是119.3×,而架构本身只贡献2.6×(B200)/3.2×(H200)。单卡用户实际能拿到的是2.6××6.3×≈16.2×(49.3秒),离「跑得比播放快」还差一个分布式集群。
其次,画质不是无损。World Coherence从1.84降到1.77,FL2VA端点保真度三项全部略差(PSNR -0.18dB、SSIM -0.007、LPIPS +0.011)。对首尾帧一致性敏感的工作流需要单独评估。
第三,规模与评测面都偏小。训练集10,015个clip,评测用固定的第三方103个prompt集合;anchor和窗口设计是按H3的VAE chunk结构定制的,换一个VAE帧分组就要重新对齐窗口边界。
此外,这套方法依托于一个已有强底座。VDN没有训练新基础模型,它是在MiniMax H3上做适配,如果底座本身不开放,整套配方就无法迁移。团队来自UC Berkeley、Impossible, Inc.与UT Austin,不是中国团队,但底座MiniMax H3是国产开源模型,国内读者可以直接在自己部署的H3上复用这条路线。
结论
VDN-H3验证的是一件工程上很具体的事:给预训练视频DiT加一条帧级delta rule的线性分支,配上分阶段的teacher alignment和8步蒸馏,可以把14.3秒768p视频的去噪压进个位数秒,而五项无参考质量指标不降反升。
对于做视频推理优化的工程师,这套配方里最可复用的不是某个kernel,而是「分阶段对齐 + 容量匹配的LoRA + 对齐自己的50步采样器再蒸馏」这条流水线,仓库把训练代码和推理栈一起开源了;对于内容创作者和独立开发者,更实际的入口是diffusers的ModularPipeline接口,24GB显存开block级offload跑345帧峰值约22GB、fp8下约20GB,RTX 3090/4090这一档就能出片,只是拿不到8卡的那6.70秒。风险提示必须说清楚:代码是Apache-2.0,但权重继承MiniMax H3 Community License Agreement,商用条款以MiniMax的协议为准,不要把代码协议当成权重协议。
视频生成的效率竞赛正在从「换更快的kernel」转向「换更合理的注意力结构」,VDN-H3给出的是其中一个答案:不是把Softmax整个扔掉,而是让它只出现在真正需要精确匹配的地方。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~
