

大模型行业长期有一个既定共识:Decoder-only 架构,也就是 GPT 路线,是绝对的主流。
从文本创作、多轮对话到代码生成,几乎所有通用大模型都扎堆走自回归生成路线,而曾经火爆一时、以 BERT 为代表的 Encoder 架构,渐渐淡出了主流视野,沦为“传统理解模型”。
但随着 AI Agent 时代全面到来,这套稳固的范式正在被悄悄颠覆。
被搁置多年的 Encoder 路线,正在迎来最强复苏窗口。它的回归不是复古,而是为 Agent 时代的全新工作负载,补上 Decoder 架构天生的短板。
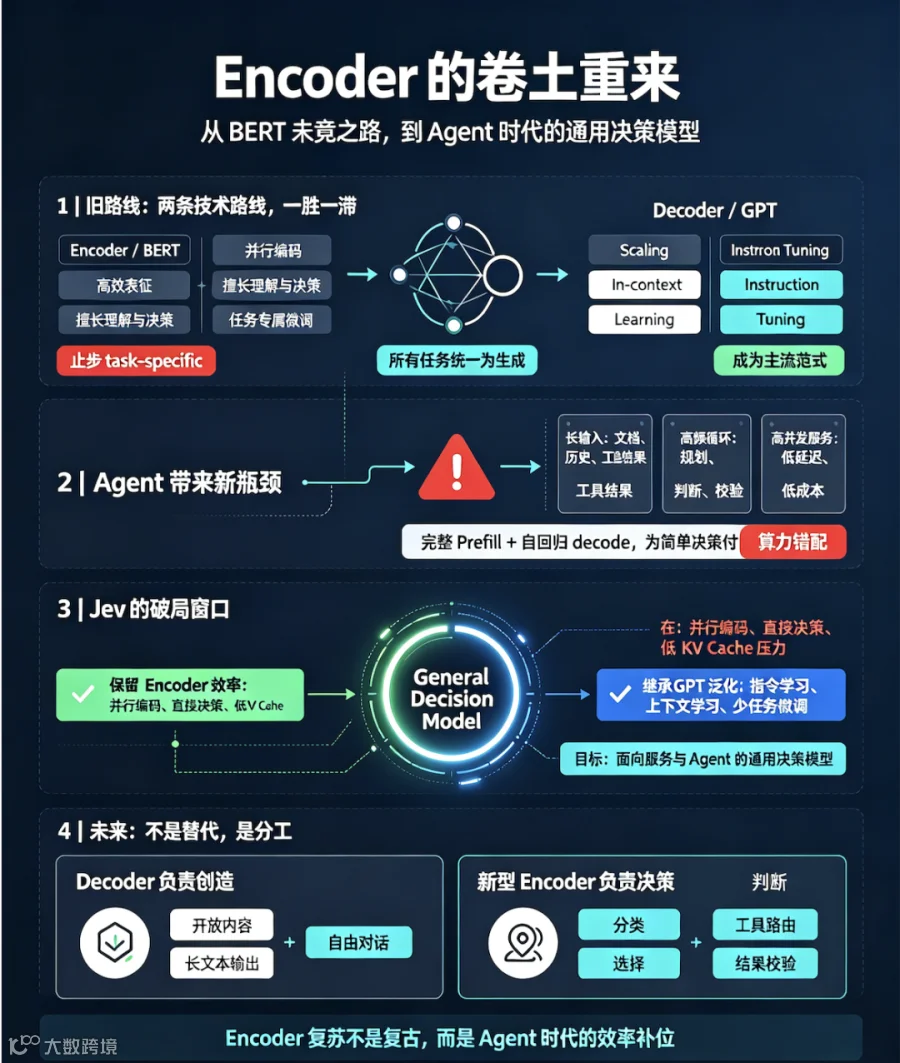
01 两条路线的宿命:BERT 搁浅,GPT 一统天下
回溯大模型发展早期,其实有两条潜力十足的技术路线。
以 BERT 为核心的 Encoder 路线,本质上是极致的「输入理解与表征压缩」。
它可以并行读取全部输入文本,一次性把海量信息压缩成高质量的语义表征,擅长理解、分类、判断、匹配,计算效率极高。
但这条路线最终止步于「任务专属微调时代」。
BERT 没有通用能力,想要做情感分析、意图识别、文本匹配、内容分类,每一个任务都必须单独微调模型、适配权重,无法开箱即用,更没有统一的任务交互方式。
简单来说:够高效,但不够通用。
而 GPT 代表的 Decoder 路线,早期同样需要任务微调,却走出了完全不同的进化路径。
依靠模型规模缩放、上下文学习、指令微调三大核心迭代,GPT 彻底摆脱了单任务局限,实现了全方位的任务泛化。
它开创了一个全新范式:把所有自然语言任务,统一成文本生成任务。
分类、逻辑判断、语义推理、工具调用、内容创作……无论是什么场景,全部转化为自回归 Token 生成。自然语言,从此成为 AI 的通用任务交互界面。
自此,Decoder-only 彻底统治了大模型行业。
但代价也随之而来:Encoder 架构的进化被彻底中断,通用表征模型、通用决策分类模型的探索,停滞了整整数年。
02 Agent 时代到来,Decoder 的昂贵短板彻底暴露
在纯对话、纯生成场景下,Decoder 架构几乎无可替代。
但 AI Agent 的普及,彻底改变了大模型的核心工作负载,让 Decoder 的天生缺陷被无限放大。
不同于传统单次对话、单次生成任务,Agent 的核心运行逻辑是长上下文 + 高频循环 + 频繁决策:
1. 输入上下文越来越长,需要持续读取文档、对话历史、工具返回数据;
2. 反复 Prefill 带来巨大的 KV Cache 开销,显存占用居高不下;
3. 多轮思考、工具调用、结果校验,需要模型高频循环调用、快速做出判断。
而 Decoder-only 架构的运行逻辑极其“笨重”。
哪怕 Agent 只需要做一个简单的二选一、分类、对错判断、意图识别,它也必须完整 Prefill 全部长输入,再逐 Token 自回归生成寥寥数词的结果。
用全套生成式算力,只换一次简单决策。
这种算力浪费、效率损耗,在高并发、高频迭代的 Agent 服务场景中,变得无法忍受。行业急需一套更高效的解决方案,承接 Agent 的海量决策类任务。
03 Encoder 卷土重来:Jev 补齐大模型的最后一块拼图
当 Decoder 的泛化能力遇到 Agent 效率瓶颈,沉寂多年的 Encoder 路线,终于迎来了属于它的时代窗口。
Jev 模型的出现,正是为了完成 BERT 当年未走完的技术之路,融合两大架构的核心优势,补齐行业空白。
它跳出了传统 Encoder 和 Decoder 的二元对立,打造出面向服务、面向 Agent 的通用决策模型。
一方面,它彻底解决了老式 BERT 的致命短板。
摒弃了传统 Encoder「一任务一微调」的老旧模式,继承 GPT 的指令泛化、上下文学习能力,实现零微调通用任务适配,真正做到一个模型搞定所有决策类任务。
另一方面,它重拾 Encoder 架构的极致效率优势。
无需自回归逐 Token 生成,依靠全局并行编码+决策输出的模式,不用冗余算力,不用高额 KV Cache 开销,专门适配 Agent 的高频判断、快速决策、长文本理解场景。
04 快慢系统对比:Agent 时代的「快慢双引擎」分工
AI Agent 频繁循环、反复决策、高频调用的运行特性,让大模型形成了一套天然的快慢双系统运行逻辑。
过去行业依赖单一 Decoder 模型包揽所有任务,本质是「用慢系统干所有活」,算力冗余严重、响应效率滞后。而 Jev 代表的新型 Encoder 架构落地,正式补齐了大模型的快系统,形成快慢协同的最优架构。
一、慢系统:Decoder(GPT 类生成模型)
Decoder 是大模型的思考与创作慢系统,主打深度、泛化、开放式能力,也是过去几年行业的唯一主流。
核心特质:串行自回归、重算力、慢输出、强泛化
它的工作逻辑是逐 Token 串行生成,每输出一个字都需要依赖前文结果,同时需要对超长上下文做完整 Prefill、持续更新 KV Cache。这种天生的串行机制,决定了它擅长深度创作,不擅长高频判断。
适配场景(慢任务、重创作、弱频次):
开放式文本创作、文案撰写、长内容输出
复杂逻辑推理、深度问题拆解、多步骤推演
自由对话、创意生成、复杂代码编写
核心短板:面对简单判断、分类、筛选等轻量化任务,依然要走完完整编码+生成流程,算力浪费极大,延迟高、成本高,完全不适配 Agent 高频循环的工作负载。
二、快系统:新型 Encoder(Jev 通用决策模型)
新型 Encoder 是适配 Agent 时代的决策与判断快系统,承接传统 BERT 的高效特性,同时补齐通用能力,专门解决「简单任务重算力」的行业痛点。
核心特质:全局并行、轻算力、快决策、高效率
摒弃自回归串行生成,一次性并行编码全部输入,直接输出决策结果,无需逐字生成、无需反复刷新 KV Cache。相较于 Decoder,同等输入下决策速度提升数十倍,显存开销大幅降低。
同时它彻底摆脱老式 BERT「一任务一微调」的缺陷,继承 GPT 指令泛化能力,成为通用快系统,而非专用模型。
适配场景(快任务、高并发、高频次):
Agent 核心决策:工具选择、任务规划、结果校验
文本处理:意图识别、内容分类、语义匹配、优劣判断
高并发服务:批量筛查、内容过滤、快速正误判定
三、快慢系统核心对比
1. 运行逻辑差异
慢系统(Decoder):先完整读完全文,再逐字「挤牙膏式」生成结果,重过程、重推演。
快系统(Encoder/Jev):全局并行扫描全文,一步直达决策结果,无冗余过程、无无效算力消耗。
2. 能力侧重差异
慢系统:胜在泛化创造,能应对未知复杂任务、开放式创作。
快系统:胜在高效精准,能承接标准化、高频次决策任务。
3. 落地价值差异
单一慢系统:Agent 运行成本居高不下,高并发场景难以落地,算力利用率极低。
快慢双系统协同:慢系统做创作思考,快系统做判断执行,算力精准匹配场景,大幅降低 Agent 落地成本,是产业规模化的关键解法。
05 不是替代,是补位:大模型进入分工时代
Jev 代表的全新 Encoder 路线,并非要取代 Decoder 生成式大模型,而是终结「Decoder 包打天下」的单一范式。
未来的 AI 架构,终将形成清晰的分工:
Decoder 模型负责「创造」:开放式内容生成、自由对话、创意创作、长文本输出,发挥泛化生成的核心价值。
新型 Encoder 模型负责「决策」:Agent 规划、工具选择、结果校验、内容分类、意图判断、语义匹配,用极致效率承接高频、高并发、低延迟的决策任务。
从 BERT 的低效专用,到 Jev 的高效通用,Encoder 的卷土重来,本质是大模型从「单一生成范式」走向「生成+决策双范式协同」的行业进化。
这不是技术复古,而是 AI Agent 时代,最贴合产业落地的技术迭代。
Jev 代表的全新 Encoder 路线,并非要取代 Decoder 生成式大模型,而是终结「Decoder 包打天下」的单一范式。
未来的 AI 架构,终将形成清晰的分工:
Decoder 模型负责「创造」:开放式内容生成、自由对话、创意创作、长文本输出,发挥泛化生成的核心价值。
新型 Encoder 模型负责「决策」:Agent 规划、工具选择、结果校验、内容分类、意图判断、语义匹配,用极致效率承接高频、高并发、低延迟的决策任务。
从 BERT 的低效专用,到 Jev 的高效通用,Encoder 的卷土重来,本质是大模型从「单一生成范式」走向「生成+决策双范式协同」的行业进化。
这不是技术复古,而是 AI Agent 时代,最贴合产业落地的技术迭代。