

最近国产模型更新得太快,大家都感觉到被轮番轰炸。
Kimi K3、GLM 5.3 强势进入第一梯队,DeepSeek 刚创造的斩杀线又被别家夺走了。
当然,国内 AI 玩家也不止这几家。
一向低调的阶跃星辰在节前炸出 Step 5 Preview,我提前几天参与了内测,体验完发现这玩意有点猛。
先说说它是个什么样的模型?
先看几个重点参数。总参数 600B、每个 Token 激活 27B:总参数更像模型容量,激活参数更接近单次推理实际动用的计算规模。
它支持 1M tokens 上下文,适合一次放入更长的财报和项目材料;同时支持视觉输入,可以直接读图、截图和页面。
官方重点展示了三类能力:Coding、Agent 和专业知识工作。
Coding 关注真实软件工程与长程调试;Agent 关注持续调用工具、管理中间结果和推进多步任务;专业工作则强调资料核对、分析和最终交付。
现在的旗舰模型动辄以 T 计参数,Qwen3.8-Max 是 2.4T,Kimi K3 是 2.8T。
这样看,Step 5 Preview 甚至可以说是个小模型。那么这么一个“小模型”能和那些巨无霸 PK 吗?
先看第三方数据。
Artificial Analysis(AA)的综合智能指标(Intelligence Index)给 Step 5 Preview 打了44 分,已经杀入全球开源模型前三。
这个分数打平了 Kimi K3(max),但它的总参数差不多只有 K3 的五分之一啊,这不得不说有点狠了。

▲ 图:AA 智能榜单,Step 5 Preview 得分 44。
今年大家开始听到模型“斩杀线”这个词了,说明相比模型能力,大家其实更关注最终的性价比。
那么这个 Step 5 Preview 在性价比方面能打吗?
AA 估算,Step 5 Preview 完成一项智能任务平均花0.71 美元。
Kimi K3(max)和 GLM-5.3(max)约为 2 美元,Claude Opus 5(max)约为 5.86 美元。
按这张图的口径,它的单任务成本约为前两者的35%、后者的八分之一。
这么看,这玩意还真有点新“斩杀线”的意思。至于会不会有 Flash 版,还得等官方消息。

▲ 图:AA 智能与成本对比。
虽然低调,但是另一张图还是可以让我们看到阶跃这几个月的变化。
Step 3.7 Flash 是今年 5 月推出的,图上的19 分带斜纹,属于估算值;这次 Step 5 Preview 的44 分是已评测结果。
从 3.7 Flash 到现在的 Preview,不到四个月,模型的综合位置确实往前迈了一大步。
我把软件工程、终端操作、职业任务、办公文档和金融研究这五项评测放在一张图里,方便横向比较 Step 5 Preview 与其他模型的表现。

▲ 图:五项能力评测。
我更留意两项贴近专业交付的成绩:DeepSWE v1.1 得分 67.7%,略高于 Kimi K3 和 GLM-5.3;FrontierFinance 得分 66.4%,高于图中的 GPT-6 Astra、GLM-5.3 和 Kimi K3。
一个看真实软件工程,一个看投资研究,也正好贴近我接下来要用财报任务验证的能力。

▲ 图:5 月的估算值与这次实测值。
Step 3.7 Flash(5 月,估算 19)→ Step 5 Preview(9 月,实测 44)
跑分归跑分,我真正关心的还是实际干活怎么样,能不能经得起测。
这里我把 Step 5 Preview 接进 WorkBuddy 做测试;界面里的water18-0910是它的调用标识。
任务是分析英伟达最新一季财报。我给它 10-Q、9 页 CFO Commentary、17 页业绩演示和 16 页电话会记录。
四份材料不是简单相加:历史数据、非 GAAP 调整、管理层指引和我让它做的情景分析,口径不能混;报告、Excel、图表和 PPT 还得用同一套数字。
提示词没有要求它写几句摘要就结束。关键几句是:
说实话,这个任务不仅真实,甚至有点艰巨。面对这样一个复杂的工作,这个模型表现如何?
它先定工作顺序,再读取四份材料。
它也很好地遵循了指令:没有直接抄表写报告,而是拿 10-Q 的披露数字,去对 CFO 解释和电话会表述。
遇到重新列示、GAAP 与非 GAAP 的差异,也先把口径理清。
如果换我来做,最容易急着把数字填进表里,这一步反而可能漏掉。

▲ 图:交叉核对四份财报材料。
材料对齐后,它建了一份带来源的 Excel 底稿,把历史业绩、管理层指引和自己的假设分开。
有趣的是,第一次生成有错。
独立校验时,它查出非 GAAP 调节表的符号、季度自由现金流公式、敏感性矩阵括号和股东回报口径四处问题,回到文件里逐项修正,再重新计算。

▲ 图:发现并修正四处问题。
▲ 视频:Excel 公式复核与修正。
能自己纠错,这个能力不亚于吭哧吭哧干活。
实际上,这样一个复杂的任务要用到不少本地工具,而这些工具可能还没安装,或者装起来会遇到问题。
接下来做可视化,它就遇到了这种问题。绘图依赖的安装中断,它先检查现有的 Python 环境,再尝试继续安装和生成图表。
这里耽误的时间,既有工具环境的因素,也有模型判断、切换方法的成本,不能全算成“思考慢”。
这里让我感觉它确实会自己想办法。中间我打开过权限,但具体怎么排查、怎么换路子,基本不用我一步步指挥。
工具通了之后,它陆续做出四张分析图、HTML 报告和 PPT。产出文件也不是终点:它对 Excel 做了52 项独立重算和 10 项输入联动检查,又检查报告的脚本和渲染、PPT 的排版与文件结构。
相比于把交付物一次性直接吐给我,这里它做得特别好,会自己先检测、测试、修正后再给我。
PPT 检查一度显示“图片数为 0”,它继续查到实际嵌入目录,才排除这次误报。
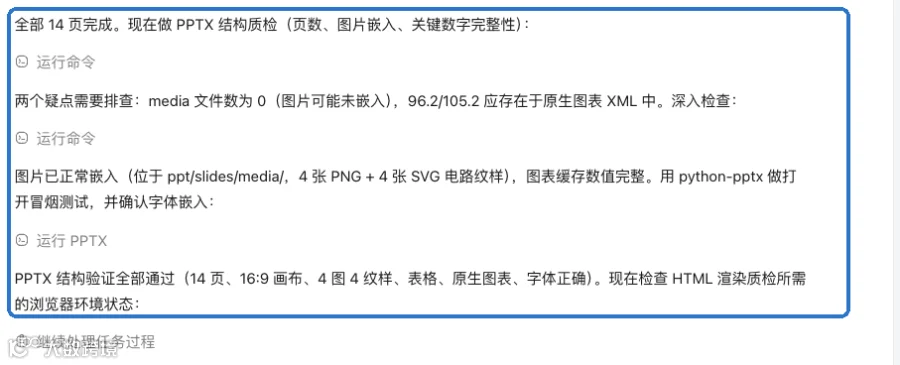
▲ 图:复核 PPT 图表。
整个任务从 15:54 到 17:22,约88 分钟。其中浏览器组件的下载一度卡了 20 多分钟,依赖安装也曾中断。
88 分钟是一个很长的时间,当然 WorkBuddy 环境的限制也耽误了不少。
但这反而让我对这个模型刮目相看,一个这么长程的任务,居然没跑崩,也着实不容易。
等了很久,交付物终于出来了。一口气给我一份详尽的 8 章 HTML 报告、5 张表的可编辑 Excel、4 张单独的分析图,以及14 页 PPT。
相比很多 Agent 的交付物,Step 5 Preview 给我最深的感受是三个词:详尽、专业、好看。
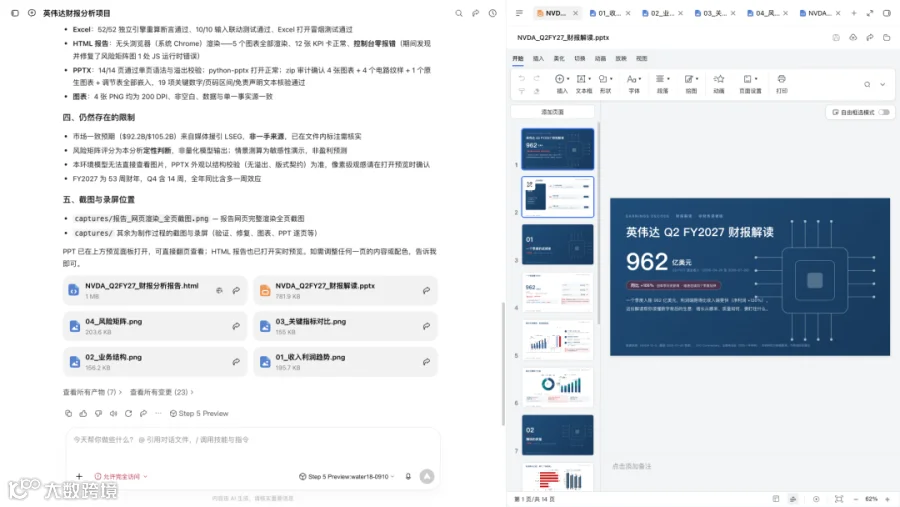
▲ 图:报告、Excel、图表与 PPT。
HTML 报告分了八章,从业绩、收入结构,一直写到利润口径、现金流、下一季指引和风险。我点开看,里面还有五张可以交互的图,不是把数字堆成一页。
收入图把近六个季度的营收、营业利润和毛利率放在一起;其他图继续拆市场平台、利润率和不同情景。关键数字旁边留了来源,我想追一个结论,还能往回查。
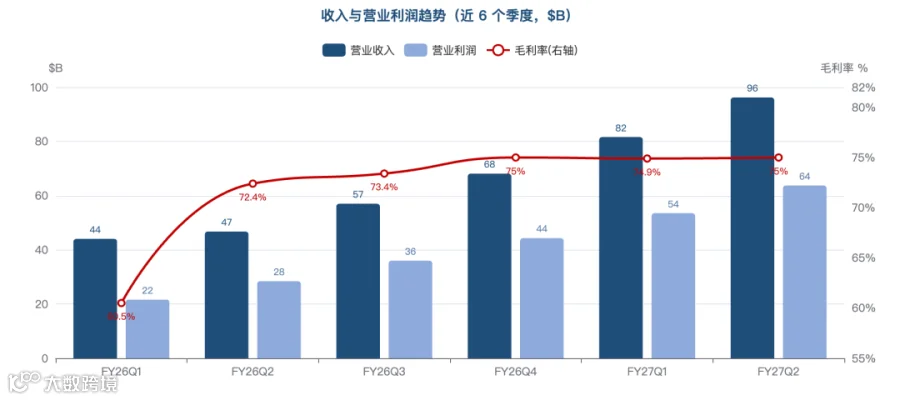
▲ 图:近六季收入与利润。
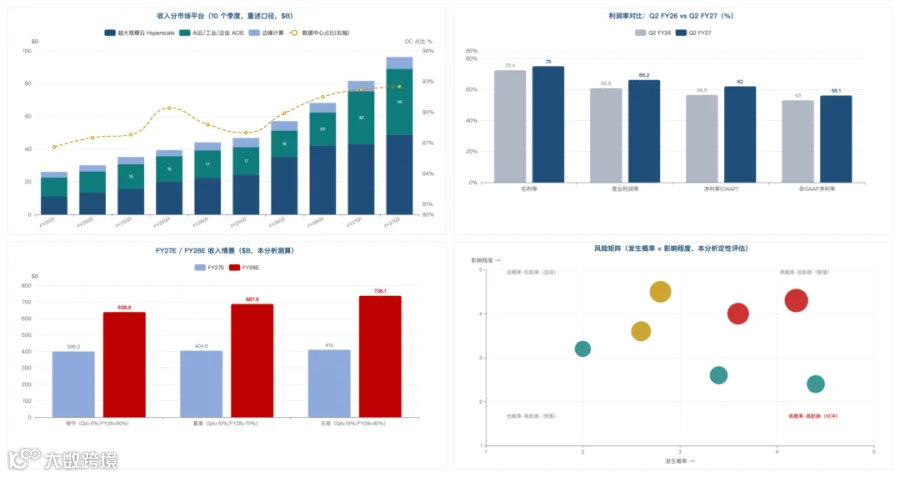
▲ 图:报告里的四张分析图。
报告里还有一张利润口径调节表,我觉得比再看一张增长图更有用。
这个季度的 GAAP 净利润是 596.88 亿美元,非 GAAP 净利润是 539.54 亿美元;中间有 77.71 亿美元股权证券收益,属于非现金项目。只看净利润同比大涨,很容易漏掉这层区别。
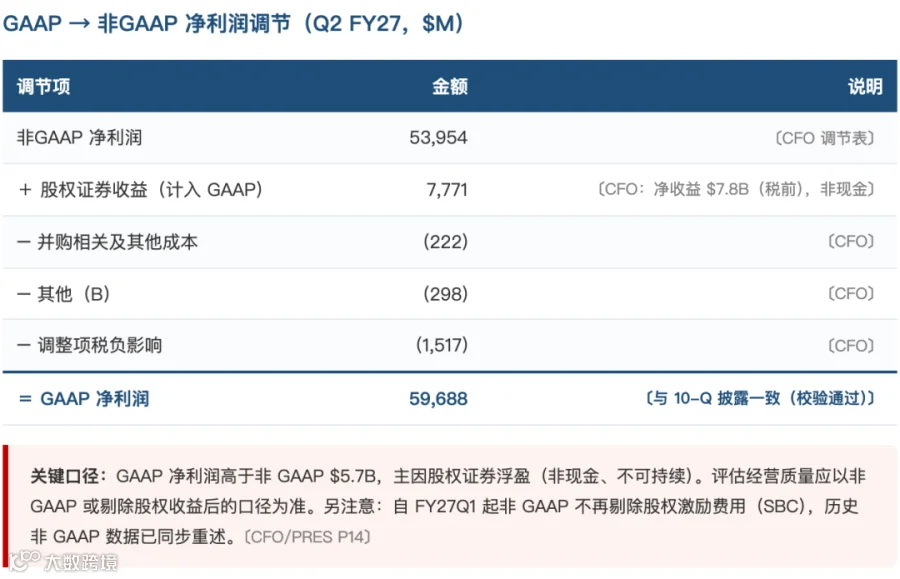
▲ 图:报告拆解 GAAP 与非 GAAP 净利润的差异。
Excel 更能看出它有没有把分析做实。
我点开原文件,一共五张表:经营看板汇总收入、利润和现金流;历史数据排了六个季度,数字旁边还写着来源;业务结构继续往下拆。
情景分析把管理层指引和它自己的假设分开,12 个黄色输入可以改。最后一张“口径与来源”,专门交代非 GAAP、分部重述、自由现金流这些容易算错的地方。这份底稿我能接着改,也能顺着来源回查。
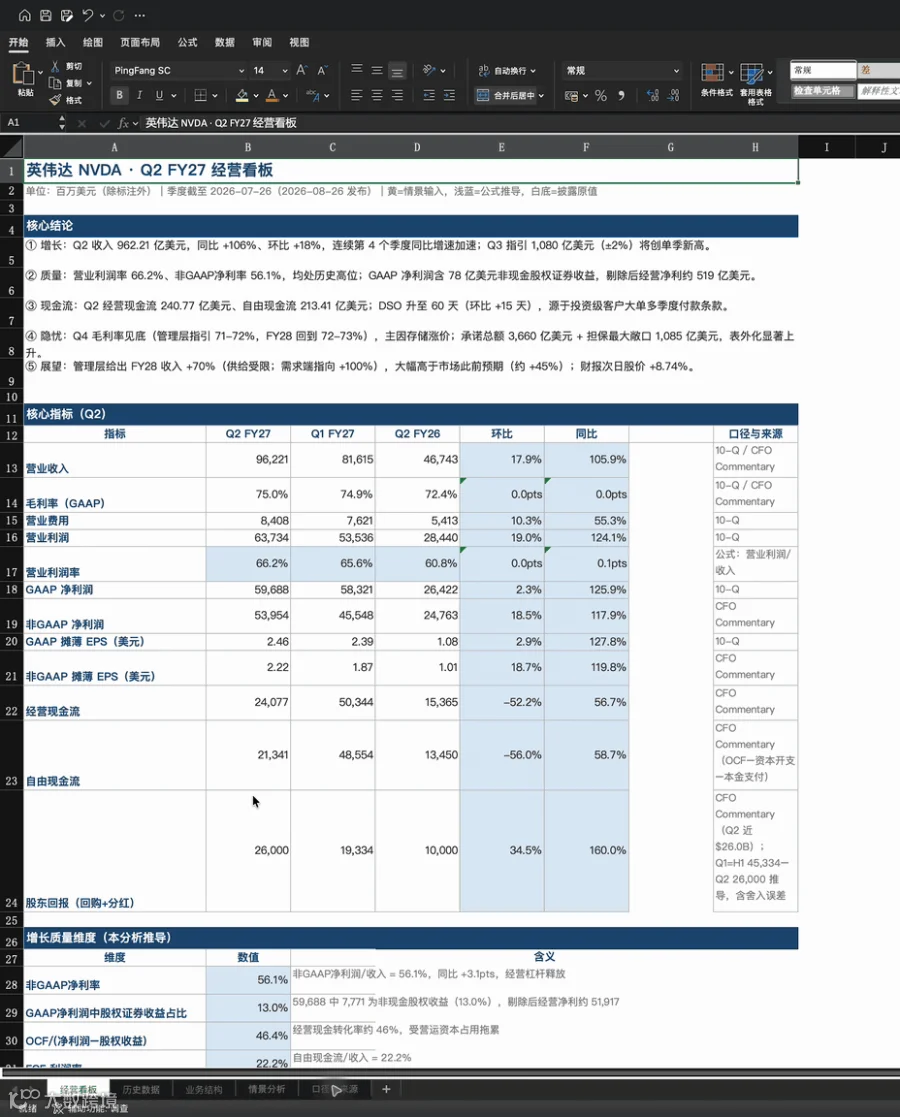
▲ 图:Excel 原文件的五张工作表。
PPT 也让我意外,相比很多 AI 做出来的“班味”PPT,这里的还真的让我眼前一亮。
就像一份很专业的自制 PPT,它的逻辑很清晰,而且整体审美,我真的觉得很专业又美观、而且主要是还不花哨。

▲ 图:PPT 逐页生成与检查。
相比那些一堆文字的 PPT,这里真的做到了图文并茂,而且把核心内容都提炼出来了。比如,第 4 页展示一个季度赚了多少钱,这可能是很多人最关心的话题。

▲ 图:PPT 第 4 页,一个季度赚了多少。
还有关于增长:它为什么会增长?第 5、6 页连续用图和图表来展现,非常好。

▲ 图:PPT 第 5、6 页。
还有那一页,要盯的三件事。以及最后那页的判断,我觉得非常到位。所以整份 PPT 我觉得完全可以一字不改拿去讲。

▲ 图:PPT 风险页与结尾页。
下面是全部 14 页,能更直观看到整套 PPT 的节奏。
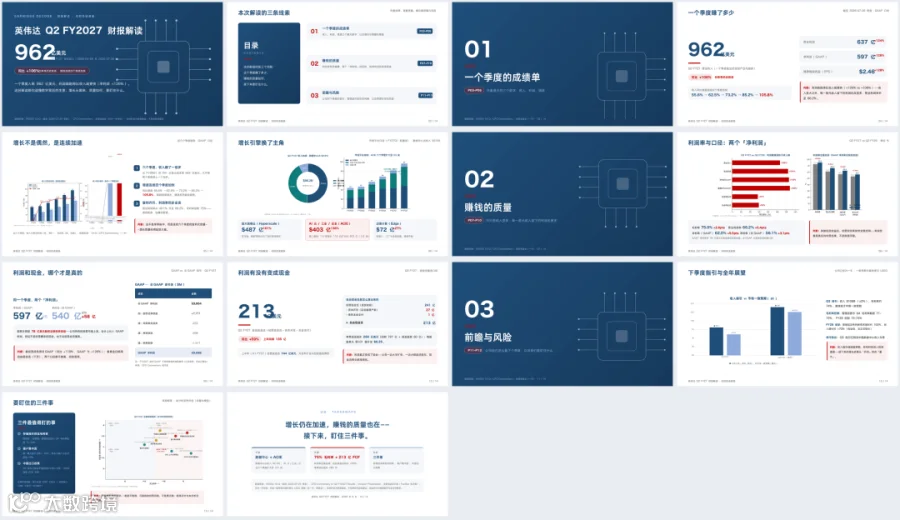
▲ 图:14 页 PPT 缩览。
我也把成品里的主要数字重新对了一遍。营收、利润、现金流和几个关键业务数据,都能与英伟达的原始材料对上。
当然,少数口径和图表细节可能还需要在正式使用前核稿,但没有出现“整套报告看着漂亮,核心数据却是错的”那种情况。
金融方向还有一项可作参照的FrontierFinance。它用投资研究场景中的专家问题,评估检索、分析和结论。
Step 5 Preview 在图中的五款模型中排第二,仅低于 Claude Opus 5;比 GLM-5.3 和 Kimi K3 分别高 2.3、3.8 个百分点。这是公开评测,不是我这次财报任务的评分。
现在行业里天天谈参数、强化学习、Agent 能力和价格。
对我来说,真正有用的还是它能不能在真实场景里干活,并能自主地把一件活从头到尾干完,不需要我太多干预。
在我这几轮测试中,我可以比较肯定一点:Step 5 Preview 确实做到了这一点。
这次让我印象最深的,是它能把核对数据、搭 Excel 底稿、写报告、做图和检查成品接成一条线。中间有工具装不上,也有公式算错,但它没有把半成品交给我,而是继续找原因、修完再交。
这还只是一轮财报分析,不能说明它做所有任务都一样稳。但至少面对这件足够复杂的工作,我看到的已经不只是一个会回答问题的模型,而是一个能自己把工作往前推、最后拿出完整成品的 Agent。
官方对金融能力的评价重点,也不只是答案是否正确,还包括来源能否追溯、事实和假设能否分开、关键计算能否复现。这个标准,正好也是我这次测试最在意的地方。
这次测试前后花了 88 分钟,看到它能持续推进、遇到问题再修,我对它做长程任务的能力印象很深。官方披露的另一个案例,时间尺度还要长得多。
官方还披露了一个长程任务案例:Step 5 Preview 在一张 NVIDIA H100 上连续 24 小时优化 MLA GPU Kernel,约 22 小时后达到 508 TFLOPS。
这个案例说明它能根据运行结果持续改代码,但和本文的财报交付测试不同,不能直接当成同一项成绩。
Step 5 Preview 已可通过阶跃星辰的产品和 API 使用,计划于 10 月 15 日正式开源。
想了解模型、在线体验,或接入自己的 Agent 和工作流,可以按用途选择入口:
Model Blog:https://www.stepfun.com/step-5-preview
国内开放平台 API 接入:https://platform.stepfun.com/
Studio 在线体验:https://studio.stepfun.com/
能力和价格放在一起看更直观。
模型规格与 AA 实测数据参照 Artificial Analysis;下表人民币 API 价格来自国内开放平台,实际费用以所用平台结算为准。
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
01|阶跃星辰:Step 5 Preview 官方介绍
https://www.stepfun.com/step-5-preview
02|阶跃星辰开放平台:定价与限速
https://platform.stepfun.com/docs/zh/guides/pricing/details.md
03|Artificial Analysis:Step 5 Preview 模型页
https://artificialanalysis.ai/models/step-5