

智猩猩AI整理
编辑:金水
9月14日,由北航、曼彻斯特大学、IQuest Research 等机构的研究者,提出了 Agent Harness 自改进框架 ModularRSI。论文发布后在9月16日登上了Hugging face日榜第二。
这套框架没去堆更大的模型,而是让智能体的执行外壳(Harness)从自己的执行经验里持续进化。
最终,在 TerminalBench 2.0 上,演化后 Harness 准确率从 47.57% 提升到 52.43%;在 SWE-Bench Verified 上从 73.40% 提升到 76.45%。更关键的是,增益能跨任务域、跨基座模型,说明学到的不是基准技巧,而是可复用的执行机制。

-
论文题目: MODULARRSI: MODULAR AND GENERALIZABLE RE CURSIVE HARNESS SELF-IMPROVEMENT
01
让 Harness 真正学会泛化
在终端、软件工程等复杂任务上,CLI 智能体的上限,早已不只取决于大模型,更看包裹在模型外的那层 Harness,它掌管推理—行动—观察的循环、工具调用与上下文取舍。
近期递归自我改进(RSI)被引入 Harness 演化,但可泛化极难任务级成败只给极粗粒度的监督,告诉你成或败,却不告诉你是哪段机制出了问题。
论文点出三大痛点:
1、数据混淆:多数方法直接在下游基准上演化,分不清学到的是通用机制还是基准过拟合;
2、轨迹歧义:单条轨迹把系统缺陷和任务细节缠在一起,优化易过拟合;
3、信用分配:即便看出缺陷,也难定位该改 Harness 哪个组件,于是整块重写、互不相关的机制被搅在一起。
ModularRSI 的解法一句话:解耦 + 对比 + 门控。

先把可演化 Harness 拆成 5 个功能模块(Agent Loop、观测管理、工具使用、上下文管理、任务完成检测),以 Harbor 的 Terminus-2 为起点。
再对每条任务滚动执行 K 次,按成败分成 Positive / Contrastive / Negative 三组;Code-Modify Agent 配对比较同任务的成功与失败轨迹,把差异蒸馏成结构化「发现项」,并按跨任务投票数决定优先改什么。
最后用三重验证门控守住可靠性:程序检查(AST/协议静态校验)、差异审查(回滚任务专属的过拟合改动)、执行验证(实跑 2 个任务,出错即回滚)。五个模块独立演化后,再做一轮跨模块整合、冻结函数库。

结果上,演化 Harness 在域内把 TerminalBench 2.0 推到 52.43%、SWE-Bench-Verified 推到 76.45%;更惊人的是跨域,在 TB 上演化出的 Harness 把 SWE-Bench 提到 75.80%,反之 SWE 上演化出的把 TerminalBench 提到 49.40%。反映可靠性的 Pass³ 也从 30.34% 升到 35.96%。
02
信用分配难题:
为什么「整体改写 Harness」会失效
ModularRSI 真正的创新,藏在「信用分配」这四个字里。
任务级奖励只说成败、不指责任,这本身是个归因难题。此前不少方法直接重写大段 Harness,修改空间过大,不相关机制互相干扰,改了也难验证、难归因。
ModularRSI 用限制在模块内、限制在功能范围内来破局。
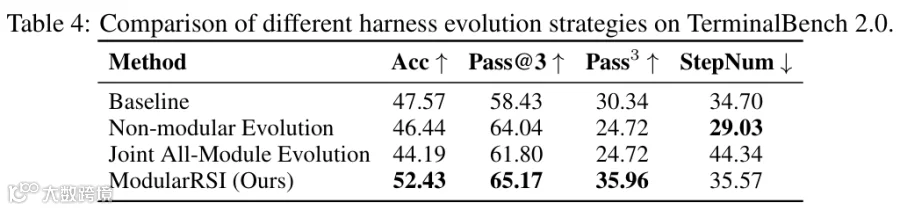
实验给了硬证据,在 TerminalBench 2.0 上,非模块化演化 46.44%、联合全模块演化 44.19%,反而都低于基线 47.57%;只有「独立演化各模块再整合」达到 52.43%。
这说明限制修改范围、降低跨机制干扰,才是可靠演化的关键。
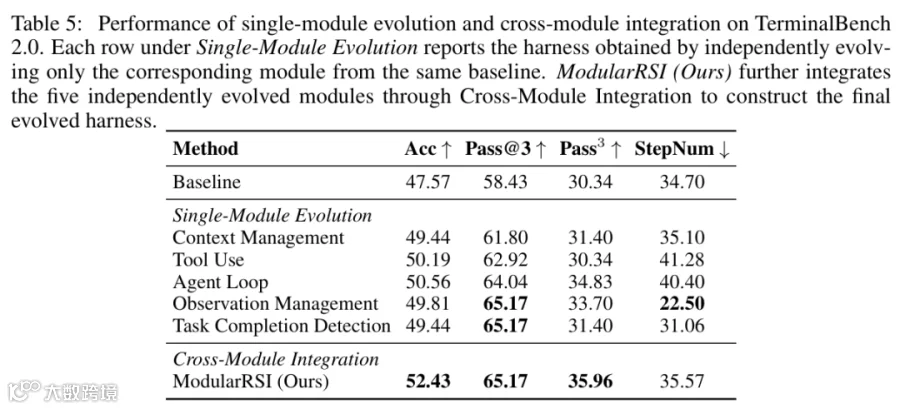
单模块拆解时,Agent Loop带来最大单模块增益(→50.56%),而观测管理大幅压低平均步数(34.70→22.50)——不同模块贡献互补的改进,整合后进一步抬升。

演化数据本身也有讲究。作者用 2000 条与下游基准零重叠的外部任务做演化(从 GitHub、HF、Kaggle 等外源重构,经多阶段质控),确保学到的是泛化能力而非基准适配。
难度分布上,中等难度集中的设定在 SWE-Bench 达 76.45%,高出「难+易」混合 2.20 个百分点——过易缺失败样本、过难缺成功轨迹,只有信息量充沛的对比,最能驱动泛化。
03
终端 Agent 的自改进,
正改写评测范式
ModularRSI 最值得玩味的一点:它学到的改进能跨基座模型迁移。冻结以 DeepSeek 演化出的 Harness,套到 GLM-5.2 上准确率从 59.55% 到 61.80%,套到 MiniMax-2.5 上从 41.57% 到 44.94%。这说明学到的是可迁移的执行过程,而非对某一模型的钻空子。

在统一协议、禁用联网检索的公平对比下,ModularRSI 取得 Acc 67.42%,明显优于 Meta-Harness(62.92%)与 AHE(62.54%),后两者在基准解耦设定下几乎停在基线。
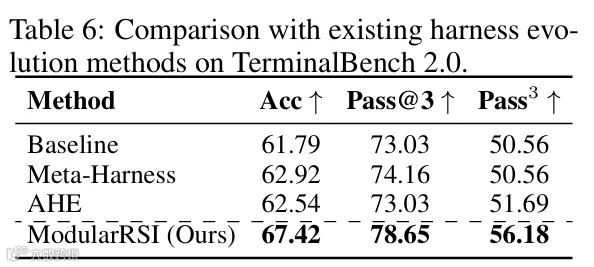
过去评价一个 Agent,常看它能否一次生成正确代码或答案。终端 Agent 出现后,标准正在变,模型要自己进环境、持续调工具、看结果、修错误,任务时长从一次生成扩展到数十甚至数百轮交互。
ModularRSI 这次工作给出的信号也很明确,递归自改进的价值,不取决于改了多少,而取决于改得是否泛化、是否可归因。当 Harness 从一团不可分割的整体,拆成可独立演化、可交叉验证的模块,并配上彻底解耦的演化数据,Agent 的「执行外壳」才真正迈出可持续自我进化的第一步。
END
关注+星标,获取AI前沿进展与开源一线动态