

MoE 大模型现在已经越来越常见。
相比所有参数都参与计算的稠密模型,MoE 会让每个 Token 只激活一小部分专家,在扩大模型容量的同时控制实际计算量。
但到了真正的在线推理阶段,问题又不一样了。
一次大模型生成通常分成 Prefill 和 Decode 两个阶段。Prefill 负责一次性处理用户输入的大量 Token,Decode 则在首个 Token 产生之后逐 Token 向后生成。
对于 MoE 来说,这两个阶段甚至卡在完全不同的地方。
Prefill 更受每个 Token 执行多少专家影响,Decode 则容易被一个 Batch 中大量不同专家带来的权重读取拖慢。
最近,小红书联合北京大学、上海交通大学和电子科技大学的研究团队,开源了面向 MoE Prefill 和 Decode 统一加速的免训练专家折叠框架 ExFold。

它没有重新训练模型,也不是简单把不重要的专家删掉,而是尝试把被排除专家原本应该产生的贡献,重新折叠到仍然执行的专家中。
最终,ExFold 在 vLLM 中实现了最高 1.41 倍 TTFT 加速和 2.45 倍 TPOT 加速,同时保持约 99% 的原始平均质量。团队还配套实现了轻量级 Expert Folding CUDA Kernel,并公开了完整代码。

01
Prefill和Decode卡在不同地方,ExFold
却把它们变成了一个问题
先看为什么 MoE 推理并不是简单的少算几个专家就能解决。
Prefill 一次会处理大量 Prompt Token。
每个 Token 都经过 Router 选择多个专家,当输入序列比较长时,同一批专家权重会被许多 Token 反复复用。
这时候真正影响速度的,主要是每个 Token 到底执行多少次 Expert FFN 计算。
因此 Prefill 想加速,一个很直接的方向就是减少 Token 实际执行的专家数量。
Decode 则正好相反。
Decode 每一步只给 Batch 中的每条请求生成一个新 Token,计算 Token 数量不多,但不同请求可能命中完全不同的专家。
结果就是只生成少量 Token,却可能需要把大量 Expert Weight 从显存中读取出来。
Decode 更关心的不是一个 Token 算多少专家,而是整个 Batch 一共碰到了多少个不同专家。
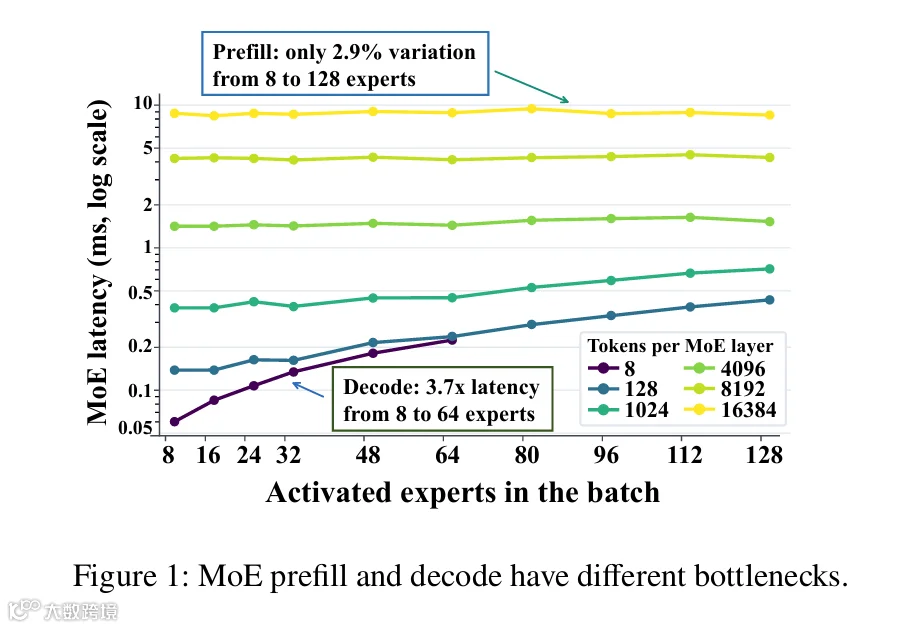
论文的延迟测试也能看到这种差异。
在 Decode 场景中,当 Batch 激活的专家数量从 8 个增加到 64 个时,MoE 延迟最高增加到 3.7 倍。
而在较大的 Prefill Token 数量下,专家数从 8 个增加到 128 个,延迟变化只有约 2.9%。
这也让过去的 MoE 加速方案出现了一个问题。
有的方法专门减少每个 Token 执行的 Expert,更适合解决 Prefill 计算量。
另一类方法则通过专家裁剪、合并或者限制 Batch 激活的专家集合,减少 Decode 阶段的数据访问。
两边优化的对象并不一样。
ExFold 做的第一件事,就是把这两个看起来完全不同的问题重新统一。
研究团队不再只问哪些专家应该执行,而是把 Prefill 和 Decode 都建模成一种带预算的输出近似问题。
也就是说,在限制可执行专家数量之后,怎样让最后得到的 MoE 输出尽可能接近原来的完整结果。
这样 Prefill 和 Decode 的区别就被压缩成了一件事。
Prefill 决定每个 Token 可以留下多少个专家。
Decode 决定整个 Batch 可以留下多少个专家。
两边选择保留专家的方式不同,但被排除专家留下的输出缺口,可以用同一种机制补回来。
02
专家可以不执行,但它原本的贡献
不能直接扔掉
这就是 ExFold 最核心的 Expert Folding。
过去很多专家裁剪或者 Expert Skipping 方法在缩减计算量时,思路比较直接。
某个专家不重要,那就不执行。
但问题也随之出现。
专家虽然没有执行,它本来应该给最终 MoE 输出贡献的那一部分也一起消失了。
预算压得越狠,这种误差就越明显。
ExFold 没有把这部分贡献直接扔掉,而是寻找另外一个已经保留的 Expert,让它来近似被排除 Expert 的输出。
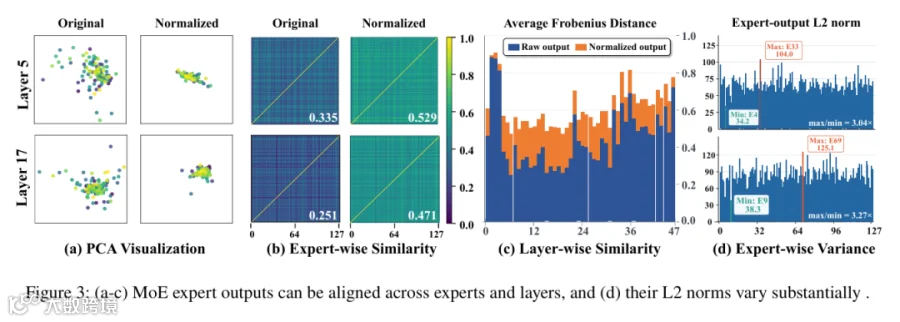
研究团队发现,不同 MoE Expert 的输出之间存在一种比较特殊的冗余。
不少专家的输出向量虽然大小不同,但方向其实相当接近。
在论文对 Qwen3 的分析中,对专家输出归一化之后,第 5 层平均专家相似度从 0.335 提高到 0.529,第 17 层则从 0.251 提高到 0.471。
与此同时,不同专家输出的 L2 Norm 又可能存在超过 3 倍的差距。
简单理解就是一件事。
很多 Expert 输出主要不是方向完全不同,而是差在了尺度上。
既然主要差的是大小,就不一定需要另外生成一个完整的高维向量。
ExFold 为不同 Expert Pair 校准一个成对标量投影器 Pairwise Scalar Projector。
离线校准时,系统会观察 Source Expert 和 Target Expert 的输出关系,然后计算一个标量。
这个标量解决的问题很直接。
如果 Source Expert 这次不执行,那么应该把 Target Expert 的输出放大或者缩小多少,才能尽可能还原 Source Expert 原本提供的贡献。
除了 Scalar Projector,ExFold 还会得到对应的 Projection Loss,用来判断某个被排除 Expert 最适合折叠进哪个保留 Expert。
整个过程使用无标签数据完成,不需要梯度更新,也不会修改原始模型权重。
因此论文将 ExFold 定位为 Training-Free 方法。

进入真正推理以后,这套校准结果就可以同时服务两个阶段。
Prefill 中,每个 Token 只保留预算允许的主要专家,其余专家向这些保留 Expert 折叠。
Decode 中,则先从整个 Batch 中选择有限数量的主要 Expert,再把预算之外的路由重新映射到保留集合。
Prefill 限制的是 Token 级专家数量,Decode 限制的是 Batch 级专家池,两边共享的是同一套 Expert Folding。
而且 ExFold 最终得到的缩放系数可以直接吸收到 Router Weight 中。
也就是说,它不需要在线显式生成被排除 Expert 的完整输出,完成路由转换之后,仍然可以把结果交给标准的 Fused MoE Operator 执行。官方实现也是在 Fused MoE 之前完成 Routing Transformation。
这也是 Expert Folding 和直接跳过 Expert 的关键区别。
专家本身可以不算,但它对结果的贡献尽量保留下来。
03
TTFT最高1.41倍、TPOT最高2.45倍,
ExFold已经接入vLLM
统一的方法最后还是要看真实 Serving 能不能加速。
论文主要围绕 Qwen3-30B-A3B 展开实验,同时覆盖多种 MoE 架构,并直接在 vLLM Serving 环境中测试 Prefill 和 Decode 延迟。
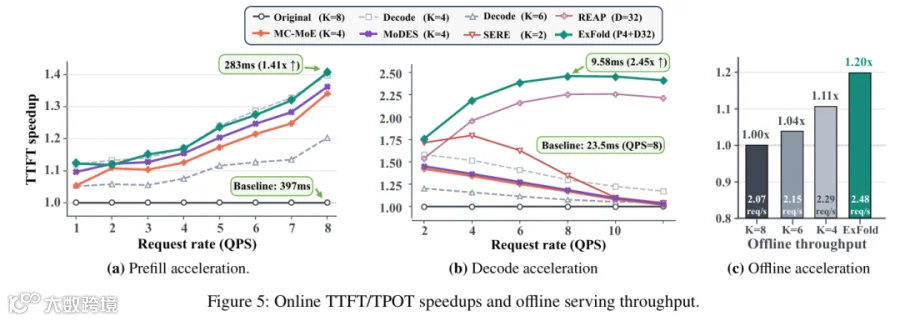
在 Qwen3 的 Prefill 测试中,ExFold 将 TTFT 从 397 ms 降低到 283 ms,对应最高约 1.41 倍加速。
Decode 阶段提升更加明显。
在对应测试条件下,基线 TPOT 为 23.5 ms,ExFold 可以降低到 9.58 ms,最高达到 2.45 倍加速。
离线吞吐也从 2.07 req/s 提高到 2.48 req/s,约为原来的 1.20 倍。
更关键的是,这种加速并没有建立在明显牺牲模型质量的基础上。
论文最终给出的总体结果是,ExFold 在实现 Prefill 和 Decode 加速的同时,仍然能够保留约 99% 的原始平均质量。
这正是前面的 Expert Folding 发挥作用的地方。
如果只是不断减少 Expert 数量,速度当然可以继续提高,但模型输出也可能越来越偏离原始 MoE。
ExFold 想做的是另一种取舍。
减少真正需要执行的专家,同时把那些没执行专家的贡献尽量折回剩余计算路径。
GitHub 仓库中包含校准矩阵、Qwen3 和 DeepSeek-V4 相关实现、Triton 与 CUDA Kernel、vLLM Patch、质量评测代码以及 Serving 和速度复现脚本。项目采用 Apache-2.0 License。
其中 Qwen3 的论文 Prefill 性能复现环境使用 4 张 H800,Decode 性能环境使用 1 张 H800,官方仓库也给出了对应的 vLLM 版本和复现入口。

ExFold 这次真正改变的,不只是让 MoE 再少执行几个 Expert。
它把问题从哪些专家可以删掉,进一步变成了这些专家不执行之后,它们原本的贡献应该去哪里。
再利用同一套 Expert Folding,把 Prefill 的 Token 级计算预算和 Decode 的 Batch 级专家预算统一起来。
对于越来越依赖 MoE 的大模型来说,这也提供了另一种推理加速方向。
不一定需要重新训练模型,也不一定永久裁掉 Expert,而是可以在推理阶段重新组织专家贡献本身。
END
关注+星标,获取AI前沿进展与开源一线动态