

DeepSeek-V4.1-Flash 的技术报告把 Terminal-Bench 2.1 的成绩写在 90.6,压过 Opus-5.0(89.1)、GPT-5.6 Sol(88.8)、GLM-5.3(88.2),是那张表里的第一名。
我们在自己的机器上,用 DeepSeek 自家的 harness DSH,把同样 89 道题原样跑了一遍。
实测 77.5%。
89 道题 × 4 条线 · 主跑 16 小时 34 分 · 4.49 亿 输入 token · 8×A800 80GB 全部原始轨迹已公开,逐条可查。
01 / 官方声称 vs 实测
官方数字来自 DeepSeek-V4.1-Flash 技术报告和 Qwen 官方评测页:

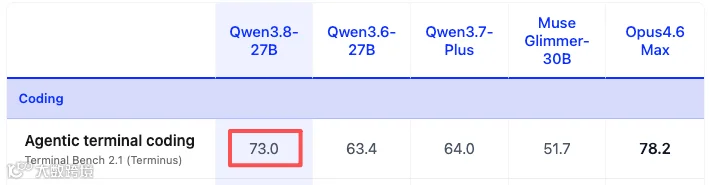 Qwen 官方公布的 Terminal-Bench 2.1 成绩。来源:https://huggingface.co/Qwen/Qwen3.8-27B
对上我们的实测:
|
|
|
|
注水率 |
|---|---|---|---|
| DeepSeek-V4.1-Flash
|
90.6 |
|
14.5% |
|
dsh |
|
|
17.2% |
|
terminus-2(TB 原生) |
|
|
--- |
|
terminus-2(TB 原生) |
|
|
|
注水率 =(声称 − 实测)÷ 声称。
DeepSeek 用自己的 harness 也差 14.5%–17.2%,换成 TB 原生的 terminus-2 差到 23.9%。Qwen 差 6.2%。
V4.1 确实比 V4 强,但两边都够不着官方水位
同一套 harness、同一台机器、同一批题:
V4.1   69/89 = 77.5%
V4     61/89 = 68.5%
        ↑ +9.0 个百分点,相对提升 13.1%
官方口径的进步是 82.7 → 90.6,**+7.9 个百分点。我们量到 +9.0 个百分点——进步幅度对得上,绝对水位对不上。** 两代模型都比各自声称低十几个点,而且低得相当等比例。
配对检验(精确 McNemar,同一批 89 题):
V4.1+dsh  vs  V4+dsh       净 +8    p = 0.15    不显著
V4.1+dsh  vs  Qwen3.8+t2   净 +8    p = 0.13    不显著
V4.1+dsh  vs  V4+t2        净 +13   p = 0.019   显著
V4+dsh    vs  Qwen3.8+t2   净  0    p = 1.00    完全打平
必须说清楚:+13% 这个提升在 89 题的规模上不显著(p=0.15)。方向明确、V4.1 是四条线里唯一越过 70% 的,但「已经证明更强」这句话,这个样本量撑不起来。
三条必须说在前面的限制
一、我们只跑一次,官方通常多次取平均。 所以「注水率」应理解为「我们这一次没能复现出来的差距」,不是精确的虚报幅度。
二、脚手架本身就值好几分。 同一个 V4 模型,换个 harness 差 5.6 个百分点(68.5% vs 62.9%)。以后看到任何 Terminal-Bench 成绩,先问一句:用的什么 harness。
三、有一个随机故障会让分数浮动 2–4 题(见第 05 节)。它给 V4.1 留下的残留比给 V4 的多,所以 77.5% 如果有偏,是偏低。
02 / 怎么测的
判分权不在我们手里
每道题自带测试脚本,跑完由它说了算。我们不改测试、不人工判断「做得对不对」。
唯一需要我们定规则的地方,是哪些失败不该算到模型头上。四条线用同一把尺子,写死在一个脚本里(score4.py),三档分数逐层给出:
|
|
|
|---|---|
| as-shipped |
|
| + 基础设施重跑 |
|
| + 产物标准 |
|
四条线的三档分数:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
69/89 = 77.5% |
|
|
|
|
61/89 = 68.5% |
|
|
|
|
61/89 = 68.5% |
|
|
|
|
56/89 = 62.9% |
第二档对所有线都有效,不是只给新模型开的后门:V4+dsh 涨了 6.8 个百分点,V4+terminus-2 涨了 3.3 个百分点。修环境让所有人受益。
环境:把与智能无关的东西全部挡掉
这台机器的出网只有 8–70 KB/s,单条长连接还会被进一步限速。不处理的话,测出来的是网速不是智力。两个磁盘缓存挡在前面:
-
apt: aptcache.py(20180 端口,HTTP 落盘缓存) -
pip/uv: pypicache.py(8099 端口,清华源前面的 PEP 503 磁盘缓存)
89 道题的 verifier 一共只用到 53 个钉死版本的包(pytest==8.4.1 出现 82 次,torch 三个版本,torchvision、transformers、timm、opencv、pyarrow、scikit-image)。以前每个容器各下各的,同一个 torch==2.7.1(连 CUDA 依赖约 3 GB)一轮要下好几遍。接上缓存后每个 wheel 全机器只下一次,缓存从 8.8 GB 涨到 19.4 GB。
apt 那边的冷启动耗时,直接说明了问题有多大:
tesseract-ocr-all + tesseract-ocr + imagemagick + python3-pil    755 秒
python3 python3-pip primer3                                       77 秒
python3                                                        33-49 秒
qemu-system-x86 qemu-utils openssh-client                         15 秒
755 秒——而 dsh 砍单条命令的上限是 300 秒。 这道题(gcode-to-text)在原环境里没有任何通关可能,跟模型会不会做完全无关。接上缓存后同样的安装是 10–25 秒。
为了不出现「以为修好了其实没修」,每次重跑前跑一次 verify_repair.sh:刷新索引并断言一次代表性安装必须快于 60 秒,不达标就退出,不花这个钱。
思考档位
V4.1 的思考开关是二元的:默认开(/tokenize 对 "hi" 返回 31),reasoning_effort: "none" 关(返回 5),没有 V4 那种 max 档。V4 那轮用的是 max 档(返回 84)。每轮开跑前和收尾各断言一次,确认全程没漂。
03 / 起哪个配置:TP=8 还是 TP=4×DP=2
部署方式影响吞吐,进而影响有多少题死在超时上,所以这一步不能拍脑袋。按 dsh 的真实流量形状压了一遍——prompt 40k(实测输入 p50 = 40,518,p90 = 176,545,最大 326,724),输出 512,并发 1/2/4/8:
|
|
|
|
|
|---|---|---|---|
|
|
21.8 s |
|
72.3
|
|
|
25.3 s |
|
42.2
|
|
|
43.8 s |
|
24.9
|
|
|
|
73.7 s |
|
跑基准用 4 并发,那一档 TP=8 快 7.8%,所以选 TP=8。 DP 要到并发 ≥8 才反超。
低并发 DP 反而更慢,原因是 vLLM 的 DP 要求两个 rank 的 forward 对齐:一边空闲时也得跟着走 MoE 的 all-to-all,而这条 all-to-all 跨 NUMA(本机拓扑是 {0-3} 和 {4-7} 两个 PIX 岛,跨岛走 SYS)。单流等于白付一次同步。
显存账也对得上:
TP=8         每卡 36.64 GiB    KV 13,328,084 token   1M 上下文下 12.71 路并发
DP=2×TP=4    每卡 39.03 GiB    KV 12,285,742 token/rank(合计 2457 万)
DP 每卡多 2.4 GiB,正是 dense/attention 从 8 路切分退回 4 路的代价(专家权重仍是 8 路 EP)。KV 总量反而翻倍——MLA 的 KV 在 TP 下各卡全量复制,拆成两个 DP 组等于把这份复制变成两份独立预算。
长上下文那一头,稀疏注意力让解码几乎不随上下文衰减,代价全在 prefill:
prompt 128k, TP=8    单流解码 71.8 tok/s(40k 时是 72.3)
                     prefill 2925 tok/s 单流 / 6649 tok/s(4 并发)
                     TTFT 43.8 s 单流 / 77.0 s(4 并发)
并发 8 时的峰值聚合解码是 290 tok/s。
两个坑值得写下来。一是**不能加
--block-size 256**:V4.1 的稀疏 MLA kernel 要求 128 的稠密页,会直接报block stride 460224 != page 74752启动失败。二是 DP 模式下前端等 engine core 的超时写死 600 秒,而这个模型加载要 785 秒,必须-e VLLM_ENGINE_READY_TIMEOUT_S=3600;TP 走的是另一条路径,不会撞上。
04 / 失败分类:把「不会做」和「环境挂了」分开
V4.1 主跑 26 道未通过,逐个查根因:
|
|
|
|---|---|
| 基础设施
|
|
|
|
|
|
|
|
一个 VerifierTimeoutError 都没有。 我们一度盯着 pytorch-model-recovery 下 torch 下了一个半小时,最后它在预算内下完并通过了。
8 道基础设施故障里 6 道是 dpkg was interrupted。因果链在日志里很清楚(以 write-compressor 为例):
agent 侧:apt-get install ... → "timed out after 300"     ← dsh 的 300 秒硬超时
         dpkg 事务被拦腰砍断,包数据库损坏
verifier 侧:E: dpkg was interrupted, you must manually run 'dpkg --configure -a'
         curl: command not found
         uvx: command not found                            ← 一个测试都没跑
顺带说一句:dsh 那个 300 秒是可以改大的,它是 profile 里一个普通配置项(packages/bundle/sdk-minimal/cordis.patch.yml 里的 timeoutMs: 300000),在 $DSH_HOME/cordis.patch.yml 放一个 id 定向覆盖即可,不用动发布的二进制。但本轮我们没改——300 秒是 dsh 发布出来的样子,是被测对象的一部分,改了就不是在测 dsh 了。
05 / 一个随机故障,和一次没查到底的调查
有 4 道题在网络可验证地变快之后(断言:代表性安装 60 秒内完成)仍然 dpkg 损坏。逐条排除,每条都是实测不是推理:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
--cpus 1 --memory 2048m
|
|
|
|
|
|
|
|
|
|
|
|
pty.fork()
|
|
最后一条本来最被看好——dsh 的 bash 跑在 PTY 上,程序读 stdin 会永久阻塞而不是拿到 EOF。用 pty.fork() 搭了一模一样的环境,没卡,假设被自己的实验推翻。
决定性的证据来自另一边:同一批题,两个模型坏在完全不同的位置。
|
|
|
|
|---|---|---|
|
|
|
✓ 过了 |
|
|
|
✓ 过了 |
|
|
|
✓ 过了 |
|
|
✓ 过了 |
|
|
|
|
|
所以它既不是「这几道题注定坏」,也不是模型差异——是一个随机命中约 20–40% 的故障。
机制我们没查到底,就照实写「已排除以上六项,未完全定位」,不编一个好听的解释。
对分数的影响必须说清楚:V4 重跑救回 6/11,V4.1 救回 3/8,最终仍有 4 道算在 V4.1 头上、只有 2 道算在 V4 头上。这是同一个随机故障的运气差,不是能力差。所以 77.5% 如果有偏,是偏低。
06 / 模型自己会修环境,但这不加分
87 条留下完整 session 的 trial 里,45 道至少有一条命令被 dsh 的 300 秒砍过,累计损失 7.0 小时。只统计模型自己发出的命令:
|
|
|
|---|---|
--connect-timeout
|
|
Acquire::Retries
|
|
--no-deps / --only-binary / apt-get download + dpkg -i)
|
|
| 推到后台绕开 300 秒上限 |
|
| 换 pip 源 |
|
最漂亮的一条,sam-cell-segmentation seq 70——被砍之后,它在一步里做对了三件事:
pkill -f 'pip install torch' || true; sleep 1; \
nohup pip install torch torchvision \
  --index-url https://mirrors.tuna.tsinghua.edu.cn/pytorch/whl/cpu \
  > /tmp/pip_torch_cpu.log 2>&1 & echo $!
先清掉被砍剩的残留进程;再用 nohup ... & 把下载挪到 300 秒管不着的地方;同时换成清华的 PyTorch 镜像。后面还进一步降级到 whl/cpu 的 CPU 版——它意识到这题根本不需要 CUDA wheel,体积小一个数量级。
gcode-to-text 是同一套思路:nohup apt-get install -y tesseract-ocr ... & echo $! > /tmp/apt2.pid。这题冷装实测 755 秒,规避完全正确——但它还是失败了,因为更早一次被砍已经把 dpkg 搞坏了,后面怎么绕都没用。
Qwen 那条线也在自救:26 次 --index-url .../whl/cpu(跟 V4.1 想到一块去了)、350 次 nohup、30 次 setsid。
这两组数不能直接比:terminus-2 的日志是终端屏幕录像,dsh 的是结构化 tool call,计数口径不同。只能定性说「两边都会自救」。
而且这些自救大多不加分——它补的是链路和 harness 的窟窿,赢回来的只是本该有的起跑线。所以它不进分数,只单独记一节。
07 / V4.1 最终错的 20 道
做不完(2 道):gpt2-codegolf、make-doom-for-mips——都是 agent 用光了 90 分钟。这两道一次都没被 300 秒砍过,时间是实打实花在自己身上的。
随机 dpkg(4 道):write-compressor、polyglot-c-py、sparql-university、dna-insert。
答案错了(14 道):
|
|
|
|---|---|
model-extraction |
|
video-processing |
|
query-optimize |
|
torch-pipeline-parallelism |
|
regex-chess |
|
sam-cell-segmentation |
|
train-fasttext |
|
mailman |
|
make-mips-interpreter |
|
protein-assembly |
|
overfull-hbox |
|
pytorch-model-cli |
|
configure-git-webserver |
|
gcode-to-text |
|
gcode-to-text 是个好例子:修环境之前它是「基础设施故障」,修完之后变成「老实答错」。修环境不是放水,是让题目能被真正回答。
08 / 产物标准:三道题,三条日志
有些题要求起一个服务。dsh 在 agent 结束时会把持久 shell 连同整棵进程树一起 SIGKILL,于是 verifier 过来时什么都没监听。如果 agent 把服务建对了、自己也验证通过了,算它过——但必须在它自己的日志里找到实证:
pypi-server        Successfully installed vectorops
                   ← 正是 verifier 要执行的那条命令

kv-store-grpc      KVStore server listening on port 5328
                   SetVal: val: 123
                   GetVal: val: 123

hf-model-inference 200 {'sentiment': 'positive'}   ← test_sentiment_endpoint
                   400 {'error': "'text' must be a non-empty string."}
                                                   ← test_api_error_handling
hf-model-inference 这条尤其干净:两条挂掉的断言,它在日志里都当场演示过了。
同样这条规则下判不过的:mailman——服务活着,但它自己的测试显示退订没生效。产物就是错的。
这条规则对 V4 和 V4.1 用的是同一把尺:两边各 3 道题通过,mailman 两边都不通过。
09 / 成本
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
输入远大于输出是 agent 类任务的常态:每走一步,之前所有的终端输出都要重新喂给模型。V4.1 的 4.49 亿输入对 421 万输出,比是 107 : 1。
对比 V4 同一条线的 3.89 亿 / 406 万——V4.1 多烧了 15% 的输入 token,换来 9 个百分点。
10 / 原始数据
数据集 https://huggingface.co/datasets/openguardrails/tb21-dsv41-flash-dsh
113 个 trial 的完整轨迹(含每一步的思考过程和工具调用)、每道题测试脚本的原始输出、以及本文用到的全部 37 个记分与分析脚本,44.3 MB,没有删改。上文每一条声明都能在里面查到对应文件。
判分链条全部公开:score4.py(唯一的记分器,三档分数和 McNemar 都由它产出)、classify_v41.py(失败分类)、net_cost.py(网络损耗量化)、net_adapt.py(自救行为统计)、evidence_v41.py(产物标准取证)、verify_repair.sh(环境断言)、bench_cfg.py(配置压测),连 pty_apt_test.py(那个被自己推翻的假设)也放进去了。
测试环境:8×A800-80GB PCIe,vLLM。V4.1 和 V4-0731 都是 fp8、TP=8+EP。V4.1 的 Ampere 移植见上一篇《我们写了 5 个新算子,让 vLLM 支持 DeepSeek-V4.1-Flash 跑在 Ampere 卡上》,镜像 openguardrails/vllm-dsv41-flash-sm80。
服务端配置:
docker run -d --gpus all --init --ipc=host --network host \
  -v /mnt/data/models:/models:ro \
  openguardrails/vllm-dsv41-flash-sm80:latest \
  serve /models/deepseek-ai/DeepSeek-V4.1-Flash \
    --served-model-name dsv41-flash --port 8000 --trust-remote-code \
    --tensor-parallel-size 8 --enable-expert-parallel \
    --hier-all-reduce-islands "0,1,2,3;4,5,6,7" \
    --kv-cache-dtype fp8 --gpu-memory-utilization 0.92 \
    --max-model-len 1048576 --max-num-batched-tokens 8192 --max-num-seqs 8 \
    --reasoning-parser deepseek_v41 --tool-call-parser deepseek_v41 \
    --enable-auto-tool-choice