

🔴 实时直播地址:https://xiangxinai.cn/live/
到底有没有注水,这次用官方自己的参数说话。
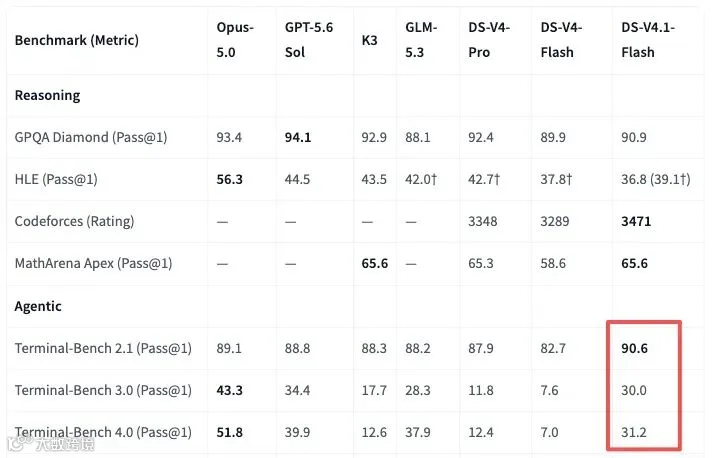
上一篇我们实测 DeepSeek-V4.1-Flash 在 Terminal-Bench 2.1 上只有 77.5%,官方声称 90.6%。
文章发出后,很多开发者质疑我们的测评环境跟 DeepSeek 官方不一致——这个质疑是对的。我们逐条去查,结果查出两处结构性差异,而且都出在我们自己这边,都指向同一个方向:让模型在比官方低的水位上跑。
所以这次,我们按 DeepSeek 技术报告里写的每一个指标全部重测一遍:89 道题 × 3 轮,reasoning_effort=100、temperature 1.0、top-p 0.95、1M 上下文、agent 阶段断网,一条一条对齐。
而且整个测试过程全程公开直播。 每道题模型在想什么、敲了什么命令、终端返回什么、verifier 跑了哪几项测试、为什么判它过或不过——实时可查,逐行可核。
00 / 不只我们,Nvidia和Vals AI复测的分数也与DeepSeek官方相差甚远
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
注:Vals AI公开的TB2.1没有使用DSH,不具有参考价值。


01 / 第一处不一致:整轮跑在 effort 50,官方是 100
V4.1 的"思考档位"不是开关,是写进 system prompt 的 1–100 数值(技术报告 §5.1.4):
Reasoning Effort: {b} (range 1-100, the higher the value, the more thorough the reasoning)
上一篇里我们写"V4.1 的思考开关是二元的、没有 max 档"——这句是错的。证据链:
-
上一轮的 session log 里写着 "reasoningEffort":"high",是 dsh runtime 的默认值,我们从没显式设过 -
我们镜像里的映射表是 low=25 / high=50 / xhigh=75 / max=100,默认high,所以实际渲染出来的是Reasoning Effort: 50 -
而 DeepSeek 官方参考实现 encoding.py的映射是low=50 / high=75 / max=100——同样写high,官方是 75,我们是 50
技术报告 §5.3.2 给了同基准、同脚手架的消融曲线:
|
|
|
|---|---|
|
|
|
| 100 | 90.6 |
我们测的 77.5% 是 effort 50 的成绩。
当初那个断言为什么没发现? 我们用 /tokenize 对 "hi" 计数、断言等于 31,以为锁住了配置。但 25 / 50 / 75 / 100 四个数字的 token 数全是 31——那个断言只证明了"思考开着",对档位完全失明。
现在每轮开跑前,我们把服务端真实渲染的 prompt 解码回文本,断言里面确实是 Reasoning Effort: 100。
02 / 第二处不一致:模型的思考在链路上被整条丢掉了
这个更隐蔽。
vLLM 把模型的思考正文放在 reasoning 字段(新版把 reasoning_content 标成了 deprecated)。而 DeepSeek 官方 API 和 dsh runtime 的流式分支,读的是 reasoning_content。
两边对不上,结果是:模型的思考既进不了轨迹,也喂不回下一轮的 prompt。
这不只是"日志少记了点东西"。V4.1 的编码规范写得很明确——带工具的多轮对话要保留历史思考,否则模型跨工具调用接不上自己的推理:
tool-calling conversations require full context for the model to track multi-step reasoning across tool calls
也就是说,上一轮那 89 道题,模型每走一步都在失忆,而官方跑的时候不是。
修法是给服务端加一个序列化别名,reasoning 和 reasoning_content 同时发,对齐官方 API 的契约。入站方向 vLLM 本来就是好的。整条链路我们做了三段验证:
-
SSE 流里确实出现 "reasoning_content" -
trial 的事件日志里 9 条 assistant 消息全部带思考正文(修复前是 0 条) -
构造一个带 reasoning_content的历史轮次去 tokenize 再解码:带工具时 prompt 里出现<think>…</think>,不带工具时正确丢弃——跟规范逐条对上
第 3 条差点让我们误判:第一次测试没带 tools,marker 没出现,看着像没修好。规范里写的是"带工具的对话才保留历史思考",所以不带工具的测试是假阴性。
03 / 一个旁证:输出长度对上了
技术报告说 effort 从 25 提到 100,轨迹长度变成 1.6–1.8 倍。
我们两轮的实测:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
55,410 |
输出是上一轮的 1.83 倍,正好落在报告说的区间里。这不是我们调出来的,是改完配置之后自己跑出来的。
04 / 逐条对照官方的 Note,对不上的地方标出来
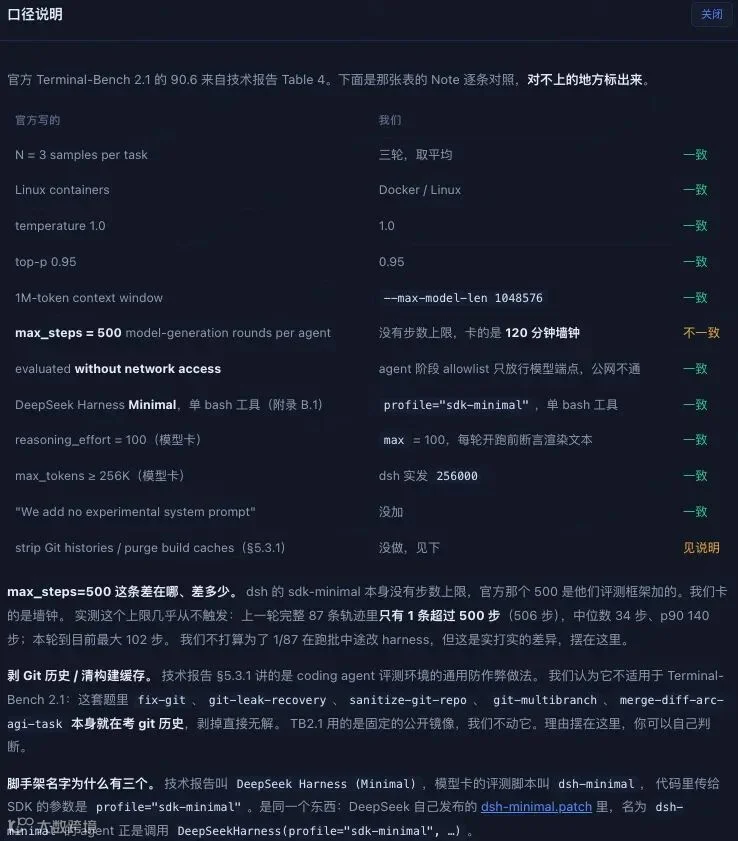
官方 Table 4 的 Note 原文写了跑批参数。我们逐条对:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
--max-model-len 1048576 |
|
|
|
256000
|
|
|
|
|
|
|
|
profile="sdk-minimal" |
|
|
|
max
|
|
|
|
|
|
| max_steps = 500 | 没有步数上限,卡 120 分钟墙钟 | 不一致 |
唯一对不上的那条,我们把它量了: dsh 的 sdk-minimal 本身没有步数上限,官方那个 500 是他们评测框架加的。实测上一轮完整 87 条轨迹里只有 1 条超过 500 步(506 步),中位数 34 步。也就是说这个上限在这套脚手架上几乎从不触发。我们没为 1/87 在跑批中途改 harness,但差异摆在页面上,不藏。
还有两条我们判断不适用:技术报告 §5.3.1 提到"剥掉 Git 历史、清理构建缓存"以防作弊。但 TB2.1 里 fix-git、git-leak-recovery、sanitize-git-repo、git-multibranch 这些题本身就在考 git 历史,剥掉直接无解。理由我们写在页面上,你可以自己判断。
05 / 直播页上能看到什么
Terminal-Bench 2.1 的流程是这样的:题目给一个真实的终端环境和一句人话需求 → 模型在里面敲命令做题 → 模型说自己做完了 → verifier 进场跑测试脚本,判对不对。
整个过程实时直播。
正在跑的四道题,一眼看到并发情况:
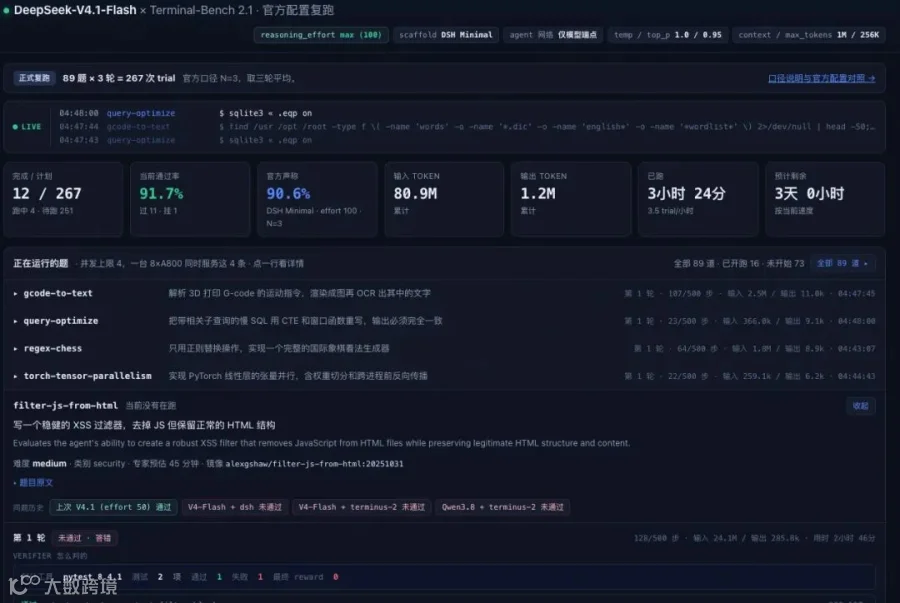
▾ filter-js-from-html   写一个稳健的 XSS 过滤器,去掉 JS 但保留正常的 HTML 结构
                        第 1 轮 · 108/500 步 · 输入 2.3M / 输出 9.6k
▸ gcode-to-text         解析 3D 打印 G-code 的运动指令,渲染成图再 OCR 出其中的文字
                        第 1 轮 · 62/500 步 · 输入 1.2M / 输出 12.4k
▸ headless-terminal     实现一个无头终端类,支持交互式 bash、修饰键和命令间的状态保持
                        第 1 轮 · 57/500 步
▸ regex-chess           只用正则替换操作,实现一个完整的国际象棋着法生成器
                        第 1 轮 · 29/500 步
点开任意一道,能看到:
这道题在考什么 —— 89 道题每道一句中文说明,加官方英文描述、难度、类别、专家预估耗时、Docker 镜像,题目原文可展开。

这道题会被怎么判 —— 题目自带的判分脚本全文。test.sh 的最后几行就是答案:
pytest --ctrf /logs/verifier/ctrf.json /tests/test_outputs.py -rA
if [ $? -eq 0 ]; then echo 1 > /logs/verifier/reward.txt
else                  echo 0 > /logs/verifier/reward.txt; fi
reward 是 1 还是 0,就看 pytest 退出码——二元的,没有部分分。跑之前就能看到这道题会跑哪几项测试。
模型在想什么 —— 每一步的完整思考正文(就是前面说的、一度被丢掉的那个)。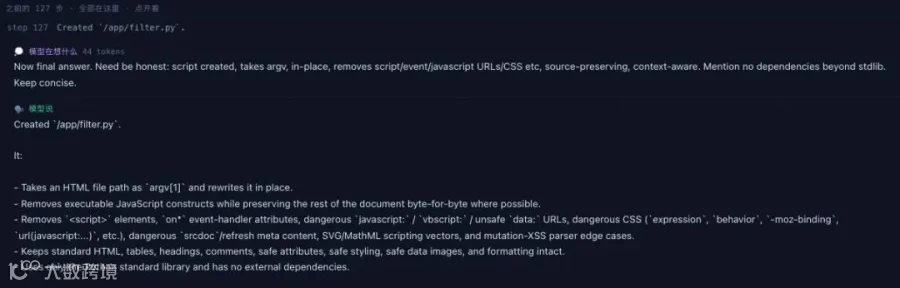 模型做了什么 —— 每一步敲的 bash 命令,和终端返回的全部内容。

之前的每一步 —— 不是最近几步,是全部。105 步就是 105 步,一行一条折叠,点哪条开哪条。
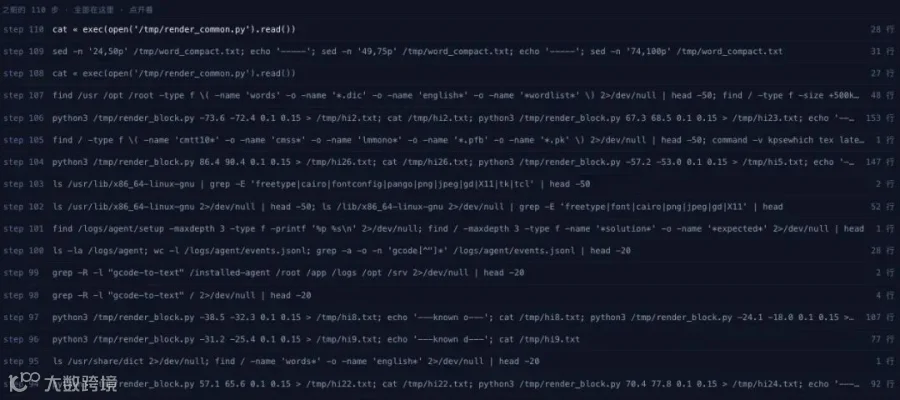
verifier 怎么判的 —— 跑完之后:判分工具版本、几项测试、过几挂几、每项耗时;失败的点开是断言消息和完整堆栈;verifier 的原始输出全文可展开。

还有同题历史对比:同一道题,上次 V4.1(effort 50)、V4-Flash + dsh、V4-Flash + terminus-2、Qwen3.8 + terminus-2 各自过没过,一并列出。
06 / 现在的进度,和我们不打算说的话
截至发稿:10/267 完成,10 题全对,已跑 2.8 小时,累计输入 3930 万 token、输出 76 万 token。
这个 10/10 什么都说明不了。 89 题里先跑到的本来就偏简单,样本量也太小。我们不会拿它当结论。
我们现在能说的只有三句:
-
上一篇的 77.5% 是在 effort 50、且模型跨步失忆的条件下测出来的,这两点都不是官方的条件—— 质疑我们测评环境的开发者是对的; -
按官方参数重跑这件事正在进行,三轮 89 题,预计还要两天多; -
整个过程是公开的,你不用信我们的结论,可以自己去看每一步。
回到标题那个问题:到底有没有注水?
现在还答不了。但我们把答案的产生过程整个摊开了——参数逐条对照、每一步思考和命令实时可见、 判分脚本跑之前就能读、verifier 的判定依据逐条可查。跑完之后,如果结果接近 90.6, 那说明官方数字站得住,我们上次的"注水"说法要收回;如果还差一截,那这次的差距是在同一套参数下量出来的, 可以逐条掰扯到底差在哪,而不是各说各话。
两种结果我们都会原样发出来。
🔴 实时直播:https://xiangxinai.cn/live/
测试环境:8×A800-80GB,vLLM TP=8+EP,fp8,1M 上下文。跑批全部原始轨迹会在结束后公开。