


把 AI 应用真正接进业务之后,记忆系统会同时撞上两类压力。
一类来自量。业务高峰期,成百上千个会话同时在问“这个客户以前说过什么”,响应变慢、请求排队,写入与检索还要抢同一份资源。
另一类来自质。一通四十分钟的沟通结束,关键结论散落在大段原始对话里,下次要用还得重新翻;对话又没有明确的结束信号,该沉淀的一直没沉淀。
近期,红熊AI记忆科学 MemoryBear v0.4.6 正式发布。本次更新新增长期固化演进引擎,同步升级高并发检索链路、开放记忆数据接口,并更新知识库问答闭环与多模态检索能力。
整次更新围绕一条主线:让记忆系统不再只是被动地把内容存下来,而是开始主动地组织它。主要更新有:
⦿ 长期固化演进引擎:自动识别对话结束与闲置,生成持久化摘要,提升长期记忆的连续性。
⦿ 检索链路升级:异步双写同步,把图谱存储与在线召回解耦,提升并发吞吐与尾部稳定性。
⦿ 记忆数据接口:开放记忆活动、热门标签、总记忆容量三个对外接口。
⦿ 知识库智能化:新增 QA 知识补充闭环,多模态分块支持独立检索重排。
⦿ 稳定性与安全:优化并发写入顺序与图谱抽取稳定性,加强模型凭据存储。
长期固化演进引擎是本次新增能力,也是这一版更新的重点。
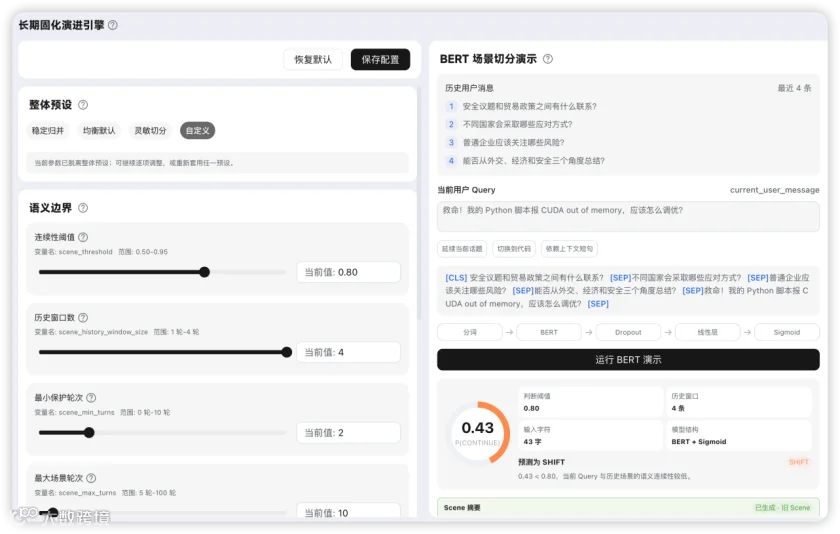
长期固化演进引擎:对话结束时,自动生成“长期摘要”
这是 v0.4.6 新增的主要能力,解决的是“一段对话结束时,该留下什么”。简单来说,引擎会自动识别对话场景何时结束或进入闲置,并在这一节点生成持久化摘要,提升长期记忆的完整性与连续性。
常见的场景是:一位客户经理和客户聊了四十分钟,谈到预算区间、决策流程、正在比较的方案和下一步动作。内容若只是原样存下,下次要用还得在大量原始对话里重新理解和筛选。
因此,红熊AI的做法是:在场景结束时就生成一份摘要,下一次对话可以直接接上。这样一来,上下文的连续性就保住了。
“识别闲置”同样关键。真实业务里的对话很少有一个明确的结束动作,用户往往就是不说话了,系统不依赖用户配合也能完成沉淀,这项能力在实际使用中才站得住。

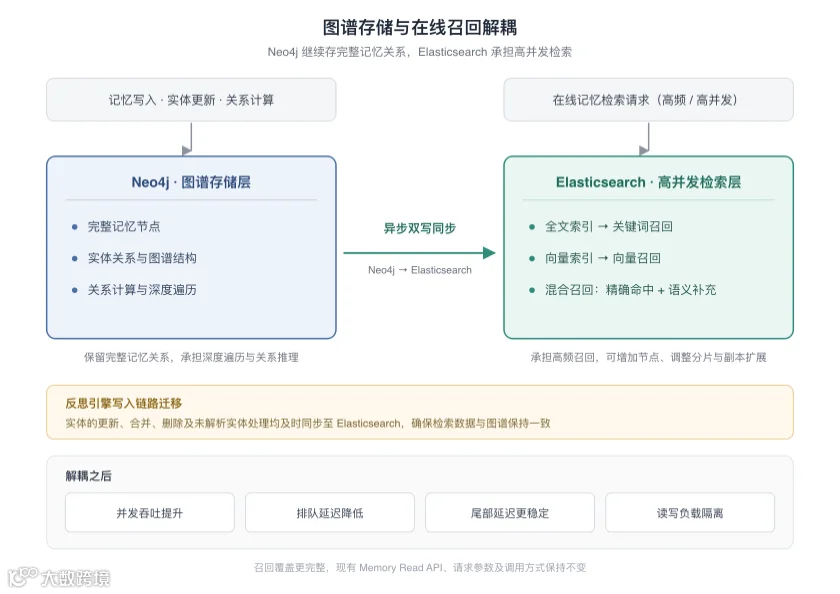
检索链路升级:把记忆存储和检索分开
在这之前,记忆的关系存储和对外查询挤在同一套系统里。这套系统擅长的是把关系理清楚,比如某个客户提到过哪些人、这些人之间又有什么关联,这是记忆的底子,但它算起来偏慢。
于是,v0.4.6 把这两件事拆开了。记忆的关系仍然完整保存在图数据库 Neo4j 里,负责把关系理清楚;对外查询则交给搜索引擎 Elasticsearch,它擅长的正是快速从大量内容中找出匹配项。一边有更新,另一边会同步跟上,两处内容保持一致。
具体改善之处在于:
❖ 查得更快、排队更少:文字匹配和语义匹配同时进行,多种记忆的结果一次批量取回,不用排队干等前面的请求。
❖ 偏慢的请求明显减少:查询不再集中占用关系存储的资源。对线上业务来说,偶尔特别慢往往比整体略慢更伤体验。
❖ 读写互不打扰:查记忆和写记忆、更新关系不再抢同一份资源,查询不拖慢写入,写入也不拖慢查询。
❖ 扩容更省事:以后要提升查询能力,只给检索这一层加机器就行,不必连整套关系计算一起扩容。
❖ 检索到的是新记忆:一条记忆被更新、合并或删除后,会同步到检索这一边,确保取出来的是更新后的内容。
记忆数据接口:读取记忆使用情况
记忆积累起来之后,一个自然的需求是:它到底在怎么被用。写入了多少、读取频率如何、用户关心的话题集中在哪里,以前只能在产品界面里看。v0.4.6 把其中三项开放成对外接口:
◎ 记忆活动查询接口:按空间、用户和时间范围筛选,查询记忆的写入、读取及引擎活动情况。
◎ 热门记忆标签接口:查询指定空间内的热门记忆标签,以及每个标签的出现频次。
◎ 总记忆容量接口:查询指定空间的记忆总量,可按用户进一步筛选。
数据团队可以在内部看板上直接取数、定时刷新,展示新增记忆量、活跃标签与容量占用趋势;热门标签还反映用户实际在关心什么。记忆由此从一个只能“用”的黑盒,变成了可以“观察”的组件。

知识库功能优化:更智能、更好用
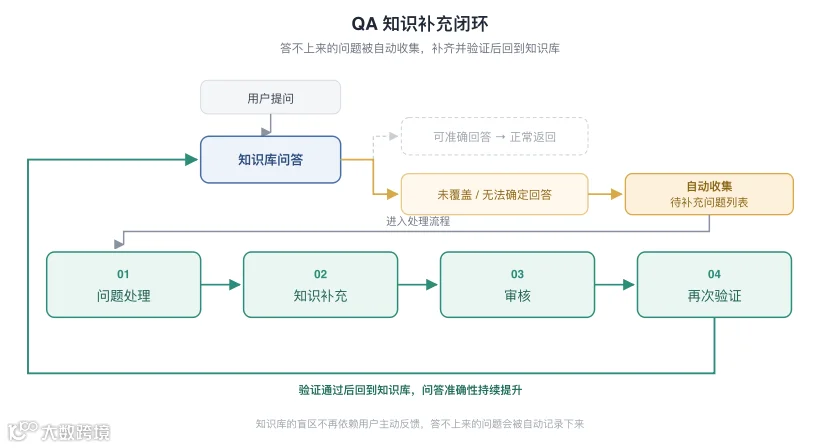
知识库常见的尴尬是:用户问了一个问题,知识库里没有对应内容,回答含糊或者干脆答不上来,而这件事往往没有人知道。
v0.4.6 改善了这一问题,新增 QA 知识补充闭环,自动收集未覆盖或无法确定回答的问题,并支持处理、补充知识、审核与再次验证。这样一来,运营打开待处理列表,看到的就是一份明确的补充清单,不必再靠翻聊天记录去猜。
知识库里的内容常常图文混排,一段说明文字配一张产品截图,或者一张流程图加一段解释。这类内容被切成分块之后,如何检索和排序一直是个难题——图片和文字挤在同一个分块里,哪一部分真正命中了用户的问题,很难分辨。
v0.4.6 的处理方式是采用多模态分块独立检索重排:分块中的文本和图片可以独立参与检索与排序,再汇总返回。文字按文字的方式匹配,图片按图片的方式匹配,各自算分,最后合并成一个结果。同时这次也修复了多项排序相关的问题。

本次还支持复用已有知识库的模型、解析与元数据配置,快速创建一个新的空知识库。复制的只有配置,不含文档、向量与图谱数据,新库与已有库在解析和模型口径上天然对齐。多个知识库联合排序时的评分一致性也得到提升,该项优化仅在显式选择加权重排时生效。
此外,本次更新还有一系列提升系统稳定性与安全性的举措,如并发写入顺序优化、图谱抽取稳定性提升、加强模型凭据存储安全等,对长期运行的生产系统而言十分重要。
回过头看,v0.4.6 的这些更新指向同一个转变:记忆系统不再只是把内容存下来,而是开始主动组织它:
场景感知摘要在对话结束的地方主动做一次沉淀;
检索链路解耦让记忆在并发压力下依然稳定可取;
数据接口开放让使用情况可以被观察和度量;
QA 知识补充闭环让知识库主动暴露盲区并补上。
版本代号“凝识”,取的正是厚积成识的意思:积累只是前提,凝成可用的认识才是目的。后续的投入会继续放在记忆能力的模块化,以及检索、存储层的可扩展性上。
