

导读
本文整理自况雨平(Leo)在 DataFun 2026 深圳站 Agentic AI Summit 超级智能体系统机构峰会上的分享。随着 AI Coding 提升单个研发节点的产出效率,团队进一步关注个人提效如何真正转化为组织交付力。本文重点介绍从 DevOps、BizDevOps 到 VibOps 的演进,以及围绕 Workspace、spec-first、知识沉淀和需求闭环的实践。
1. 生产力之变:AI 让节点更快,交付为何没有同步提速
2. 生产关系之困:AI 提速之后,研发协作关系如何适配
3. 需求闭环之实:VibOps 如何让一个需求真正完成
4. 交付进阶之路:当前实践与下一步演进
01 生产力之变:AI 让节点更快,交付为何没有同步提速
公司的研发协作经历了三个阶段:DevOps 1.0 把分散、线下的发布流程收敛到系统,规范多地区、多套服务的部署;BizDevOps2.0 阶段接入飞书项目管理,让流程可视化,并通过数据推动效能提升。进入 AI 阶段后,VibOps 3.0 阶段解决新的问题:节点更快,协作关系能否同步跟上。
单节点提速,交付周期并未同步缩短
从团队今年的数据看,部分编码环节的代码产出量提升了 2-4 倍,但需求吞吐并不理想。演讲还引用了一组来自国内大厂的公开数据:代码产出率提升 90%、单节点 Coding 效率约 10 倍,整体交付效率却只提升 1.6 倍。企业需求并非在空白画布上做 Demo,还要理解历史规则与约束,考虑架构、组件、接口复用和上下游依赖,并经历 Review、测试、灰度和业务验收。
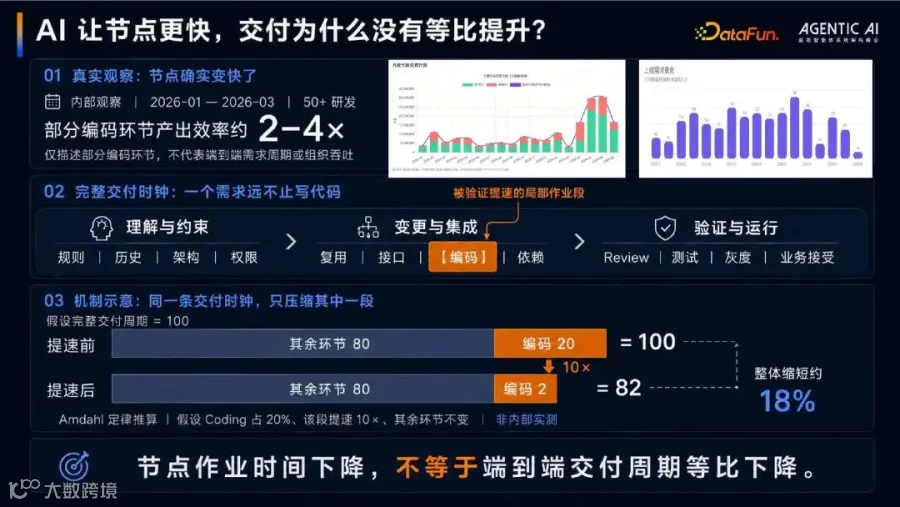
用 Amdahl 定律做了简化示意(非实测数据):若完整交付周期为 100,Coding 占约 20,即使 Coding 提速 10 倍,总周期也只是从 100 降到 82,整体缩短约 18%。因此,节点作业时间下降,不等于端到端交付周期等比下降。AI 可以更快产出需求分析、方案和代码,但也会让原本隐藏的问题更快暴露;需求中的遗留项、历史逻辑、接口影响和依赖仍需持续确认,节省下来的时间很容易重新消耗在等待、上下文重建、返工和重验上。

02 生产关系之困:AI 提速之后,研发协作关系如何适配
编码只占交付周期的约 20%
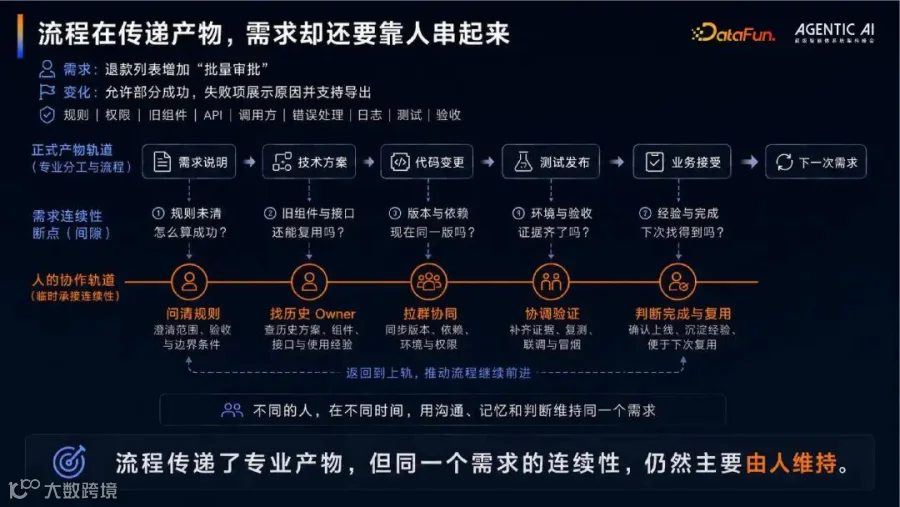
完整交付远不止编码。流程传递的是 PRD、技术方案、代码变更、测试报告等专业产物,但一个需求从澄清到上线,仍要由产品、技术 Owner、研发、测试和业务等角色不断串联。范围、验收边界、历史债务、上下游排期、多端测试和 UAT,都依赖人的沟通、记忆和判断。
协作依托人的持续确认,AI 时代人的注意力成为约束
这里有一个更本质的观察:为什么一个人干活快,一群人干活慢?
一个人高效,不只是因为能力全面,更因为决策与执行没有跨越上下文边界——想、定、做、验在同一个头脑里连续发生。而传统团队里,同一件事的上下文分散在产品、研发、测试、架构、安全、平台各自的手里,每交接一次就要转述一次、重建一次、对齐一次,每次跨越都丢信息、加延迟、生歧义。团队慢,往往不是慢在"做",而是慢在"跨边界传话"。
传统串行研发中,人会在各节点持续确认;AI 放大单节点能力后,需求并发、Agent/Session 和变更频率上升,但人的注意力不会同比增长。结果就是"节点更快,流程却没有明显更快"。可以将其概括为:需求连续性不能再只靠人的注意力。

约束相同,理解各异
企业内部面对的是同一套合规规则、架构规范、依赖、技术栈和发布流程,但不同人对业务的理解、给 AI 的上下文,以及 Agent、Skill 的沉淀方式并不一致,同一需求便可能形成不同理解、方案和结果。团队的解法:把研发流程中的角色围绕"需求"闭环收敛到一个 Workspace,让共同上下文、责任和完成标准在同一空间闭环。企业没法退回"一人公司",但可以把跨人的上下文边界,压成同一个 Workspace 里的连续上下文—需求是统一入口,Workspace 是统一上下文窗口,Evidence 是统一完成语言。

03 需求闭环之实:VibOps 如何让一个需求真正完成
平台能力的分层架构
VibOps 可以从上下两个方向理解:从上到下,是需求从提出到交付所需的能力;从下到上,是企业能力逐步低成本迭代的过程。底层仍是飞书、GitLab、CI/构建、部署、日志和知识库等研发系统;向上通过工具编排接入已有能力,再由 spec-first AI Coding Harness 承载 Context、Execution、Review、Evidence、Knowledge 与 bug-fix 等能力,上层 VibOps 平台统一管理需求、知识、规范、交付和 AI 能力(Skill、Agent、MCP)。
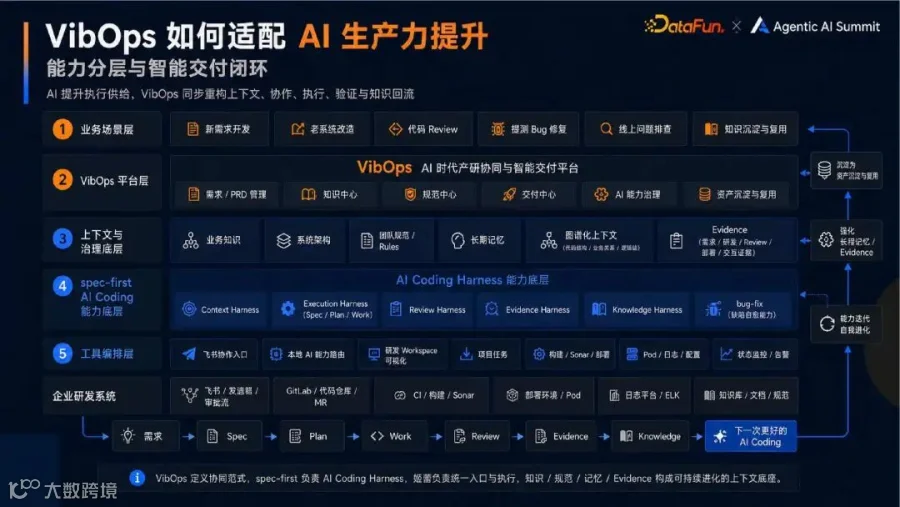
以需求为焦点的 Workspace,让需求闭环在一个上下文窗口
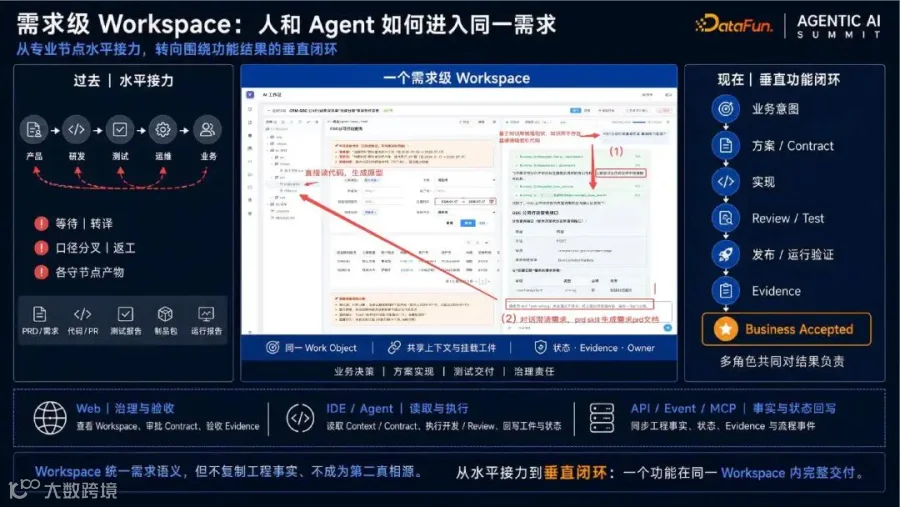
创建一个需求,就是创建一个可运行的 Workspace。团队以需求为 Work Object,用同一个 work_id 连接需求工件、代码仓库与运行状态;Workspace 本身是以需求为维度的 Git 项目,workspace.yaml 记录元数据、流程状态和关联关系,真实源码仍由独立代码仓库 Git 管理。这样,不同角色可以随时重连到同一需求现场。

Workspace 会按需求装配知识、代码、规范、模板、Skill、Agent 与 MCP。产品先通过知识库理解业务,再借助 CodeGraph 聚焦代码和影响范围;研发也前置到需求澄清阶段,并可结合 PRD 模板与 PRD write skill 输出规范化 PRD 和原型。产品、研发、测试、运维以及 Agent 围绕同一 Work Object 工作,从水平接力转向同一 Workspace 内的垂直闭环,形成拥有统一完整的上下文会话窗口。

Workspace 统一的是需求语义和上下文,并不复制工程事实,也不成为第二真相源;代码、Commit、分支和 PR 等真实工程事实仍留在原系统中。
知识库底座:0→1 与 1→N
知识建设先解决 0→1。团队以代码为事实依据,对存量 800 多个应用通过 Zread workflow 反向解读,生成约 12000 份文档导入 FastGPT,并通过 CodeGraph 建立代码向量索引。使用时先定位业务流程,再聚焦到代码;这套能力已用于产品、研发、测试、客服和线上问题排查。
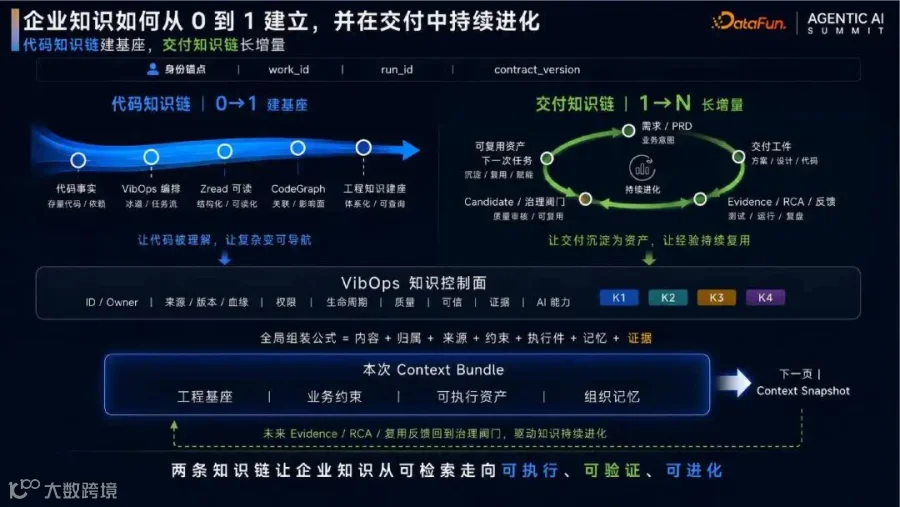
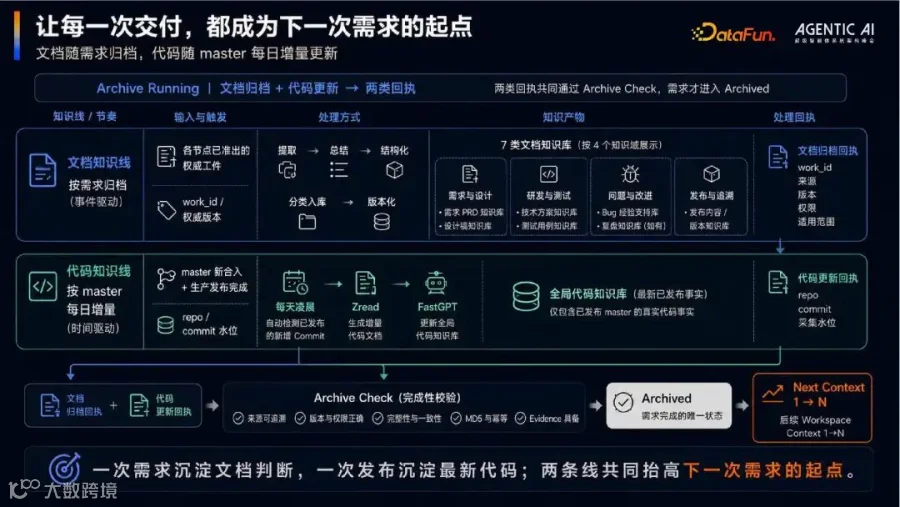
从 1→N,则依靠每次交付继续生长:Workspace 中经过验证的需求、方案、测试、Bug、复盘等过程知识文档回流知识库;master 分支有新代码合入后,代码知识也持续增量更新。一次交付既消费知识,也为下一次需求沉淀可复用资产。
群聊驱动的线下确认
研发过程中,大量变化发生在群聊和会议里。团队通过飞书机器人每 10 分钟拉取群聊内容,对待确认事项和需求变更生成 Checklist,放回 Workspace,由对应节点 Owner 决定是否补充到需求文档、技术方案或接口变更中。只有确认后的内容才进入权威工件,避免“群里确认了、文档却没更新”。

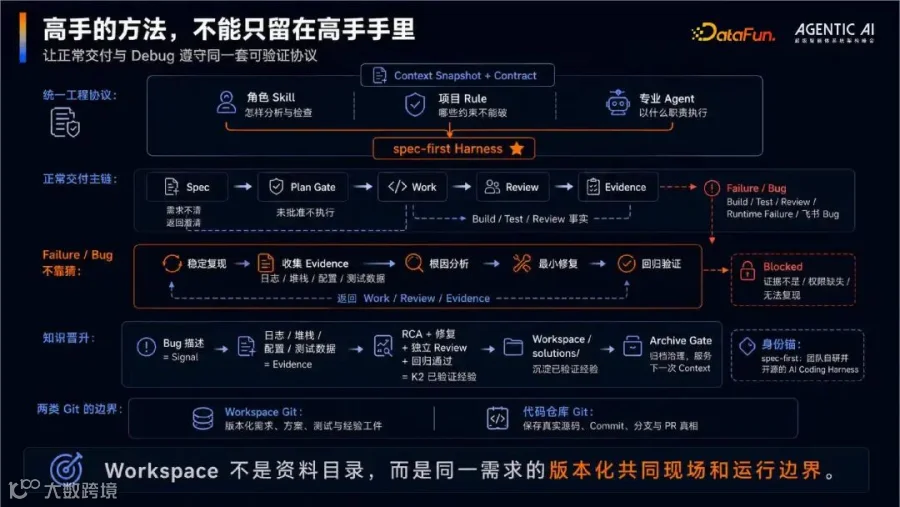
进一步把执行前的上下文固化为 Context Snapshot,并用 Contract 明确目标、范围、验收、Evidence、权限和行动边界。Snapshot 回答"基于哪些事实工作",Contract 回答"获准做什么、怎样算完成、何时必须停"。四个条件同时成立才允许进入执行:事实底座就绪、契约经 Owner 批准、当前状态允许、每个关键节点有具名负责人;出现事实冲突、快照过期、权限不足或验收定义不完整则直接 Blocked,不让 AI 自行补造前提。
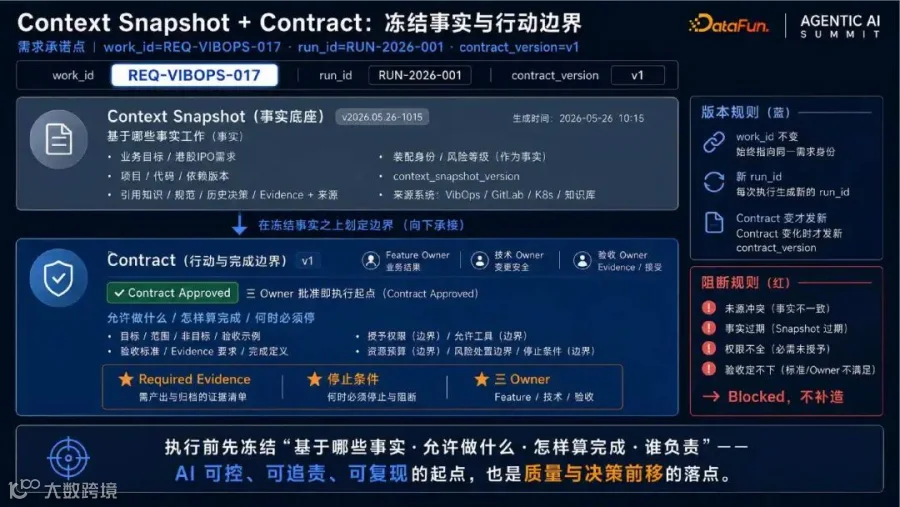
节点流转与 spec-first
每个节点必须由当前 Owner 确认,确认后形成静态版本;后续有变化,可通过版本快速识别并通知。进入研发阶段后,团队把个人经验、规范和重复规则沉淀进 spec-first:先明确 Spec,再经过 Plan、Work、Review 和 Evidence;故障修复则把复现、证据、根因分析、最小修复和回归验证沉淀为经验工件。spec-first 是团队自研并开源的 AI Coding Harness,在这套体系里承担工程协议层的角色。
这套机制带来一个实际的工作节奏变化:白天,人做决策类动作——澄清需求、批准契约、处理 Blocked;夜间,系统在冻结的事实与边界内受控推进,一直跑到 PR Ready 为止。注意是 PR Ready,不是自动合并发布——合并、发布、验收永远留给人。
轻量接入现有研发平台
VibOps 不重做一套研发 devops 系统,而是轻量低成本接入现有流程:通过脚本把已有能力封装成 MCP 服务给 AI 调用,脚本与个人账户态和原有权限体系绑定。AI 负责理解和发起,确定性执行仍落在原平台;对于线上发布等高风险动作,仍必须由人操作,不允许 AI 直接动线上。

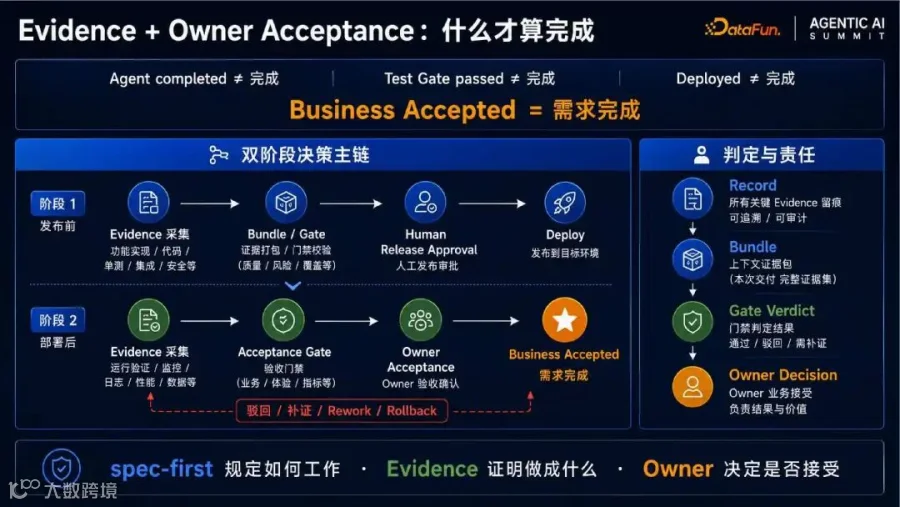
同时,"Agent completed""Test Gate passed"或"Deployed"都不等于需求完成。用 Evidence + Owner Acceptance 定义完成:过程结果要有 Evidence,关键门禁由人确认,最终由 Owner 判断是否接受;只有 Business Accepted,需求才算真正结束。
归档反哺与闭环
完成后还要归档。文档知识线归档已验证的 PRD、技术方案、测试用例、Bug 和复盘等权威工件;代码知识线按 master 分支持续增量更新。两条知识线共同回流,使每一次交付都成为下一次需求的起点,完成知识从 1 到 N 的持续进化。
04 交付进阶之路:当前实践与下一步演进
APP 双端研发
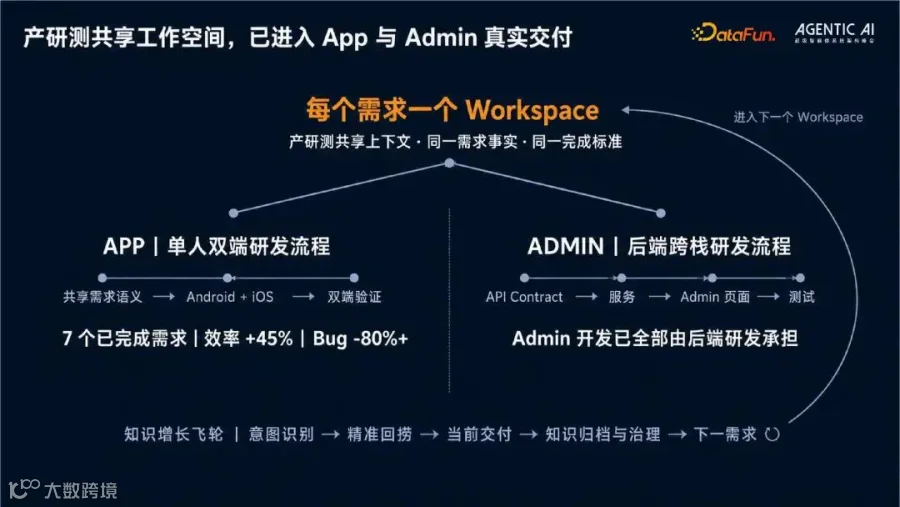
在 APP 场景里,过去 Android、iOS 两端各自出方案和开发,容易出现交互细节不一致;现在把两套代码放进同一个 Workspace,共用一份技术方案。一个端完成后,另一端可让 AI 参考已有实现并遵循自身规范完成对应开发。展示的阶段数据是:7 个已完成需求,效率提升约 45%,Bug 降低 80% +。Admin 场景当前已全部由后端研发承担开发,前端专职角色上移,守框架规范与高风险 Review。
下一步优化方向
下一阶段主要有三条线:一是提升意图识别与精准回捞;二是建设任务看板与多 Agent 协同,在同一 Work Object 下管理依赖、Owner、Gate 和 Evidence,并按需求级别逐步用规则替代部分人工确认,人在环内转变成人在环上;三是用数据看板优化流程,同时关注 token 成本、减少无效上下文。最终发布仍由人执行。
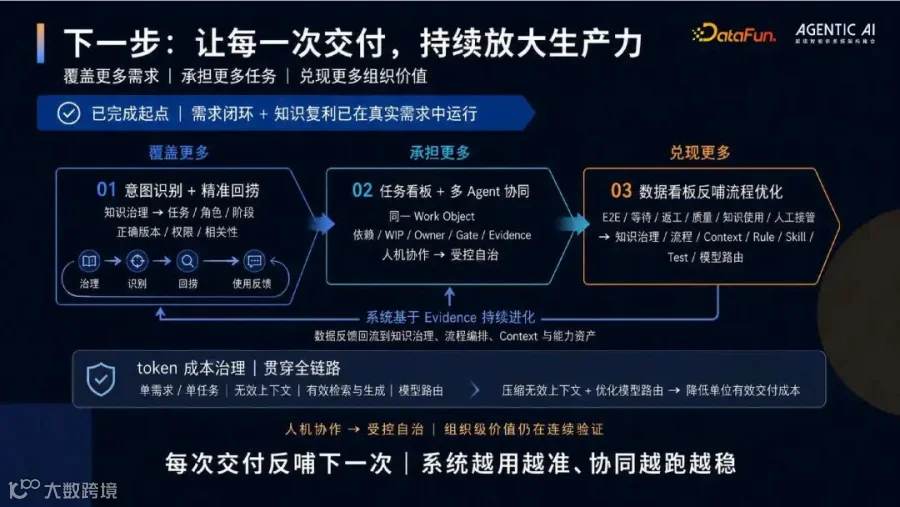
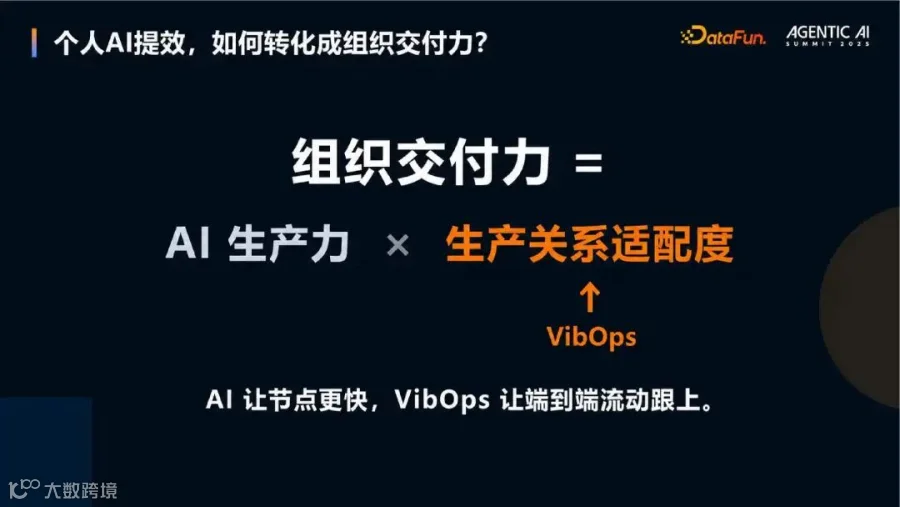
演讲最后回到最初的问题:当某个研发节点的生产力被放大数倍甚至 10 倍以上,原有串行协作中的问题会迅速凸显。用一个公式概括:组织交付力 = AI 生产力 × 生产关系适配度。AI 让节点更快,VibOps 要做的是让上下文、责任、验证和知识同步流动,使个人提效真正转化为组织交付力。
分享嘉宾
INTRODUCTION
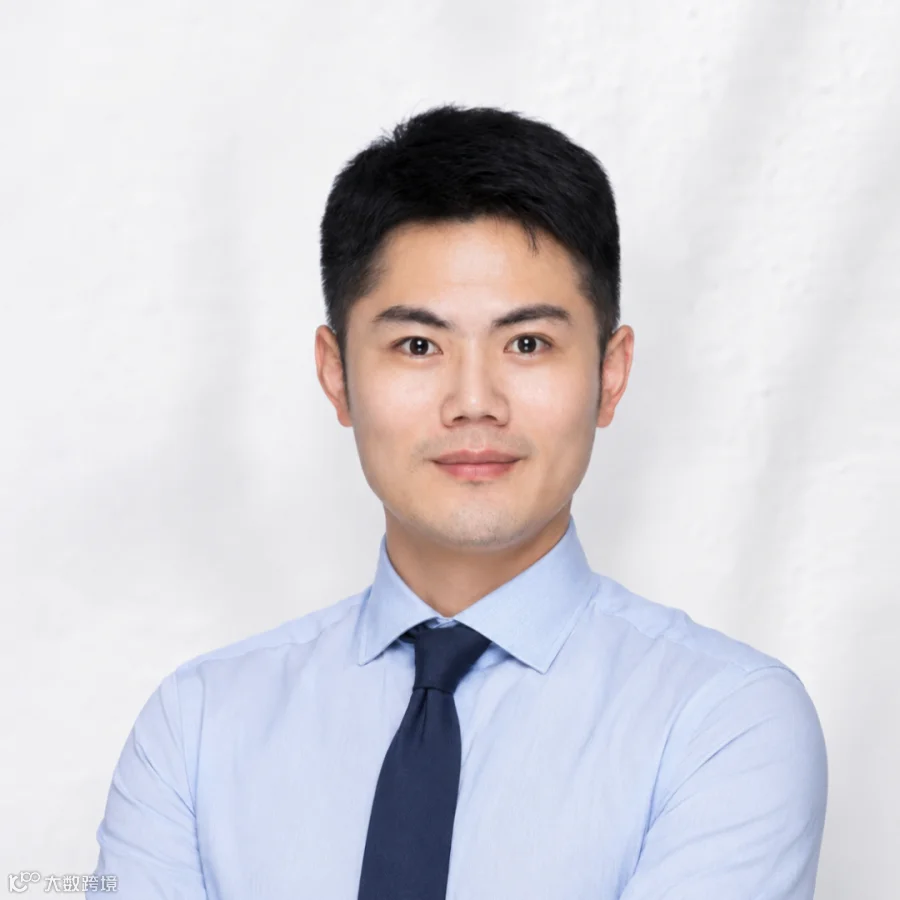
况雨平
深圳价值网络科技
技术总监
2015 年毕业于东华理工大学。现任深圳价值网络科技有限公司(隶属华盛资本集团)技术副总监、部门技术负责人,拥有 11 年金融科技研发与架构经验和 60+ 人团队管理经验,长期负责信贷、证券金融核心系统架构演进,覆盖交易、支付、清结算、金融中台、大前端治理与研发效能体系建设。近年专注 AI 工程化与研发效能变革,开源 spec-first 项目,推动从 TDD 向 SDD 升级,将 AI Coding 融入需求、编码、Review、部署和缺陷回流,相关实践已在技术中心范围使用。

往期推荐
云栖大会|中国数联物流科技总经理:当 Agent 成为数据的新用户!
从“备忘录”到“懂你的人”:QQ AI 伙伴如何解决 AI 的认知记忆难题
第一批把“本体”落地中国的企业,这次集中亮相了!
归因分析与 Agent 工具调用错配!
中国联合航空与中国联通 AI Ready 数据底座最佳实践!
当 Agent 成为数据的新用户,最大的风险点在哪?
国央企验证过的 AI Ready 数据底座,一次讲透!
模型越多越贵、越乱?PPIO 用智能模型网关统一选型、路由与账单
AI/Agent 进入企业数据平台:从可查询到可执行的技术现状
反欺诈知识工程:Shopee 图平台的三层 Ontology 建模实践

点个在看你最好看
SPRING HAS ARRIVED
