商派获得腾讯云企业版 WorkBuddy 代理授权,零售数智化进入"对话即操作"新时代
— 竞技场上的匿名选手,正在成为新的发布通道
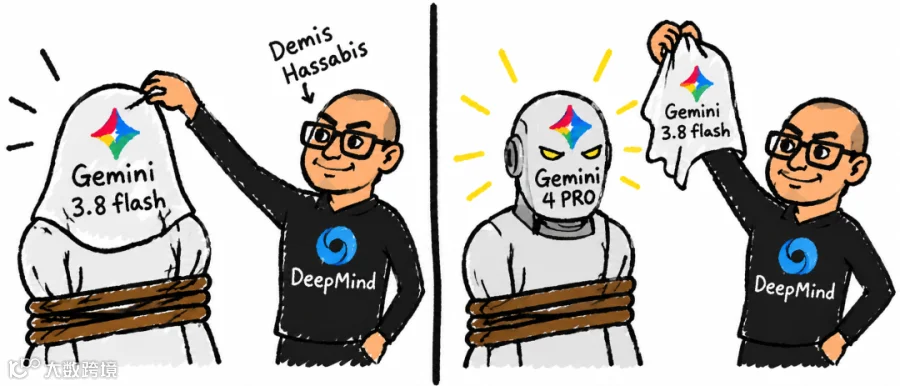
谷歌此次将“深藏不露”演绎到了极致。9 月 17 日,大模型竞技场 Arena 悄然上线名为 gemini-3.8-flash 的新记录。鉴于该型号已于月初正式发布,此次同名模型的二次登场引发业界高度关注。
经多轮实测,开发者普遍推测这并非旧版 Flash,而是谷歌酝酿半年的下一代旗舰 Gemini 4 Pro,正通过“马甲”形式进行灰度测试。
回顾时间线,谷歌上一款 Pro 级模型更新于 2 月,距今已逾 7 个月。原定于 I/O 大会后上线的 Gemini 3.5 Pro 因进化幅度不足被曝取消。然而,谷歌早在 7 月便透露启动了“迄今为止最雄心勃勃的预训练”以打造 Gemini 4。如今,这份野心似乎正以匿名 ID 先行落地。
在公众聚焦榜首微弱优势的同时,榜单背后隐藏的行业信号更值得深思。
本文看点:
01
一行被裁掉的分数
02
RSI 被讲歪了多少
03
从惊艳到交付的距离
THE MASK
一只「小号」的投名状
谷歌为何选择匿名上架?行业共识是“规避风险”:先测真实水平,胜则官宣,败则无痕。但这不仅是避险,更是将互联网产品的 A/B 测试逻辑引入大模型领域。Arena 正从单纯的评测场演变为灰度发布渠道:通过小流量版本让核心开发者挑刺,依据反馈决定正式发布的时机与规格。
这一转变意味着发布从“单向宣布”变为“双向试探”。社区实测成为发布流程中的质检环节,但也导致“发布”概念被稀释,版本号逐渐沦为营销标签而非能力刻度。此次之所以被识破,纯粹是因为撞上了刚发布的同名型号,属于一次不够严谨的伪装。
据部分开发者挖掘的后端信息显示,该模型具备 1000 万 token 输入上限、25.6 万 token 输出上限及永久跨会话记忆等特性,远超 Flash 档位配置。尽管猜测纷纭,谷歌官方至今未对模型身份、成绩及定价作出回应。
THE MISSING ROW
那张疯传的表,藏着一行没人念的分数
全网疯传的基准测试对比图将 Gemini 4 Pro、GPT-6 Astra 等模型并列,显示前者在多项指标上略占上风。然而,解读数据需关注两点:
首先是领先幅度。多项测试中,Gemini 4 Pro 仅领先 1.2 至 1.8 个百分点。考虑到基准测试在采样和脚本上的细微差异即可造成此类波动,这种“领先”更接近并驾齐驱,远非碾压。
其次是反例的存在。在 Terminal-bench 4.0(通用智能体能力)测试中,Gemini 4 Pro 得分为 55.8%,落后 Astra 达 10.6 个百分点。这一关键短板在传播中被刻意忽略。
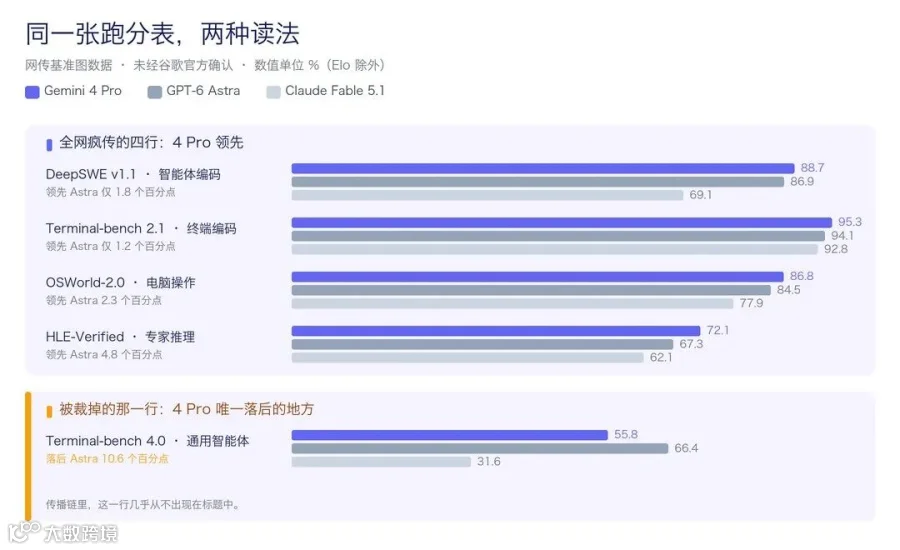
— 同一张跑分表,两种读法:左边是被念出来的四行,右边是被裁掉的那一行
此外,部分测试标注了特定条件(如 partial score),在不同测试条件下横向比较缺乏严谨性。所谓“全面碾压”实则是典型的叙事裁剪:传播链各环节只搬运有利数据,导致反例退出视野。
一张表最能说明问题的,往往是那行没被念出来的分数。
HANDS-ON
比跑分更好看的,是这届模型的「手活」
相较于跑分,实测作品更能反映模型能力的质变。开发者利用新模型快速生成了具有素描质感的创意网页、赛博朋克风格的工作室网站,以及高完成度的 3D 模型(如直升机、卡丁车等)。

— 从一只矢量鹈鹕到一个能跑起来的 3D 场景,难度其实是跳了一级
本轮突破的核心在于“一次提示的完成度”。过往模型虽能生成代码,但常因布局或交互失衡而显得拼凑感强,难以直接交付。如今,模型已能将抽象风格翻译为一组彼此协调的选择,实现视觉主题与交互逻辑的统一。这标志着从“能写代码”到“能出原型”的分水岭,大幅降低了设计师从零搭建骨架的成本。
尽管如此,仍需保持清醒。部分演示作品在整体效果惊艳的同时,仍存在 UI 细节粗糙等问题。“惊艳”与“可用”之间,仍隔着专业审稿人的把关。
THE LOOP
RSI:最好听的故事,也最容易被讲歪
舆论中流传一种观点:Gemini 4 提前完成预训练得益于谷歌 DeepMind 跑通了 RSI(递归自我改进)闭环。若此循环成立,模型升级节奏或将再次加速。然而,拆解已知事实,该叙事存在过度解读:
谷歌高管提及 RSI 是关键投资逻辑,这代表的是战略方向而非既成事实。
官方文档所述“用长时间运行的智能体循环评估打磨模型”,实为工程实践手段,并非"AI 自主进化”。
Dream-RSI 研究的核心在于优化探索策略(如何更聪明地探索),而非改变模型本身(谁来改模型)。
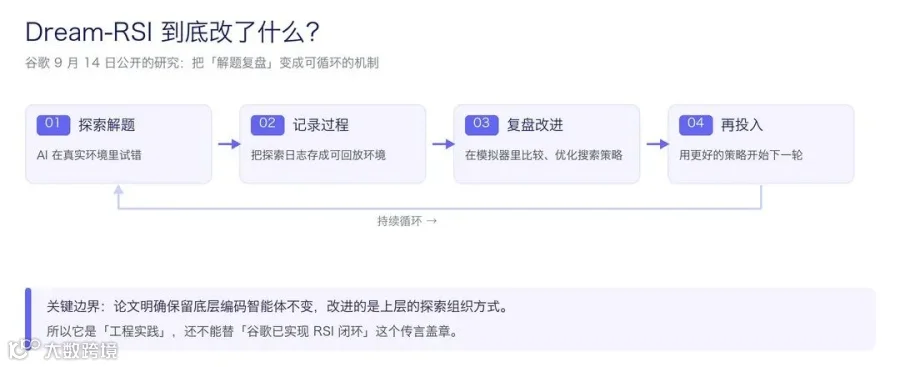
— Dream-RSI 的核心:改的是「怎么探索」,不是「谁来改模型」
将“工程实践”包装成"AI 自我进化”属于叙事通货膨胀。真正的观察信号应是迭代周期是否实质缩短,而非纠结于具体机制。用户关心的是结果效率,而非技术原理。
FROM DEMO TO DELIVERY
从「惊艳一次」到「放心交付」
对于零售、电商及企业数字化从业者而言,模型能力的提升并不自动等同于验证成本的降低。演示验证的是“能力上限”,而生产环境验证的是“稳定下限”,中间的差距往往是最昂贵的部分。
在此阶段,建议重点关注三个维度:
可复现性:在缺乏官方模型卡、API ID 及正式定价前,网传跑分仅作参考,不可作为采购依据。
长任务稳定性:企业应用需确保连续多轮任务不跑偏、能自纠错,这比单次演示的惊艳程度更为关键。
综合单位成本:除 Token 单价外,必须计入返工概率带来的人力成本,这才是真正的账单。
2.25
美元/百万 token 输入
11.25
美元/百万 token 输出
?
返工一次的隐性成本
— 网传定价,未经官方确认;最后一栏才是真正要算的账
— 从「这件做得真好」到「这件事可以交给它」,中间全是验证成本
真正交到你手里的,从来不是榜单上的名次,而是省下来的那些时间。
THE END
牌桌换了,规则也换了
放眼全局,竞争焦点已从“拟人化对话”转向长任务、智能体、代码及推理能力。与此同时,评测体系的公信力正面临挑战:当模型可匿名测试、跑分可被裁剪时,“谁更强”的答案将从“看榜单”转向“看谁能被稳定复现”。
让人惊艳一次靠作品,让人放心交付靠每一次。谷歌此次是底气十足还是试探水温,答案不在被裁剪的表格中,而在后续的官宣节奏里。
END