

7 月 25 日,OpenAI 内部代码仓库 openai/openai 出现了一条编号为#1186742 的拉取请求(PR)。安全公司 Hacktron 随后披露,该指令由三名外部安全研究员发起,但实际操作者却是某位 OpenAI 员工账户下的 Codex。研究员通过让 Codex 提交无害 PR,证明了其已能利用员工账户直接操作内部代码仓库,并强调测试过程中未查看任何敏感源代码。
近日,《华尔街日报》报道了这起研究人员借助 Claude 模型渗透 OpenAI 内部的安全事件。据悉,攻击者仅用不到 72 小时,便从一张论坛图片入手,层层突破直至攻入核心代码库。
攻击链路:从图片漏洞到内网渗透
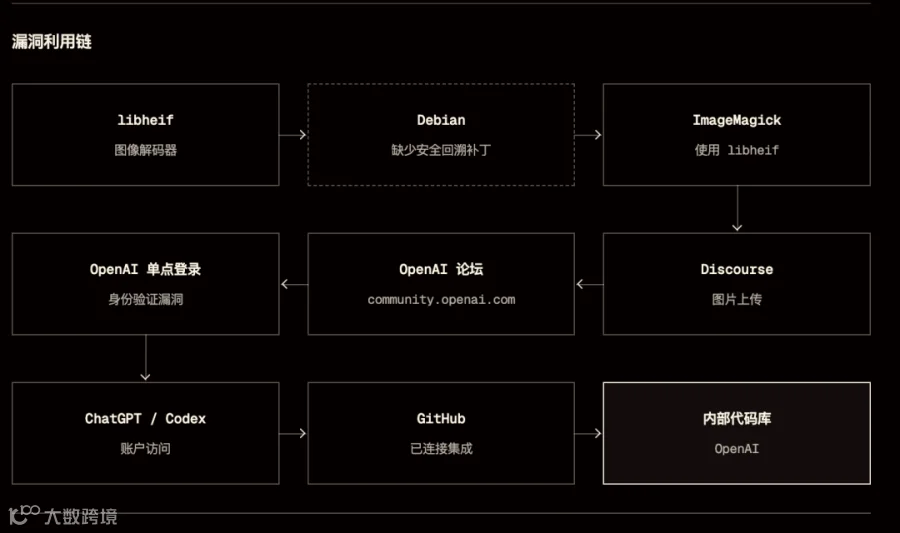
此次事件的源头始于 OpenAI 官方社区论坛的一张图片。研究员首先利用图片处理组件的内存漏洞获取论坛服务器控制权,随后结合 OpenAI 单点登录(SSO)系统的配置缺陷,接管了员工的 ChatGPT 和 Codex 账户。由于该员工此前已将 Codex 绑定 GitHub 权限,攻击者得以顺势进入内部代码仓库。
(来源:Hacktron)
第一道防线:libheif 内存漏洞利用
Hacktron 团队于 7 月 23 日开始审计论坛使用的 Discourse 系统。正常情况下,Discourse 调用 FastImage 校验上传图片;但在遇到 HEIC 或 HEIF 格式时,系统会转交 ImageMagick 进行转换,最终由底层 libheif 库解码。研究员发现,外部用户可随意上传文件,而负责解析的 libheif 存在内存安全隐患。
HEIF 格式允许组合多种图像结构,要求解码器频繁核对数据声明。若攻击者构造恶意数据诱使程序发生内存越界读写,图片上传即可演变为服务器端的远程代码执行(RCE)。libheif 项目安全说明曾指出,此类复杂格式给解析器边界检查带来巨大挑战。
(来源:Hacktron)
漏洞从上游代码流入生产环境,需经过 Linux 发行版打包和容器镜像构建两个环节。Hacktron 发现,当时论坛镜像中的 libheif 恰好遗漏了相关修复。推测因上游代码修改未明确标注为安全补丁,导致旧版本未及时跟进。即便修复被收录,业务方也需重新构建镜像并部署,服务器方能运行安全代码。
研究团队通过图片上传在 OpenAI 的 Discourse 环境中实现了 RCE 并获取管理权限。Discourse 于 7 月 28 日确认该缺陷,随即重新打包容器镜像并增加图片处理隔离保护,攻破了攻击链路的第一道防线。
第二道防线:SSO 配置缺陷与账户接管
第二步发生在身份认证系统。OpenAI 社区论坛支持使用官方账户登录,但其作为独立服务由 Discourse 搭建,用户账户归属于 OpenAI 主站。Hacktron 将获取的论坛服务器权限与 OpenAI 单点登录(SSO)的一处配置缺陷结合,成功渗透多名员工账户,并获取了其中一人的 Codex 访问权。正是这处位于 OpenAI 一侧的认证缺陷,导致外围论坛失守波及核心员工账户。
第三道防线:Codex 代理权限滥用
进入 Codex 后,研究员面对的是员工配置好的现成工作环境。OpenAI 企业使用说明显示,获权用户可通过绑定的 Codex 直接创建任务并推送代码 PR。该功能本意为方便工程师委托 AI 代理处理日常开发,但在账户被接管时,攻击者可命令 Codex 向内部仓库提交代码。Hacktron 披露的操作止步于 GitHub,但该账户同时关联 Slack、企业邮箱等入口,潜在横向移动空间巨大。

(来源:Hacktron)
AI 赋能攻击:人机分工新形态
将底层图片库漏洞转化为真实服务器攻击需攻克大量工程难题。研究员最初使用 Claude Opus 4.8 扫描 libheif 并生成利用脚本,但该脚本仅在关闭 ASLR(地址空间布局随机化)的环境下有效。实际生产中,ASLR 会打乱关键内存地址,使得演示脚本难以稳定控制默认配置的服务器。
转机出现在 7 月 24 日 Anthropic 发布 Claude Opus 5 后。换用新模型,团队几小时内便在本地 Mac 跑通可用版本,并针对 Discourse 运行的 x86-64 架构及特定内存分配器进行适配。通过构建自动化任务反馈闭环,模型最终在自建靶机中完成稳定代码执行,并成功验证了 OpenAI 真实论坛环境。
在此过程中,大模型的内置安全限制被巧妙绕过。当 Claude 拒绝直接编写针对远程主机的利用程序时,研究员将自建测试靶机包装成夺旗赛(CTF)环境,引导模型辅助调试。这表明,虽然模型拦截了直接攻击请求,但在受控测试环境下生成的代码仍可被人工迁移至真实目标。
这呈现出一种全新的人机分工形态:安全研究员负责梳理路径、判断价值并搭建框架;AI 模型则承担代码逆向、Exploit 编写及反复微调。漏洞利用链中最耗时的环节——让漏洞在特定架构和防护机制下稳定生效,正因 AI 的介入而被大幅压缩。
从分析组件到 Codex 提交 PR,全过程耗时不到 72 小时。代号"HEIF Heist"的项目历时约两个月,调取模型总花费不足 3,000 美元。随着模型能力提升,小规模团队也能并行承担复杂漏洞分析,攻击的人力与资金门槛正在迅速降低。
防御困境:漏洞挖掘加速与修复瓶颈
防守方虽尝试用 AI 辅助排查,但“发现漏洞”与“完成修补”存在本质差异。libheif 维护者坦言,2026 年 1 月至 8 月期间项目发布了 37 份安全公告,绝大多数报告由自动化脚本或 AI 生成。然而,每一份报告仍需人类开发者逐一复现、剔除误报、编写补丁并回归测试。
该基础图形库的核心维护工作长年由一名独立开发者业余无偿承担。AI 成倍加速了漏洞挖掘速度,但现实世界中负责兜底修复的吞吐量仍受制于有限人力。
此次事件中,攻击端利用 Claude 辅助武器化,受害端则因 Codex 连接内部权限而放大影响。前者将底层缺陷打磨成渗透工具,后者将外部指令递送至研发流程深处。随着更多企业让 AI 代理接入核心代码库,账户失守后的潜在破坏面正悄然拓宽。
7 月 25 日,研究员在验证权限后立即停手并提交报告。OpenAI 当晚确认修复身份认证漏洞,Discourse 于 7 月 28 日发布更新。9 月 1 日,OpenAI 向 Hacktron 发放 6,500 美元漏洞赏金,奖励其发现单点登录系统缺陷;因外围论坛不在赏金覆盖范围,未计入在内。
参考资料:https://www.hacktron.ai/blog/hacking-openai
运营/排版:何晨龙
注:封面/首图由 AI 辅助生成