

Jev 开启了 Agent 分层的新范式。过去两年所有人都在写同一种 agent:一个强模型,加一堆 prompt,加工具循环,再配上各种 harness、loop 工程。该不该调这个工具、这请求有没有风险、该用哪个模型、输出对不对,全塞进同一个上下文,让它自己想。
这种范式在 demo 阶段无敌,上生产撞三堵墙:慢、贵、说不清为什么。

现在是一坨,该拆成生成层、规则层和一堆小的判断层;不确定的甩给人(图源:@aigclink 推文配图)
01判断和生成是两种事
判断要的是固定选项、可校准的概率、能调的阈值、能画的 ROC。生成模型给你的是一段"我觉得这个操作有风险,建议人工确认",除了照办,无法量化。
老板问你幻觉和误杀率多少?prompt 里没有这个指标。
正在发生的迁移是:单体 agent → 生成层 + 一堆小决策器。跟当年 PHP 单体拆成网关、鉴权、限流,是同一个剧本。
02Jev 的接口长什么样
上一篇讲过 Jev 只做选择题。翻了它的文档,接口比想象的还简单:一个 state(任意文本或程序状态),一组 questions,三种题型可以混在一次调用里,并行、互相隔离地对同一个 state 求值,多加问题几乎不增加响应时间。
- ▪Choice
:从列表里选一个,返回选项、每个选项的概率、confidence - ▪Score
:按有序的描述性等级打分,返回分数、每级概率、confidence - ▪Noul
:这句话是真的吗,返回 0 到 1 的一个数
官方 quickstart 的例子是一张客服工单,一次问三件事:转哪个部门、客户多生气、是不是紧急。返回里部门选了 billing,概率 0.84,但 confidence 只有 0.596。confidence 不等于最高那个选项的概率,它是从整个概率分布的形状算出来的,分布越平越低。文档也说你不必用它的定义,完整概率都给你了,可以自己算。
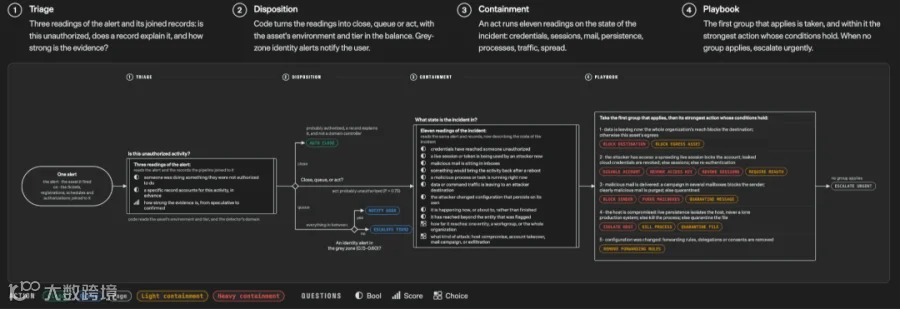
官方博客里的安全告警工作流:分诊、处置、遏制、剧本四步,每步都是布尔、打分、选择三类小问题,分支逻辑写在代码里(图源:TypeSafe 博客)
文档里有一句设计原则值得抄下来:每个问题只问一件具体的事,相当于一个懂行的人看几秒钟就能拍板的判断。要权衡多个因素的,拆开分别问,在代码里用你自己的公式合起来。优先级变了,改代码里一个系数,不用重写 prompt。
03要开始用,三步

三步落地:标判断点、定标签和代价、三态输出;阈值跟着风险走
1. 把你 agent 里所有判断点标出来。 工具授权、模型路由、内容准入、结果验证。凡是现在靠 prompt 里一句"请谨慎判断是否……"撑着的地方,都是。
2. 每个判断点定义:标签集、阈值、两类误判各自的代价。 拦错多疼、放错多疼,自己定那根线。官方文档的说法是阈值不是一个数,同一个系统里不同动作该卡在不同水位:
action = response.answers["action"] confidence = action.confidence if confidence < 0.5: route_to_human(user_message) # 模型真的没把握,别猜 elif action.choice == "check_balance": show_balance(account_id) # 低风险,错了能挽回 elif action.choice == "approve_transfer": if confidence > 0.9: confirm_then_execute(account_id) # 高风险高把握,确认后执行 else: ask_user_to_confirm(account_id) # 高风险中等把握,先核实
风险容忍度写在代码里,能版本管理,出事能翻到哪一行。
3. 三个状态:PASS / FAIL / 不确定。 别让模型在没把握的时候硬猜,把不确定导给人。官方的三段式是高置信自动执行、中置信谨慎推进(让用户确认、标记复核、补信息)、低置信不动手。人判完的那条,就是一条标好的数据。
04提醒几句
小模型专职判断不是新东西。 传统 NLP 干了十几年,只是最近这两年被 LLM 的光盖住了。真正难的从来不是模型,是标注和调阈值:幻觉或者误杀率 3% 在 demo 里没感觉,在生产里就是每天几十个投诉。
这层会让系统更复杂,不会更简单。 只有当你的 agent 真在替人做有后果的事时,才值得加。
Jev 自己也有毛边。 官方文档专门有一页列了 jev-1.13 的 9 个已知失败模式,9 月 17 日更新的:
- ▪
字面理解:它回答你写的问题,不是你心里想的。范围词、否定、隐含条件都按字面读 - ▪
数数、算术、数值表示:不会可靠地计数,别让它比较十六进制色值,算术留在代码里 - ▪
日期时间比较:先抽出组件,在代码里比 - ▪
间接推理:多跳的减少跳数,直接指到相关 state - ▪
大而杂的 state:先过滤,只送问题需要的部分 - ▪
对抗性内容、自相矛盾的指令和标准、常识性结构不变量 - ▪
生成:用生成模型

昨天那篇用过的官方图:结构化输出和工具调用错误率。Jev 的 0% 是构造保证,LLM 这边从 0.58% 到 45.5% 不等(图源:TypeSafe 博客)
这一页反过来也说明了分层该怎么分:算术、计数、日期、格式校验归代码;语义判断归 Jev 这类决策器;写东西、长推理归大模型。
最后是账。 demo 类的 agent 不需要这一层,生产级 agent 需要,但要在成本和带来的结果提升上找平衡点。如果为了 1% 的提升花一倍的成本去调这个,老板未必会同意。
难的从来不是模型,是标数据和调那根线。拆完系统会更复杂,只有 agent 真在替人干有后果的事,才值得拆。
项目地址TypeSafe 文档:https://docs.typesafe.ai/Confidence 一页:https://docs.typesafe.ai/confidencejev-1.13 已知毛边:https://docs.typesafe.ai/model-jaggedness/jev-1.13官方博客:https://typesafe.ai/blog/introducing-system-one-models-and-jev

