
前言

过去几年,AI 的默认形态是“聊天机器人”:你说一句话,它回一段话。
ChatGPT、Claude 莫不如此。聊天体验确实惊艳,但当开发者想把 AI 嵌进软件里做自动化时,问题来了:软件需要的是决策,不是作文。
想象一个客服系统:一条用户消息进来,程序需要判断,这条消息紧急吗?该分给哪个团队?客户有多生气?这些判断只需要一个明确的答案,但大模型会给你写一段分析,然后程序还得费劲从文字里抠结论,还可能抠错。
2026 年 9 月,前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 给出了一个反常识的答案:做一个不会聊天的 AI。
它不写小作文,不解释推理,甚至连一句完整的话都不说。你丢给它一个问题,它只回一个数字,但恰恰是这个数字,可能让 AI 从 “聊天玩具” 变成软件里真正能跑的决策引擎。
它叫 Jev,来自前 OpenAI 研究员创办的 TypeSafe AI。
今天我们就用最简单的话,讲清楚这个 “不会聊天的 AI” 到底是什么、怎么工作,以及社区已经拿它干了哪些有意思的事,当然最后也会给大家推荐如何在 TraeCode 中使用~
Jev 是什么:不生成文本的决策模型
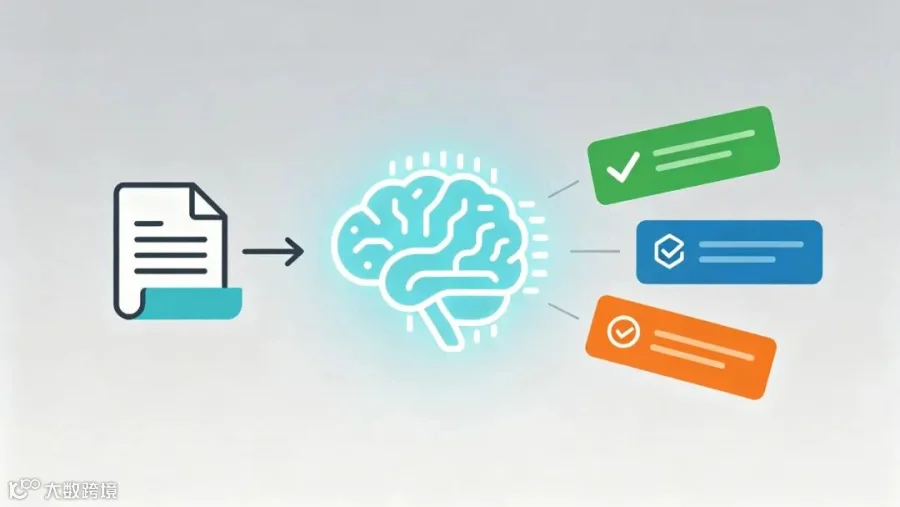
Jev 的核心模式:输入状态 → 并行决策 → 结构化输出
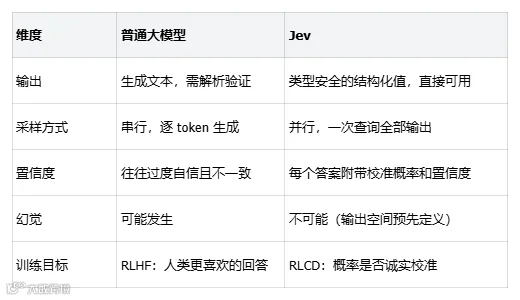
普通大模型 vs Jev
还是用客服工单的例子。
用户发来一条消息:"救命!打款连续 3 天失败了,请尽快处理!"
普通大模型 的回答可能是:“根据消息内容分析,客户提到了“连续3天失败” 和 “请尽快处理”,表达了较强的紧迫感,因此可以判断这条消息是紧急的。建议优先处理……”,然后程序得用正则或解析器从这段文字里把“紧急”这个结论提取出来,万一大模型今天写了“比较紧急”,解析代码直接挂掉。
Jev 的回答是:{"noul": 0.92}:92% 的概率是紧急的。
没有废话,没有小作文,程序拿来就能用。
System One Model 的含义
TypeSafe 把 Jev 称为 System One Model,名字来自卡尼曼《思考,快与慢》:System 1 是快速直觉判断(一眼看出"这个人很生气"),System 2 是缓慢审慎推理(算 17×24)。
大模型偏 System 2,Jev 专做 System 1,分类、路由、评分、判断这些需要语义直觉但不需要长篇大论的决策点。
名字本身也有讲究:Jev 来自经济学家 William Stanley Jevons,他提出了“杰文斯悖论”,蒸汽机效率提高后,煤炭消耗量反而上升,因为更便宜的能源创造了全新用途。
TypeSafe 的赌注是:当一次决策的成本降到可以忽略不计,开发者会把 AI 用在以前绝不会考虑的地方。

为什么需要 Jev:大模型做决策的三个问题
大模型不是也能输出 JSON 吗?
为什么还要整个新模型?
因为大模型是为聊天设计的,用它做决策有三个结构性问题:
慢。大模型逐 token 生成,哪怕输出一个简单 JSON 也要生成括号、引号、字段名、枚举值……需要 150~500 次顺序计算,耗时 3~300 秒。聊天场景人能等,程序里等不了:客服系统不可能让用户等 30 秒才分派工单。
脆弱。本质上还是在生成文本,加了约束也可能生成不符合 schema 的值、输出被截断、或编出不存在的字段。零样本无约束生成的格式错误率可达 38%。
不知道自己不知道。大模型往往过度自信,说“99% 确定”但答案是错的。如果模型永远不告诉你什么时候它在那 5% 的错误里,你就永远需要人工兜底,自动化无从谈起。
工作原理:并行约束解码
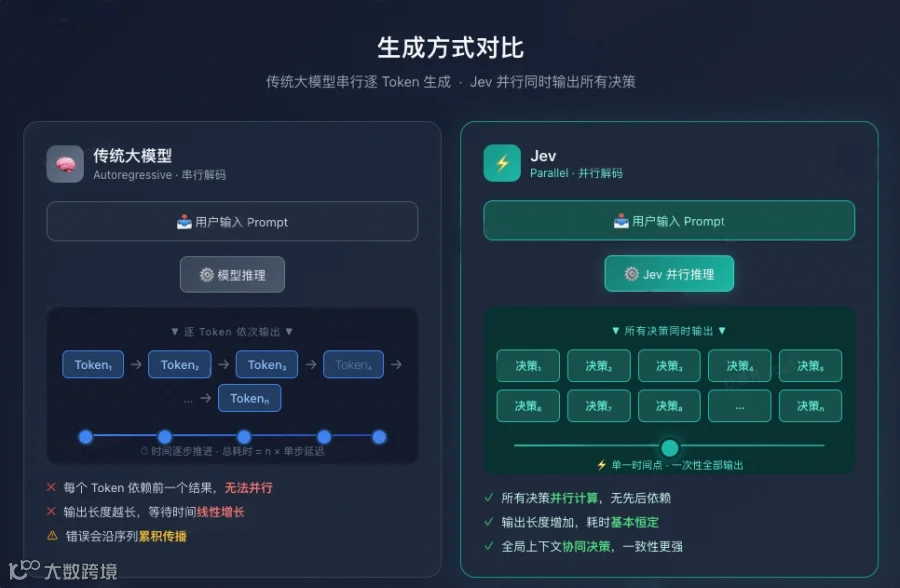
传统方式:一个一个来
继续用客服工单的例子。
假设要根据消息判断三个字段:紧急程度(是/否)、分派团队(账单/技术/销售)、客户情绪(平静/不满/愤怒)。
普通大模型会把它们拼成 JSON,然后一个 token 一个 token 地生成:{ → "urgent" → : → true → , → …… 每一步依赖上一步,像多米诺骨牌,必须一块倒了下一块才能倒。
Jev 方式:一起上
Jev 用并行约束解码(Parallel Constrained Decoding),分两步:
第一步 Prefill(预填充):用 Transformer 模型一次性读完所有输入(用户消息 + 三个问题的定义),缓存计算中产生的 KV cache(“记忆”)。就像考试前先把题目和资料通读一遍,形成整体印象。
第二步 并行评分:对每个字段,将缓存的“记忆”和字段名一起喂给模型,得到理解向量,通过打分层算出词表得分,然后只看该字段允许的选项(比如“分派团队”只看账单 / 技术 / 销售三个词),做 softmax 得到概率分布,取最高者为答案。
怎么用:三种原语
跟 Jev 交互很简单:给一个 state(当前状态,文本或 JSON)和一组 questions,返回每个问题的答案。问题只有三种类型,我们继续用客服工单的例子来演示。
Noul:是 / 否判断
返回 0~1 的概率 noul,越接近 1 越肯定“是”。适合判断“这条消息是否紧急”、“是否要求退款”、“是否包含辱骂”等二元问题。
{"state": "救命!打款连续3天失败了,请尽快处理。","type": "noul","instructions": "这条消息是否表达了紧急性?"}
{ "type": "noul", "noul": 0.92 }Choice:多选一
用 criteria 定义每个选项含义。返回选中项 choice、各选项概率 probabilities、整体置信度 confidence。
适合工单分派、内容分类、路由选择等。
{"state": "客户反馈支付接口报错,无法付款。","type": "choice","instructions": "这条工单该交给哪个团队?","criteria": {"billing": "支付、账单、退款问题","technical": "Bug、故障、集成问题","sales": "价格、升级、新账号咨询"}}
{"type": "choice","choice": "technical","probabilities": { "billing": 0.08, "technical": 0.85, "sales": 0.07 },"confidence": 0.82}
Score:等级打分
criteria 是按顺序排列的等级说明(2~10 个)。返回连续分数 score(概率加权结果,可能落在两等级之间)、等级说明 legend、概率分布、置信度。适合情绪评分、风险分级、质量打分等。
{"state": "等了三天还没人解决,你们到底什么时候处理?","type": "score","instructions": "客户现在有多生气?","criteria": ["平静", "不满", "非常生气"]}
{"type": "score","score": 1.6,"legend": { "0": "平静", "1": "不满", "2": "非常生气" },"probabilities": { "0": 0.05, "1": 0.30, "2": 0.65 },"confidence": 0.78}

社区实践:大家已经在用 Jev 做什么呢

Jev 社区应用生态:从游戏到浏览器 Agent,从编码助手到运维风控
Jev 发布仅几天,社区已经涌现出大量有趣的应用。以下是一些有代表性的实践:
游戏与实时决策
Doom 游戏 AI(官方 Demo):TypeSafe 官方展示了用 Jev 玩 Doom 的 demo,每秒做出 10 次决策(移动、射击、转向),成本约 $7/小时。开发者原本担心 10 QPS 太贵,结果大家一致认为比预期便宜得多。这展示了亚秒级决策能做到什么——AI 可以像人类玩家一样实时反应。
StarCraft 星际争霸(phyous/tsai-sc):社区开发者用 Jev 完成了星际争霸第一个共享软件任务,全程 421 个决策,附带验证报告。每个决策点 Jev 从有限选项中选择行动,代码负责控制流和安全校验。

浏览器 Agent
Browser Use 动态动作空间(Gregor Zunic):Browser Use 的作者构建了一个用 Jev 做动态索引动作空间的浏览器 Agent。传统浏览器 Agent 每步都要让大模型看整个页面、生成点击指令,慢且贵。Jev 的做法是:把页面元素索引化,每步只让 Jev 从候选元素中选一个点击,大幅提速。
Jev Ultrafast(browser-use 开源参考):用 Jev 完成一次真实的 Google Flights 搜索(苏黎世→伦敦,2026年9月20日),端到端仅 7 , 073 毫秒——包括模型推理、文本生成、浏览器操作的全部时间。
Jev Browser(Vlad Terin):为 OpenAI Codex 打造的导航工具适配器。分工很明确:Codex 负责一次性规划任务,Jev 负责每一步选择点击哪个页面元素,处理大页面时最多并行 6 次请求。
编码助手与 Agent 基础设施
Jev-router(gargpratyush/Jev-router):为 Claude Code 和 OpenAI Codex 做自动模型路由。简单任务(查找、提取、局部修改)走快速便宜的模型,复杂任务(架构设计、高风险决策)走强力模型。Jev 在每轮对话前判断任务复杂度,选择最合适的模型,保留各 CLI 的原生接口和权限。
Jev + Pi(shell 命令概率门控):为 Pi 编码 Agent 的 shell 命令加了一层安全门。规则先匹配已知模式(rm -rf 直接拦截),未匹配的命令交给 Jev 判断"这条命令是否可逆/是否有破坏性",概率超过阈值才允许执行。
LangChain 官方集成:LangChain 发布了 Jev Harness,内置 ModelRouterMiddleware——用 Jev 做模型路由中间件,开发者定义不同模型的能力描述和选择标准,Jev 自动选择成本最低且能完成任务的模型。
运维、风控与生产系统
安全告警分诊:TypeSafe 官方评测任务之一。将 CloudWatch 告警(服务名、指标、阈值、环境等信息)输入 Jev,判断该告警应"关闭""升级"还是"遏制"。传统做法是人工 on-call 逐条判断,Jev 可以在 100ms 内给出带置信度的建议,低置信度的才转人工。
供应商发票处理:判断一张发票是"已支付""扣留"还是"退回"。输入发票内容和上下文,Jev 输出决策和概率,财务系统据此自动流转。
客服质量审核:批量审核客服 Agent 的对话轨迹,判断哪些需要人工复核。可以同时问"回复是否准确""态度是否友好""是否需要升级"等多个问题,一次调用完成。
社区工具与生态
Jev.directory:社区驱动的 Jev primitives 共享平台。开发者可以浏览真实系统中使用的 Jev 问题定义,复制到 Playground 试用,或用 GitHub 登录分享自己的。目前已有 shadcn lint 检查、客服工单分诊等实际案例。
多语言 SDK:官方提供 Python 和 JS SDK,社区已贡献 Elixir 客户端(hex.pm 上的 Jev 包),支持 Noul/Choice/Score 三种原语的声明式定义。
awesome-typesafe(AbdelStark):社区维护的生态索引,整理所有 Jev 相关项目,并标注哪些结果基于私有数据或单次运行,帮助开发者甄别信息可靠性。
性能、成本与局限
性能与成本

官方标题数字是“193.6 倍更快、444.6 倍更便宜”,属评测上限,实际因输入长度而异。准确率约 67%,与 GPT-5.6 Luna 相当。训练方法为自研的 RLCD(校准决策强化学习),优化目标是“概率是否诚实”,如果模型对 100 个答案都给出 90% 概率,其中应约有 90 个正确。
局限性
不能生成文本、代码、摘要,也不解释推理——需要文本时仍用大模型。
只支持文本输入,不支持图片/音频/视频。
上下文约 64K tokens(state + 所有 questions 共享);Choice 最多 255 选项,Score 2~10 等级。
0% 类型错误只保证格式合法,不保证决策正确——低置信度时仍需人工或更重模型兜底。
目前为早期访问(waitlist-only),服务主要在美西,可以使用 Vercel GateWay 体验速度慢些

如何在 TraeCode 内用 Jev?
那上面讲了这么多,大家肯定希望能快速体验,当前最合适的方式是接入官方 Skill,这个 Skill 已经可以让现有 Coding Agent 帮你接入Jev,但要让现有 Agent 自身用 Jev 控制执行,需要修改 Harness或把 Jev 封装成 Tool,并不是装完 Skill 就自动生效。
这个 Skill 不会把 Agent 的主模型替换成 Jev,它会教 Agent 如何把 Jev API 集成到项目或 Harness 中,作为路由器、Judge、Verifier 等决策组件。
安装方式
执行下面的命令:
npx skills add typesafe-ai/skills --skill typesafe-ai安装时选择对应 Agent。默认安装到当前项目,加 -g 可全局安装。
然后配置 API Key,记得把这个 key 的环境变量设置到 ~/.zshrc 或者 ~/.bashrc
export TYPESAFE_API_KEY="..."再对 Agent 说:
Use the TypeSafe skill. Analyze this project and identify where Jevcould replace LLM-based routing, completion judgment, or verification.Run experiments before changing the implementation.
Agent 读取 Skill 后,会知道:
如何调用 Jev API;
如何定义 Noul / Choice / Score
如何设计 atomic questions
如何设置置信度门槛
如何实现 confidence-gated routing、并行判断等模式
如何使用 Python/TypeScript SDK 修改你的代码
典型架构会变成:
Trae Agent↓生成与长程规划↓调用 Jev API 做快速判断↓工具路由 / 完成判断 / 风险门控 / 验证
要让“当前 Agent 运行时”真正使用 Jev,需要满足以下之一:
Agent 修改当前项目代码,通过 TypeSafe SDK 调用 Jev
把 Jev 封装成 Tool / MCP,再允许 Agent 调用
3.直接修改 Harness,在 tool selection、continue/stop、model routing 等节点嵌入 Jev
接入 TraeCode 最合适的方式
其实也是一样的思路,推荐大家把 Jev 作为 MCP 工具而非主模型去使用。
当然,社区实现的 MCP 工具(非官方)也可以直接使用,是已经封装好了的,给大家推荐几个,你们可以在 TraeCode 中安装。
|
项目 |
定位 |
推荐场景 |
|
itsmostafa/typesafe-mcp |
通用、轻量, 只暴露一个 evaluate 工具 |
最适合研究 Harness 接入 |
|
jkudish/Jev-mcp |
封装成 verify/screen/find 三个高层工具 |
事实核验、注入检测、语义召回 |
|
blakestone-x/Jev-mcp |
工具最全:ask/classify/score/check/match/screen |
直接给 Agent 使用、快速实验 |
需要注意的是,这些 MCP 都只是让主 Agent“可以主动调用 Jev”,调用路径是:
主 Agent → MCP Tool Call → Jev API → 概率结果 → 主 Agent决定下一步它还不是 Harness 级接管。主 Agent可能:
不调用 MCP
调用时问题定义得不好
拿到概率后没有严格执行阈值
把 Jev 结果当作绝对事实
如果你想验证 Jev 对 Agent 效果的真实价值,我们建议:
先用 typesafe-mcp/evaluate 做显式 Tool;
固定三个场景:完成判断、工具路由、风险门控;
在 System Prompt 中规定何时必须调用;
最终把验证有效的节点下沉到 Harness,而不是依赖 Agent 自觉调用。
⚠️ 目前社区项目非常新、Star 和生产验证都较少,适合实验,不建议未经评测直接作为安全边界。
总结:从聊天到决策

Jev 的核心命题是:不是所有 AI 都需要聊天。
软件中大量决策点需要的不是优美文字,而是快速、可靠、带置信度的判断。把这些决策从大模型中剥离,交给专门优化的 System One Model,可能是 AI 从“演示品”走向“生产基础设施”的关键一步。
社区已经在验证这个方向:Doom 里的实时游戏 AI、7 毫秒完成的航班搜索、自动路由的编码助手、批量分诊的安全告警……当一次语义判断的成本降到可以忽略不计,开发者会把它用在以前绝不会考虑 AI 的地方。
这就是 Jev 名字背后的杰文斯悖论式赌注:更便宜的智能,会创造出全新的智能用途。