

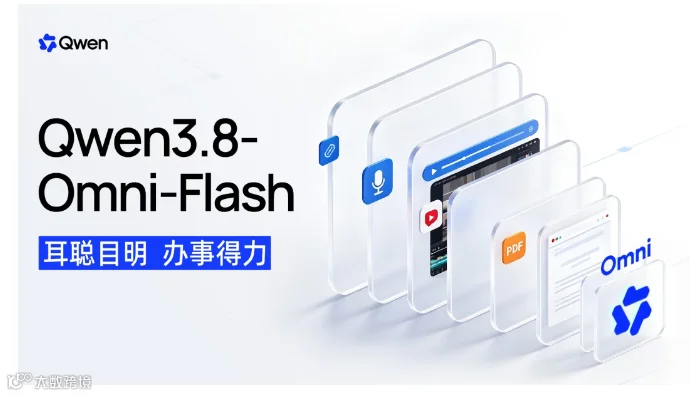
9月18日,千问上线新一代原生全模态模型 Qwen3.8-Omni-Flash。它支持文本、图像、音频与视频输入,上下文窗口达到1M,已在千问AI平台开放体验。
这一代模型在原有的编程、文本知识工作与GUI操作等通用Agentic能力之上,重点拓展了以音视频为核心的Agentic应用,覆盖视频剪辑、MV创作、影视制作与解说、音视频转图文摘要及音视频对话等需要综合处理多模态内容的工作流。
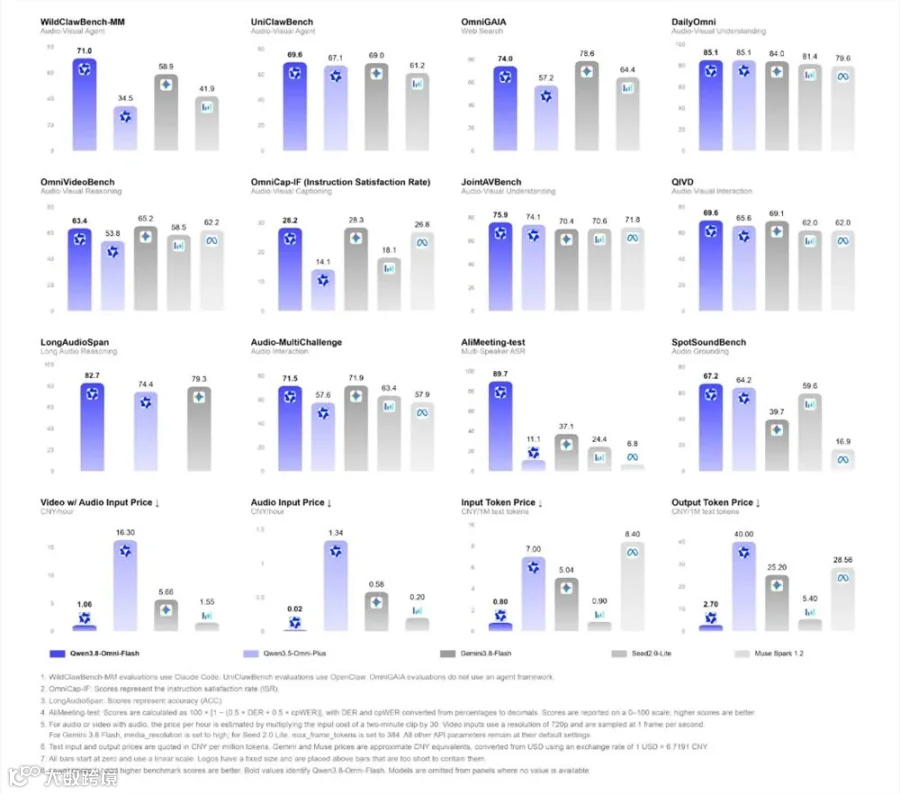
在累计30项评测中,平均得分较上一代 Qwen3.5-Omni-Plus 提升超26%。其中:
-
音视频 Agent、Coding 与长程任务方面,WildClawBench-MM 提升36.5分,AgenticVBench 提升22.3分,UniClawBench 取得69.6分; -
基础能力上,LongAudioSpan 提升8.3分,OmniVideoBench 提升9.6分,OmniCap-IF 的 CSR/ISR 分别提升8.5/14.1分,AliMeeting 的 DER/cpWER 由88.11/89.61降至3.35/17.18。

官方称其音视频能力接近 Gemini3.8Flash,音频能力整体超过后者。API 价格方面,音频输入价格降幅超98%,音视频输入价格降幅超93%。
为了支撑长程工作流与实时交互,千问扩展了 Qwen-MM-Plugins,并开源 Qwen-Live Harness。在 Agentic Understanding 模式下,OmniVideoBench 准确率从63.4升至67.8,Token 消耗从145736降至79117,降幅约45.7%。
团队还把模型用到了研发环节本身:12小时内自主完成评测集选择、数据构建与4轮迭代,累计构建3413条训练数据,将 Qwen2.5-Omni-3B 的四川话识别字符错误率从25.79%降至15.30%,相对下降约40.7%。
同步推出的 Realtime 版本,是首个支持"听声辨位"的全模态大模型。
关注公众号回复“进群”入群讨论