

视频生成正从离线的短片创作走向实时交互与动态编辑,但如何在保证画面质量的同时实现低延迟生成与连续编辑,依然是一个重要挑战。针对这一问题,清华大学与生数科技联合推出 Vidu S2,包含 Vidu S2-Avatar 与 Vidu S2-Editing 两个模型,分别面向实时数字人生成和视频流编辑。其中,Vidu S2-Avatar 支持实时 720p 视频生成、动态参考图随时更新以及更强的动作指令遵循能力,让数字人能够根据指令实时完成跳舞等复杂动作。
与此同时,Vidu S2-Editing 将实时能力进一步拓展到视频编辑场景,支持对输入视频流进行风格迁移、虚拟试穿、人物替换和背景替换,并兼容单目与立体视频输入。研究团队还探索了其实时空间视频生成能力,可将生成或编辑后的单目视频转换为同步的左右眼视图,为 VR 等场景提供实时空间视频体验;实验结果显示,Vidu S2 在各项基准测试中均取得优于现有方法的表现。
论文链接:https://go.hyper.ai/cWKxq
最新 AI 论文:https://go.hyper.ai/hzChC
为了让更多用户了解学术界在人工智能领域的最新动态,HyperAI官网(hyper.ai)现已上线「最新论文」板块,定时更新 AI 前沿研究论文。以下是我们为大家推荐的 8 篇热门 AI 论文,一起来速览本周 AI 前沿成果吧 ⬇️
本周论文推荐
1
NCP-ArchPreview
论文题目:
NCP-ArchPreview Technical Report: Moving towards Latent Space Language Models through Next Concept Prediction
来自上海人工智能实验室、LUMIA 实验室和上海交通大学的研究者提出 NCP-ArchPreview,将下一概念预测(NCP)引入语言模型预训练,在标准下一词元预测(NTP)之外,进一步学习跨越多个词元的离散概念。该模型通过隐藏状态构建乘积量化概念词汇表,并联合训练概念级与词元级预测,在 8.9B 参数、5.73 万亿词元规模下验证了隐空间语言模型的大规模训练可行性。
实验显示,NCP-ArchPreview仅使用 51.3% 的训练词元即可达到 OLMo-3-7B 的最终预训练损失,完整训练后下游任务宏平均性能提升 2.45 分,GSM8K 更提升 5.99 分。此外,学习到的概念空间还可用于轻量级领域适应和推测解码,仅更新 1700 万参数即可进行领域适配,将概念表示注入 DFlash2 草稿器后,平均接受长度提升 4.17%。
论文及详细解读:https://go.hyper.ai/PFZa5
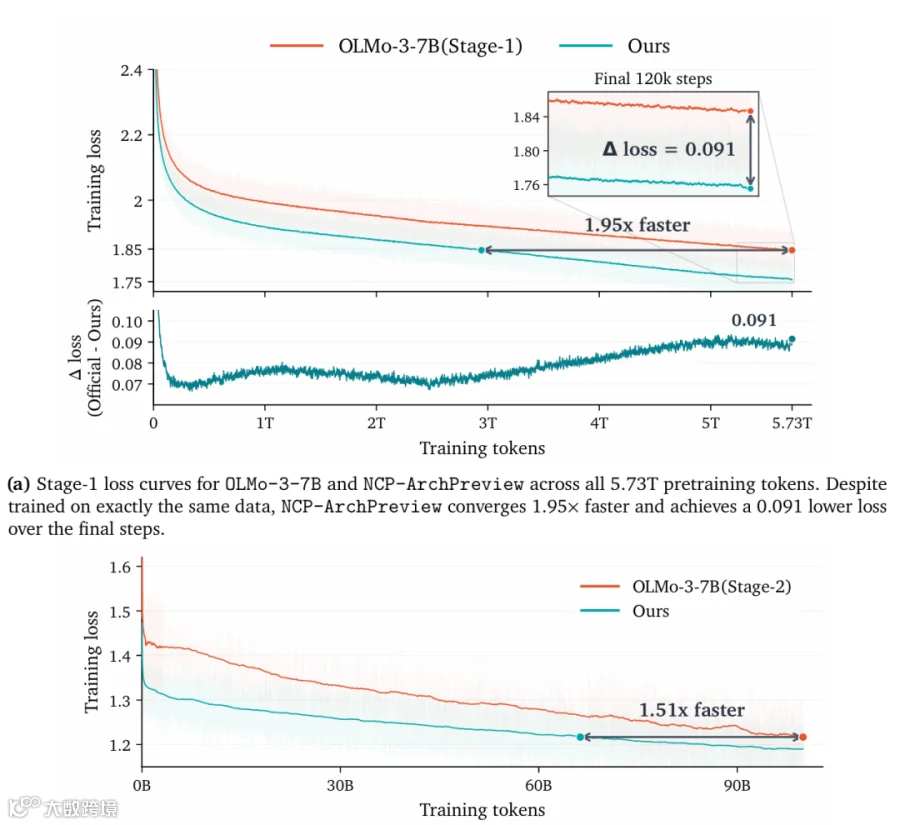
OLMo-3-7B 与 NCP-ArchPreview 在预训练第 1 阶段和第 2 阶段的训练动态比较
2
SenseNova-U1.5
论文题目:
SenseNova-U1.5: Towards Native Unified Visual Intelligence
商汤科技等研究者提出 SenseNova-U1.5,一款 8B-MoT 原生统一多模态模型,在无编码器、无 VAE 的架构下实现视觉理解、推理与生成的统一建模。模型通过空间连贯的图块重建强化视觉接口,并结合生成与编辑数据、结构化提示增强及最高 4K 原生分辨率进行训练,同时针对视觉美学、文本渲染、信息图和图像编辑等任务引入专用专家。
评测显示,SenseNova-U1.5 在图像保真度、文本渲染、复杂构图、多参考编辑和交错生成等方面均有提升,并通过多专家在线策略蒸馏进一步整合不同能力。即使结构化生成数据有限,模型仍能泛化至长程、复杂的视觉指令,在保持主体身份、几何结构和未修改区域的同时完成编辑任务,展现了原生统一多模态建模在视觉创作与规划中的潜力。
论文及详细解读:https://go.hyper.ai/HntSL
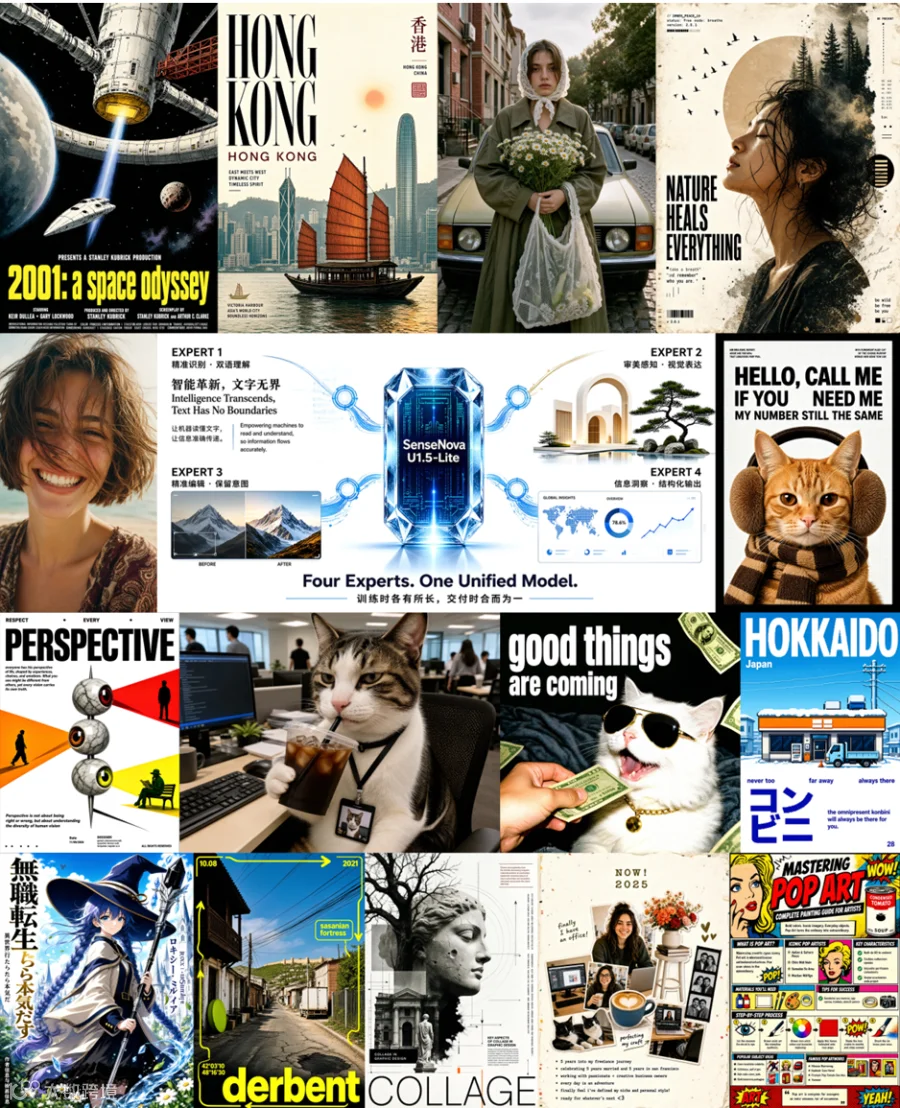
SenseNova-U1.5 在信息图表和人工生成领域的应用案例
数据集构成与来源:作者为 SenseNova-U1.5 构建大规模多模态训练语料,在先前 SenseNova-U1 基础上扩展,侧重数据多样性、视觉质量、高分辨率生成、复杂指令遵循与细粒度图像编辑。数据通过质量感知过滤、分布再平衡、更强图文对齐以及针对欠表示能力的定向合成进行筛选。语料组织为四个主要子集,每个具有不同组成、处理与用途。
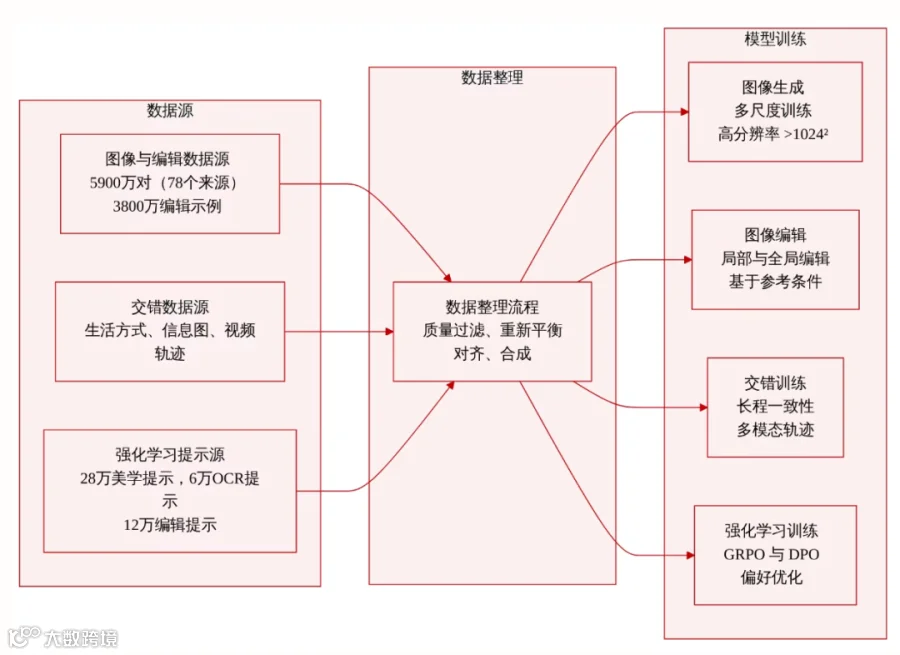
数据集
3
Benchmark Radar
论文题目:
Benchmark Radar: A Living Database and Search Engine for AI Benchmarks and Evaluation
来自卡内基梅隆大学、清华大学等多机构的研究团队推出 Benchmark Radar,一个面向 AI 基准测试的动态数据库与搜索引擎,持续汇集基准论文、代码、数据集及发布版本,覆盖 LLM、智能体、编程、推理、安全等评测领域。系统目前接入 37 个信息源,已收录 1,283 条基准记录和 12,916 条分数观测,并保留来源与引用信息,方便研究者追溯评测依据。
Benchmark Radar 不仅提供基准检索,还整合了分数历史、采用趋势和基准饱和度分析,帮助研究者理解不同评测结果背后的实验设置与证据。平台同时提供排行榜、帕累托前沿、每日信息流、可下载证据和 CLI 等工具,可用于快速发现已有基准、比较评测结果,并辅助新基准的设计与验证。
论文及详细解读:https://go.hyper.ai/KVy8j
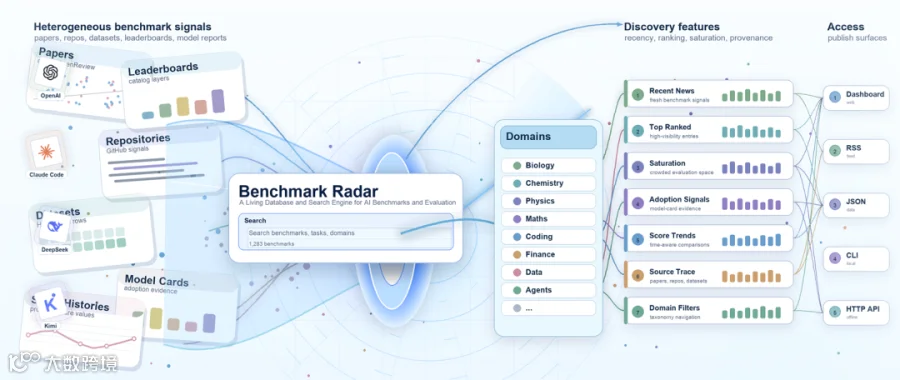
Benchmark Radar 框架示意图
数据集构成与来源: 作者构建了一个基准目录数据集,将静态来源记录与每日发现观察相结合。该数据不用于训练预测模型,而是构成搜索系统的底层知识库。
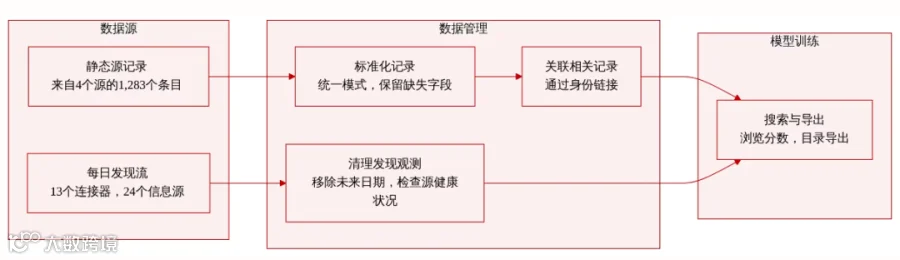
数据集
4
Vidu S2
论文题目:
Vidu S2: Real-Time Interactive, Editable, and Spatial Video Generation
清华大学与生数科技推出 Vidu S2,由 Vidu S2-Avatar 和 Vidu S2-Editing 两个模型组成,面向实时数字人生成与视频编辑。相比 Vidu S1,S2-Avatar 支持实时 720p 视频生成、动态参考图随时更新及更强的指令遵循;S2-Editing 则支持对视频流进行实时风格迁移、虚拟试穿、人物替换和背景替换。
此外,研究团队进一步探索了 Vidu S2 在实时空间视频生成中的应用,可将生成或编辑后的单目视频转换为同步的左右眼视图,面向 VR 头显提供空间视频体验。实验结果显示,Vidu S2 在各项基准测试中均取得更优表现,同时兼顾实时推理需求,并提供在线演示供用户体验。
论文及详细解读:https://go.hyper.ai/cWKxq

Vidu S2 概述

数据集
数据集构成与来源:数据集基于 Vidu S1 框架构建,并扩展了数据来源,包括直播/说话人视频、影视内容、高质量单人舞蹈视频以及 2D/3D 动画数据。这种混合丰富了面部表情和身体动作的多样性。
5
Atria Dawn Preview
论文题目:
Atria Dawn: The Dawn of Agentic Superintelligence
复旦大学研究人员推出 Atria Dawn Preview,一个面向科学研究与工程工作流的基础智能体语言模型,通过可验证经验流水线,将工具交互、可执行环境与外部验证结果结合起来训练。模型在涵盖科研、工程和数字工作的 16 项基准测试中展现出竞争力,并在其中 5 项取得最高报告分数。
研究团队进一步将模型研发过程作为人机协作案例进行分析,基于 56 名参与者、769 条任务记录及智能体日志发现,智能体能够主动提出研究方法与实施方案的修改,而人类仍负责大多数最终决策,并通过判断与反馈引导探索。研究表明,智能体正从单纯执行任务向参与项目级研究协作演进,对模型自主发现能力与人类监督机制提出了更高要求。
论文及详细解读:https://go.hyper.ai/tZbfl
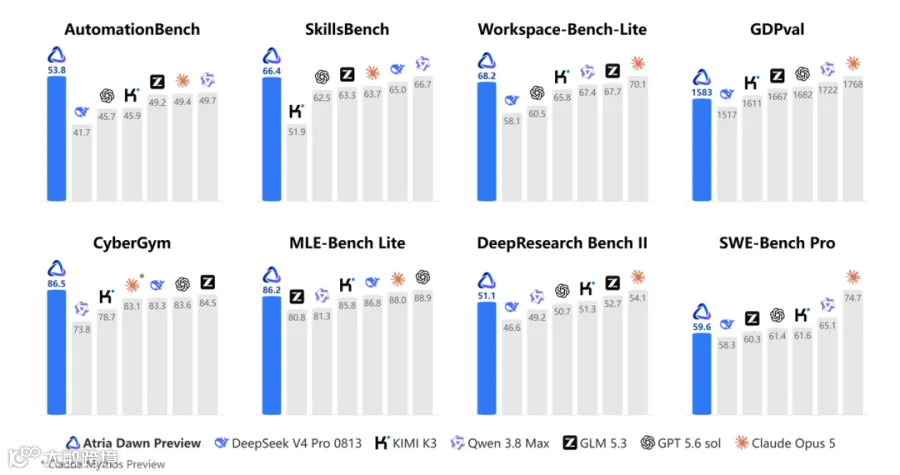
Atria Dawn Preview 与其他主流大型语言模型在主要
基准测试中的性能对比
6
Dream-RSI
论文题目:
Dream-RSI: Recursive Self-Improvement through Evolving Worlds
来自谷歌、谷歌 DeepMind、马里兰大学和弗吉尼亚大学的研究者提出 Dream-RSI,一个面向递归自我改进探索的可扩展框架,通过轻量级编排层将探索策略显式化、可编程化,同时无需修改底层编码 Agent。其核心思路是将累积的发现历史构建为回放模拟器,让 Agent 在“梦境”中以低成本获得离策略反馈,并据此持续优化探索策略。
改进后的策略随后重新部署到线上,推动新一轮发现,并不断扩充历史模拟器,形成递归自我改进闭环。在算法工程、数学优化和 GPU 内核工程等任务中,Dream-RSI 均取得了具有竞争力或更优的发现质量,同时显著降低发现成本,验证了利用历史经验优化探索策略的可行性。
论文及详细解读:https://go.hyper.ai/9lkSs
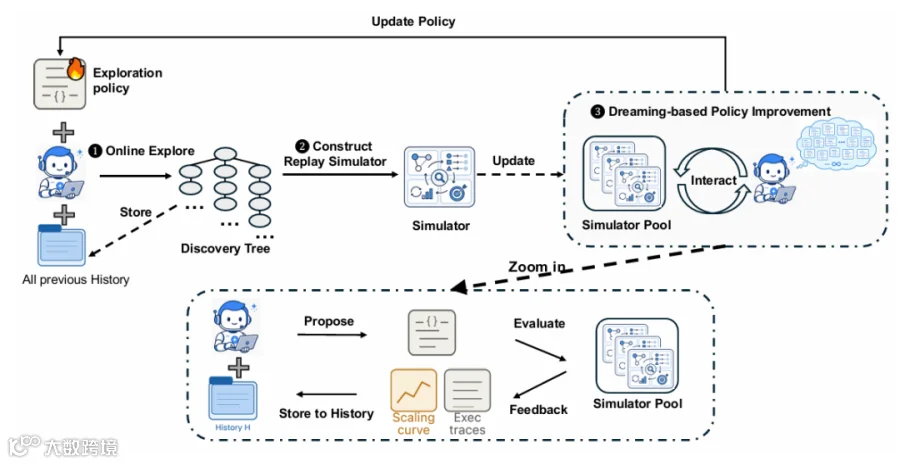
Dream-RSI 概述
7
long-horizon memorization
论文题目:
Continual Learning Mechanisms Compose for Long-Horizon Memorization
来自约翰霍普金斯大学的研究者提出长期记忆(Long-Horizon Memorization)这一评测设定,用于研究语言模型在持续学习多个任务时如何保留早期信息。研究团队构建了包含 100 个连续查询-答案任务的三个数据集,发现模型在顺序微调过程中会出现严重的灾难性遗忘,而现有单一持续学习机制难以在长时间跨度内维持稳定记忆。
为此,研究团队将数据锚、函数锚、权重锚与合并 LoRA等互补机制进行组合,并通过任务级连续减半系统搜索有效方案。实验显示,最佳组合在三个数据集上均进入前三,将平均最终信息保留率从朴素顺序微调的 1.2% 提升至 34.9%,实现约 28 倍提升,其中数据锚与合并 LoRA 带来的增益最为明显。
论文及详细解读:https://go.hyper.ai/YWoBP

在最佳单一机制和复合持续学习方法下的记忆持续时间
数据集构成与来源:
Symbol-QA: 10,000条随机键值关联,包含100个任务,每个任务100个样本。
LLM-QA: 由大语言模型在100个虚构主题下生成的10,000条查询-答案对,同样包含100个任务,每个任务100个样本。对于这两个合成数据集,每个查询在所有任务中均唯一对应一个目标答案。
Real-QA: 来自十个公开QA数据集的5,000条自然查询-答案对,经过筛选以排除模型在五次采样补全中任一运行下能正确回答的样本。该子集包含100个任务,每个任务50个样本。

数据集
8
AI for Games
论文题目:
AI for Games in the Foundation Model Era
来自新加坡国立大学和南洋理工大学的研究者系统梳理了基础模型与学习型世界模型在游戏领域的应用,将相关研究划分为 6 类 AI 角色:游戏与动作、玩家与游戏建模、游戏设计、游戏构建与维护、运行时生成与调整,以及游戏测试与评估。研究进一步分析了不同角色之间的能力迁移与产物复用,揭示了从游戏轨迹到世界模型、从设计规格到可执行实现等潜在连接。
研究指出,尽管不同方向之间已经出现能力复用,但游戏规则、引擎接口、状态表示和玩家环境仍具有较强的场景依赖性,因此跨场景迁移后的有效性仍需重新验证。目前,AI 在受限游戏玩法和特定学习环境中的评估相对成熟,而持久世界状态、持续软件修订、运行时适应和自动化测试等方向仍有较大探索空间。
论文及详细解读:https://go.hyper.ai/YUsWz

基础模型时代的游戏人工智能
数据集构成与来源:作者利用了广泛的数据集来支持玩家建模、动作接口和长时程生成。这些数据集在来源、规模和标注方式上各不相同,其使用方式取决于目标是行为推断、情感预测还是训练交互式视频生成器。

数据集
以上就是本周论文推荐的全部内容,更多 AI 前沿研究论文,详见 hyper.ai 官网「最新论文」板块。
同时也欢迎研究团队向我们投稿高质量成果及论文,有意向者可添加神经星星微信(微信号:Hyperai01)。
下周再见!