

近期强化学习与Agent的融合正成为自主决策领域的前沿热点,在机器人操控、多智能体协同、复杂博弈等场景不断涌现创新成果。
本文整理了10篇机器学习+贝叶斯优化相关的最新前沿论文,正在做相关课题的伙伴可以直接下方领取论文及代码(部分包含),搭基线、找改进点、扩实验方向都能直接用上。
长按识别下方二维码,回复【强化agent】
无偿领全部论文合集及项目代码
Hybrid LLM-Augmented Reinforcement Learning Agents for Complex Sequential Decision Tasks
面向复杂序列决策任务的混合大语言模型增强强化学习智能体
文章内容
针对长周期序列决策任务中纯强化学习探索效率低、缺乏高层语义指引的痛点,提出LLM增强型RL智能体混合框架。该框架采用分层决策流水线,大语言模型负责高层规划,生成子目标与结构化指导并提供语义奖励塑形,强化学习策略执行低层动作选择,配套记忆模块支撑策略优化与计划动态修订。在三类测试环境的验证表明,该方法在成功率、收敛速度上显著优于纯RL基线,消融实验证实子目标生成与奖励塑形为核心增益模块。
Intercepting an Agile Target with Net-Carrying Drones Using Competitive Multi-Agent Reinforcement Learning
采用竞争性多智能体强化学习的载网无人机敏捷目标拦截方法
文章内容
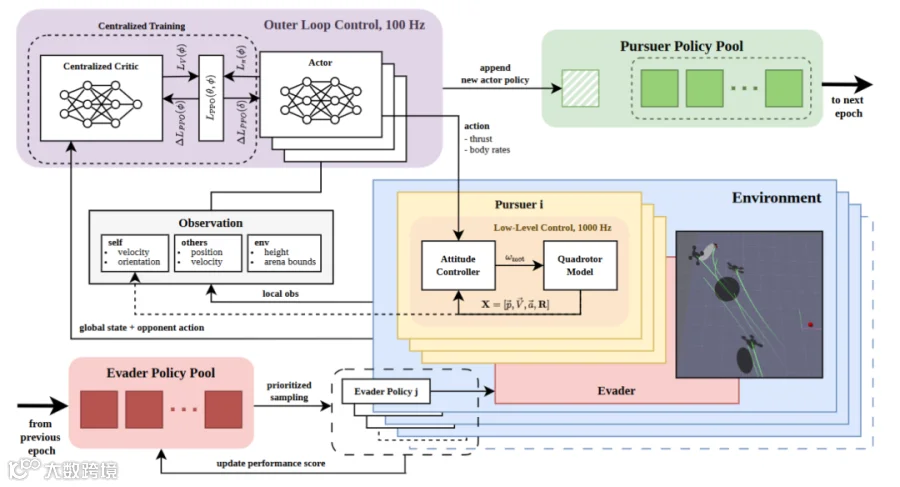
针对传统拦截方法难以应对高机动逃逸无人机的难题,提出竞争性多智能体强化学习拦截方案。该方案采用多智能体近端策略优化框架,引入优先虚构自博弈机制协同训练追击编队与逃逸目标,通过直接输出推力与姿态速率的低层控制指令实现敏捷飞行动作。高保真仿真验证表明,该方案在捕获率、碰撞安全性上均优于启发式基线,消融实验证实自博弈机制与低层控制的关键作用,追击方涌现出协同拦截战术。
Multi-Agent Reinforcement Learning for Joint Handover Management and Power Allocation in Multi-Orbit Satellite Networks
面向多轨道卫星网络联合切换管理与功率分配的多智能体强化学习方法
文章内容
针对多轨道卫星网络中吞吐速率与切换开销难以兼顾的问题,提出层感知多智能体强化学习框架,联合优化星上功率分配与链路切换策略,引入分层切换惩罚机制匹配不同轨道间的切换代价。在LEO/MEO/GEO三层星座场景验证表明,该方法在保持接近贪心策略92%吞吐速率的同时,将链路切换次数降低超四倍,通过分流5%流量至高轨道有效缓解低轨星座拥塞。

↓↓听说在下方一键三连的都Accept了🌝


