

AI Skill 已经从简单的文字辅助,逐渐发展为能够指导文献检索、实验分析、科研绘图和论文返修的专业工作流。
不过,GitHub 上的科研 Skill 明显集中在计算机科学和论文写作领域,其他学科的优质项目往往分散在不同仓库中,不太容易被发现。
因此,我从中选出了10个具有代表性的项目:既包括拥有数万 Star 的综合科研平台,也包括经济学、法学、历史学和神经科学领域“小而专”的工具。
下面先通过一张表了解它们各自适用的学科和主要用途,再逐一分析每个项目的功能、特点与使用边界。
排行榜总览

Academic Research Skills
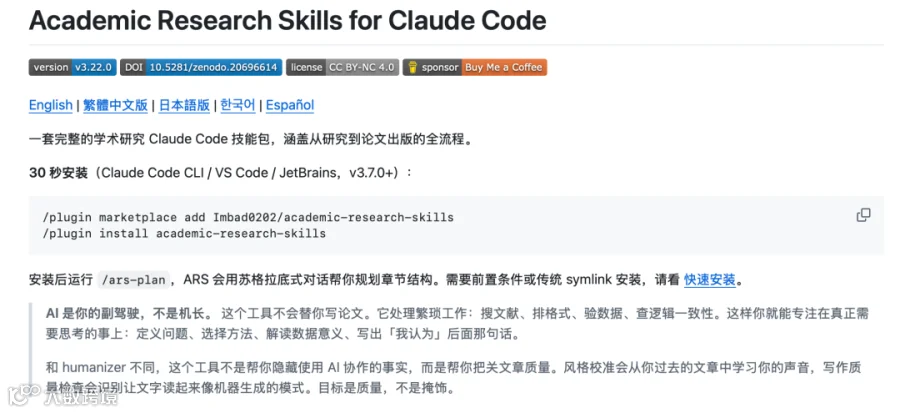
项目地址:Imbad0202/academic-research-skills
功能
覆盖深度研究、文献综述、论文规划、正文写作、同行评审、返修和定稿,通过多个阶段组织完整的学术研究任务。
这套项目的特点是流程完整。它会把选题、检索、写作、评审和修改串联起来,帮助研究者明确每个阶段的输入、输出与检查点。
适用场景
适用于综述、学位论文、研究报告和期刊论文的全过程管理,尤其适合需要系统梳理研究步骤的用户。
面对计量经济学、临床研究、湿实验或法律问题时,还需搭配相应的专业 Skill。
完整科研流程解决了“研究应该如何推进”的问题。接下来还需要回答另一个问题:遇到专业数据库和科学软件时,智能体怎样真正执行任务?
Scientific Agent Skills
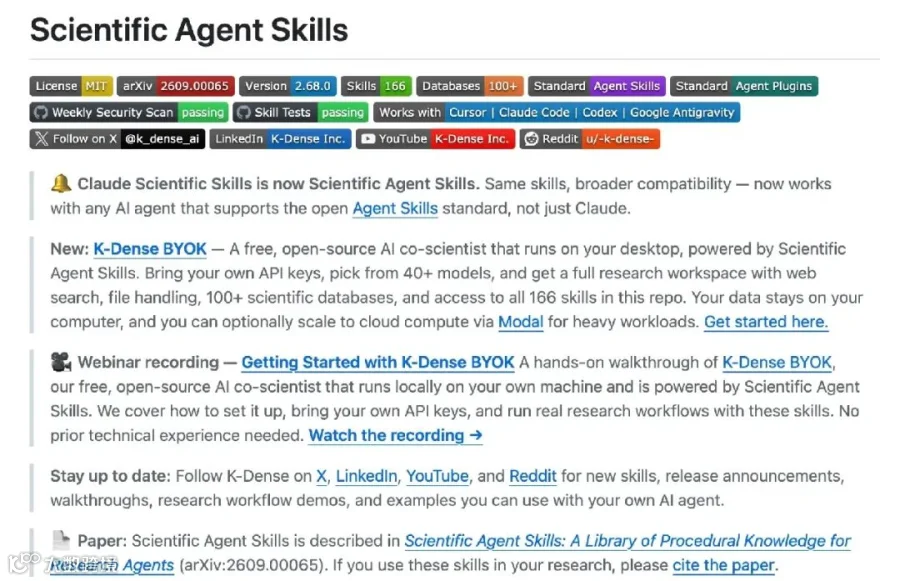
项目地址:K-Dense-AI/scientific-agent-skills
功能
收录大量专业 Skill,涵盖生物信息学、药物发现、蛋白质组学、材料、物理、地理空间分析、统计、机器学习和科研绘图。
它的核心优势是工具覆盖广。许多 Skill 直接围绕数据库、API和Python软件包设计,可以帮助智能体完成查询、分析、计算与可视化。
适用场景
可用于基因组分析、单细胞分析、分子对接、药物筛选、材料计算、天文数据处理、GIS和科学可视化。
仓库规模较大,建议根据课题安装相关子集。使用前还要逐项确认API密钥、软件版本、Python依赖、数据传输方式和具体许可证。
Scientific Agent Skills 强调计算与工具调用。科研工作进入论文阶段后,还需要处理阅读、表达、图表和审稿意见,Nature Skills 正好覆盖这一环节。
Nature Skills

项目地址:Yuan1z0825/nature-skills
功能
覆盖论文阅读、文献检索、学术写作、语言润色、模拟审稿、审稿回复、统计检查、科研绘图、数据声明和汇报PPT。
它对中文科研用户相当友好,覆盖了从读论文到返修的多个高频任务。各项功能按照独立 Skill拆分,研究者可以根据当前阶段调用对应模块。
适用场景
适用于自然科学、生命科学、医学、材料和工程领域的论文生产,也适合处理双语论文、组会汇报和审稿回复。
前面三个项目侧重通用科研能力。计算机与人工智能研究还面临一个更具体的问题:代码、实验和论文之间需要连续迭代。ARIS 将重点放在这条循环上。
ARIS

项目地址:wanshuiyin/Auto-claude-code-research-in-sleep
功能
面向AI和机器学习研究,覆盖文献调查、创新点生成、实验运行、结果分析、论文写作、自动审查和多轮改进。
ARIS 的特殊之处在于跨模型协作:一个模型推进研究,另一个模型负责质疑和审查。你可以把它理解为一条支持长时间运行的机器学习实验流水线。
适用场景
适用于拥有代码、评价指标和可自动执行实验的研究,例如模型改进、消融实验、基准测试、结果复核和论文迭代。
湿实验和依赖人工观测的研究难以直接接入。启动无人值守流程前,应限制GPU费用、API预算和实验轮数,并在独立分支或工作树中运行。
ARIS 展示的是计算机科研自动化。生命科学的关键资源通常分散在专业数据库中,因此还需要更强调数据来源和检索效率的 Skill。
Google DeepMind Science Skills

项目地址:google-deepmind/science-skills
功能
由Google DeepMind发布,通过标准化Skill连接AlphaGenome、AlphaFold DB、UniProt等科学数据库和工具,主要支持生命科学查询与分析。
它的覆盖数量相对克制,重点放在来源、结构和调用效率上。
适用场景
适用于基因功能查询、蛋白质结构检索、遗传变异分析、生物医学证据整理和化学信息查询。
它不覆盖完整的论文生产流程,也不能自动构建端到端生物信息学分析方案。具体任务仍需注意数据库版本、访问限制和引用要求。
DeepMind 提供了相对规范的专业资源入口。不过,科研用户还要面对 Skill 分散、安装复杂和选择困难的问题,AcademicForge 尝试解决的正是这一层摩擦。
AcademicForge
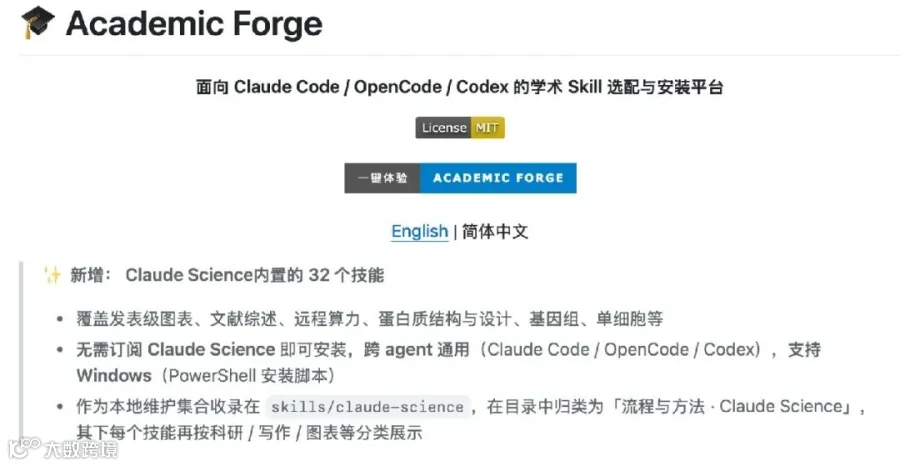
项目地址:HughYau/AcademicForge
功能
提供中文科研Skill的浏览、选择和安装入口,收录蛋白质结构、基因组、单细胞、科研绘图、文献综述和远程算力等技能。
AcademicForge 更接近科研 Skill 应用商店。它将分散在不同仓库中的能力重新分类,降低了发现和安装门槛。对刚接触 Skill 的中文用户来说,这种入口很有价值。
适用场景
适用于希望快速配置科研 Skill 的用户,尤其适合蛋白质设计、单细胞、生物信息学、科研绘图和远程GPU计算。
平台中的内容来自多个项目,质量标准和许可证可能存在差异。安装前应查看原始仓库、作者、依赖、数据上传方式和授权条件。
到这里,综合科研、自然科学和AI研究已经得到较充分覆盖。下面进入专业学科:这些领域通常拥有独立的判断规则,仅靠通用写作或检索流程很难处理。
Legal Skills

项目地址:gfodor/legal-skills
功能
围绕美国实用专利构建结构化审计和模拟审查流程,可检查申请材料、期限、权利要求、现有技术和证据来源。
法律任务最需要控制无依据结论。这个项目会明确标记缺失材料和无法判断的事项,并将机械检查、辅助分析与专业判断分开。
适用场景
适用于美国专利申请的材料预审、问题清单生成、现有技术映射和模拟审查。
其范围主要限定于美国实用专利,无法直接套用到中国专利、欧洲专利、PCT程序、自由实施分析和正式法律意见。使用前还要更新法规、MPEP和USPTO规则。
法律分析重视证据来源和程序规则。经济学研究则更关注估计目标、识别假设与统计推断,EconAgentSkills 体现了另一种专业化路径。
EconAgentSkills
项目地址:JonasWeinert/EconAgentSkills
功能
面向现代计量经济学,覆盖数据清理、面板模型、DID、事件研究、工具变量、RDD、聚类标准误和结果呈现。
它会先询问估计目标、处理时点、聚类层级和识别策略,再生成分析代码。我很看重这一点,因为计量研究的关键往往发生在运行回归之前。
适用场景
适用于应用微观经济学、政策评估、企业与家庭面板数据分析,以及使用R、Stata或Python开展因果推断。
它较少涉及宏观经济模型、DSGE、时间序列、产业组织结构估计和实验经济学。Skill能够规范分析过程,识别假设是否成立仍要结合制度背景与研究设计判断。
经济学 Skill 展示了社会科学中的定量方法。人文学科的研究材料和判断方式不同,Collate 选择从中文历史文献的整理与校勘切入。
Collate
项目地址:MidnightDarling/collate
功能
面向中文历史文献,提供扫描件预处理、OCR、文字校对、差异核验、文档输出和研究性阅读流程,并保留修改记录。

Collate 的意义在于把古籍整理和史料校勘转化为可追踪的数字流程。它也提醒我们,科研 Skill 的应用范围远远超过英文论文与代码实验。
适用场景
适用于古籍、地方志、民国报刊、档案扫描件和中文历史资料的数字化整理,也可辅助建设可检索的数字人文语料。
繁体字、异体字、竖排文本和破损页面仍需人工校勘。处理印章、水印和污渍时,应保留原始图像并进行逐页对照,避免正文被误删。
历史文献强调文本真实性,神经科学则同时依赖实验数据、信号处理和专业软件。最后一个项目展示了围绕学科软件库构建 Skill 的方式。
NeuroForge Skills

项目地址:HughYau/neuroforge-skills
功能
为神经科学常用Python库提供版本化指南,覆盖MNE-Python、Nilearn、Brian2等工具,辅助生成脑电、神经影像和神经建模代码。
它的定位很清楚:帮助智能体正确调用专业API。
适用场景
适用于EEG、MEG预处理代码、fMRI分析、神经影像可视化和计算神经元模型开发。
它主要解决软件使用问题,无法替研究者确定实验设计、预处理参数和统计模型。
结尾
看完这 10 个项目会发现,单靠一个 Skill 很难覆盖完整的科研需求。
更实用的搭配,是先用通用流程 Skill 串起文献检索、论文写作和审稿返修,再用专业学科 Skill 补上具体领域的方法、数据库和分析工具。
为了方便大家直接上手,我们已经把本文介绍的 10 个科研 Skill 的安装包整理成一份合集。
想一次性获取全部资料,可以在公众号后台回复关键词:[B886]
B685:创新点设计与可证伪性检验Skill安装包:paper-novelty-design
B754:drawio绘图软件、skill、插件安装包和使用
B795:可编辑 PPT 生成系统安装包和使用手册
B814:ChatGPT 5.6 安装包、使用教程视频
科研小白需安装的 11 个 SKills
往期文章推荐: