2026年9月18日,智谱今日宣布正式上线 GLM-5.3-FlashX模型(最高 200 tokens/s) ,带来更快的模型推理体验。
智谱官方表示,GLM-5.3-Flash 此前以“Ox Alpha”之名与全球开发者见面,获得海内外开发者的广泛认可,调用量持续攀升。
GLM-5.3-Flash 长期保持同尺寸最强智能水平,本次提速进一步形成智能、价格、速度的全面竞争力。
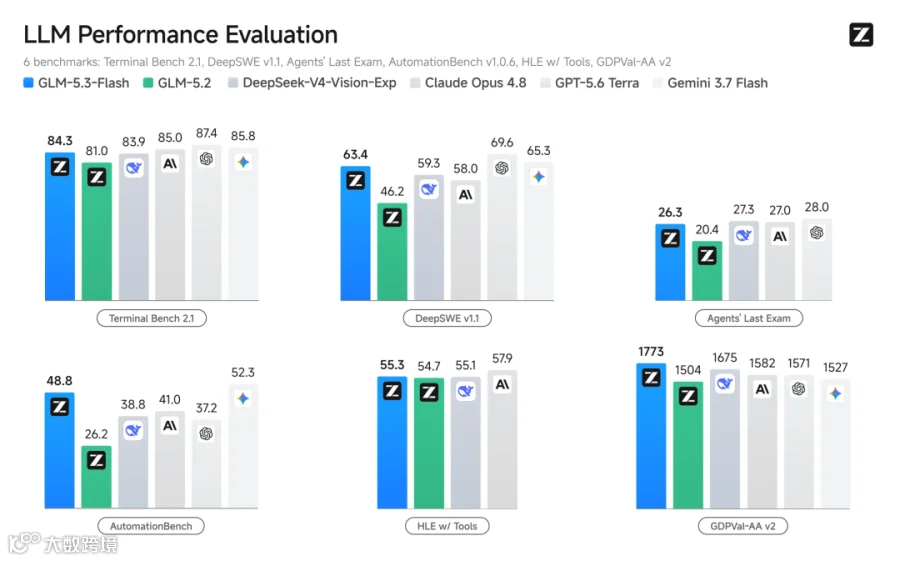
速度提升至200 tokens/s
作为Flash系列的新成员,GLM-5.3-FlashX 最大的变化是速度。官方数据显示,其最高推理速度可达 200 tokens/s,相比 GLM-5.3-Flash 有明显提升。
更短的响应时间和更高的吞吐能力。
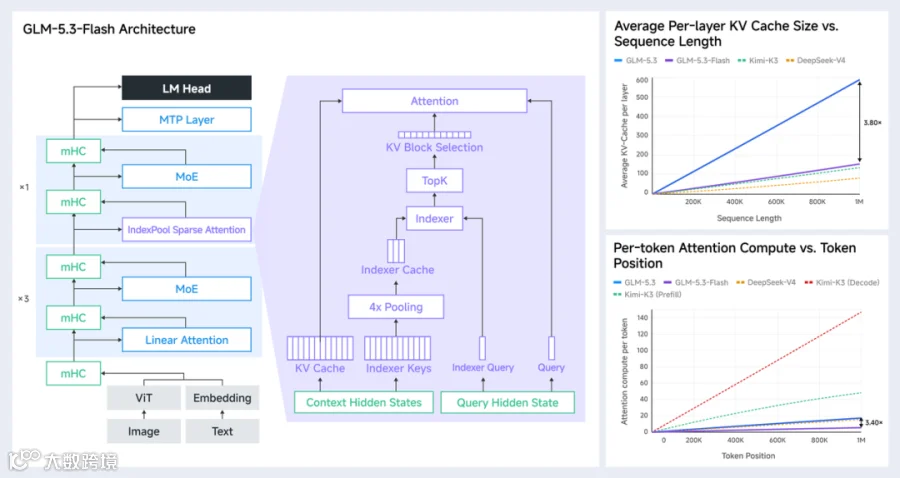
智能、价格、速度的全面竞争力
在原有智能水平基础上进一步提速,从而形成智能、价格、速度的全面竞争力。
官方文档,GLM-5.3-FlashX 的API定价

GLM-5.3-FlashX 的 API 定价为:输入 2 元 / 百万 Tokens,输出 7 元 / 百万 Tokens,缓存命中 0.57 元 / 百万 Tokens。目前缓存存储为限时免费,上下文长度支持 1M。。价格有所上调,但其速度提升也更为显著。

GLM-5.3-FlashX API 现已上线
Model Key: GLM-5.3-FlashX