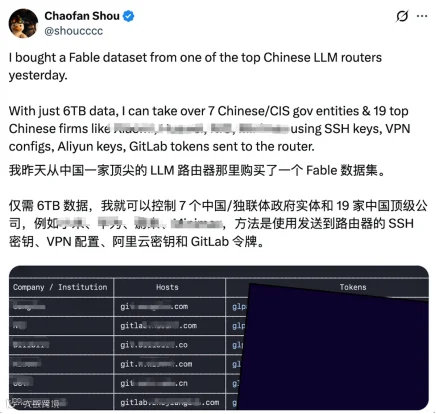
一位安全研究员,花五位数美元,从国内一家头部 AI 中转站手里买到了 6TB 调用数据。
数据里躺着 SSH 私钥、VPN 配置、云厂商最高权限密钥、GitLab 令牌。按他自己的说法,凭这批凭据,可以进到 19 家知名科技公司和 7 个政企科研机构的内部系统——名单覆盖互联网头部平台、头部新能源车企、头部网络安全厂商与头部大模型公司,还有国家级实验室和重点高校。
没有 0day,没有钓鱼,没有横向渗透。这些凭据是企业自己的 Agent,主动、完整、明文地发出去的。
这件事真正值得企业关注的,不只是某家中转站发生了什么,而是一个正在被越来越多企业忽略的问题:当 AI 开始代表员工访问系统、读取文件、调用工具时,AI 流量经过的那一层,本身就正在成为企业新的安全边界。
01
它不需要入侵你,明文本来就在它手里
传统网络安全的防护逻辑,建立在一个前提上:攻击者需要想办法进入企业系统。
但 AI 请求经过第三方中转服务时,情况完全不同。为了完成模型转发、计费、限流和账号管理,中转层必须终止加密连接,读到完整请求明文,再向上游重新发起一次 TLS。这是它的业务逻辑,不是漏洞。
真正的问题在于:企业是否拥有对这一层数据处理过程的控制权。
数据被读取后保存多久?是否进入日志?是否被复制?谁能访问?是否存在二级转发?出事之后,企业能否完整还原数据经过了哪些系统?这些问题,如果答案掌握在企业之外,企业就很难真正控制自己的 AI 数据边界。
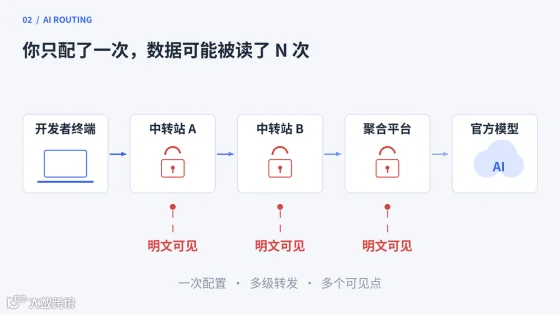
更复杂的是链路深度。很多中转站并不直连官方模型,而是连着另一个中转站。你只配了一条 base_url,数据可能被读了三次、五次 —— 你不知道这条链上到底站了多少人。
02
真正放大风险的,是开始替员工做事的 Agent
如果只是员工在对话框里问问题,AI 请求中通常不会天然包含大量企业内部凭证。
但 Coding Agent 和办公 Agent 改变了这一点。为了完成任务,它会自动扫描项目目录、读取配置文件、检索环境变量、执行终端命令 —— 然后把这些东西作为上下文一起打包上传。
.env 里的云密钥、~/.ssh 下的私钥、CI 配置里的 GitLab 令牌 —— 没有人 "决定" 要发送它们,它们是被上下文捎带出去的。
论文《Your Agent Is Mine》给出了两组相互独立的观测:
路由器实测(428 个样本):9 个主动向返回内容注入恶意代码(1 付费 + 8 免费),17 个触碰了预埋的 AWS 探测凭证,1 个转走了测试钱包中的 ETH。
诱捕实验(440 个 Codex 会话):401 个已经处于自动批准(YOLO)执行模式。
拼起来看才完整:上游有人在改你拿到的返回内容,而下游九成会话不看内容是什么,直接就执行了。
中转站不只能看,它还能改 —— 把窃密木马伪装成一个 "执行命令所需的正常文件",诱导 Agent 自己下载、自己运行。
数据外泄只是第一步,主动投毒才是终点。
03
中转站解决了“怎么用”,却没有解决企业真正需要治理的问题
现实中,企业员工为什么会主动寻找第三方 AI 中转服务?原因其实并不复杂。
他们需要更多模型,需要更稳定的服务,需要更方便的账号和额度,也希望 Claude Code、Cursor、Copilot 等工具能够直接接入,而不是反复面对注册、限流、余额、地区和网络等问题。
所以,单纯封禁中转服务,并不能消除使用需求。
企业可以控制网络出口、识别相关域名和接口,也可以通过终端、代理或者 DNS 等方式进行限制。但如果员工真正需要的 AI 能力没有进入企业自己的安全边界,那么现实结果往往只是“封一个、换一个;封一批、再找一批”。
真正的问题不是封禁,而是供给缺位
安全团队看到的是“员工绕过企业控制使用 AI”,而业务人员看到的可能是“企业提供的 AI 不够好用”。
如果企业能够提供统一的模型入口、稳定的调用服务、清晰的额度和成本管理,同时把安全策略、凭证、权限和审计能力一起纳入,那么员工就没有必要再寻找企业边界之外的替代方案。
因此,企业 AI 网关不应该只是一个“拦截器”。它首先应该成为企业自己的 AI 服务入口:统一接入模型,统一管理账号和凭证,统一提供稳定的调用能力,再在这个入口上叠加数据安全、Agent 权限、工具调用、成本和审计等治理能力。
封禁解决的是行为控制,供给解决的是使用动机。
04
即使不用中转站,企业仍然需要 AI 网关
假设企业完全不使用第三方中转服务,所有 Agent 都直连官方 API,问题就解决了吗?
——并没有。
官方 API 解决模型服务本身的认证和调用,但它不会替企业决定:一个 Agent 到底代表谁,正在执行什么任务,可以访问哪些业务系统,又可以调用哪些工具。
员工拥有 CRM 的编辑权限,不代表 Agent 也该拥有整套编辑权限;Agent 能读取项目目录,不代表它应该同时读取 SSH 私钥和云厂商最高权限。
这些问题,本来就是企业自身需要承担的治理责任。AI 网关不是中转站的替代品,它是企业 AI 基础设施中的一个新的控制层。
05
UAG:把 AI 流量、Agent 和治理能力收回企业边界
基于这一思路,派拉推出 AI 统一接入与治理平台 UAG(Unified Agent Gateway)。
UAG 部署在企业自己的 IDC 或私有云环境中,在 AI 流量与模型、工具之间建立一个由企业自己控制的统一治理层。
它解决的不是“如何把请求转发出去”,而是企业 AI 规模化使用之后,如何让 AI 接得进来、用得起来,同时管得住。
1
统一 AI 出口:先把入口收回来
当 Claude Code、Cursor、Copilot、自研 Agent 和企业内部 AI 应用分别连接不同模型服务时,企业很难形成统一的安全控制。
UAG 提供统一 AI 接入入口,并兼容 OpenAI、Anthropic 等主流协议。对于 Claude Code、Cursor、Copilot、Trae 等工具,只需调整服务地址和访问凭证,即可接入企业统一入口。
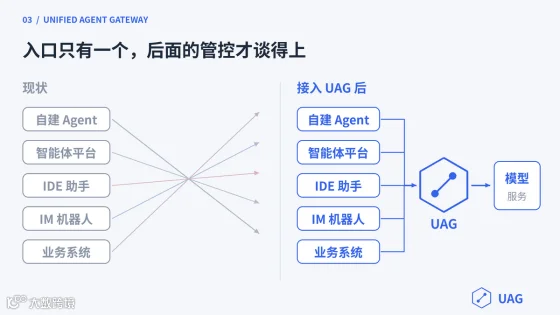
这样,企业首先获得的是一条清晰的 AI 流量边界:模型可以很多,但企业 AI 出口应该尽可能统一。
2
凭证集中管理:使用能力而不是拿走钥匙
AI Agent 的另一个特殊风险,是它可能需要调用大量模型和工具,而这些调用往往伴随着 API Key、数据库账号、第三方服务凭证等敏感信息。
UAG 将模型和工具凭证集中管理。用户创建的密钥只在必要时展示一次,管理员也无法直接获取用户密钥明文;对于 Agent 调用工具,则由网关完成凭证注入,真实凭证不进入 Agent 上下文,也不需要随着请求一起传递。
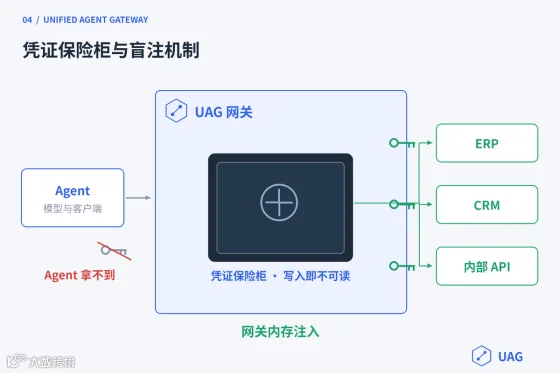
这样,Agent 获得的是“调用工具的能力”,而不是一把可以带走的真实钥匙。
3

输入安全:敏感数据离开企业前先检查
AI Agent 的输入不只是自然语言,也可能包含代码、配置、文件内容、访问凭证和企业内部数据。
UAG 在 AI 请求进入模型之前,对输入内容进行统一安全检查,可以识别敏感信息、访问凭证、私钥以及提示注入、越狱等风险,并根据企业策略进行拦截、脱敏或进一步处置。

策略可以按照企业、团队和 Agent 进行统一管理,让“什么数据可以发送给模型”的判断不再依赖每一个 Agent 自己完成,而是在统一 AI 出口建立企业级规则。
4
工具治理:Agent 能调用什么,由企业决定
真正具有业务执行能力的 Agent,最终一定会调用工具。因此,企业需要管理的已经不只是“模型输出了什么”,而是 Agent 接下来准备做什么。
UAG 与 MCP Gateway 协同,对 Agent 的工具调用进行统一控制。不同风险等级的工具,可以采用不同的治理方式:低风险工具直接使用;中风险工具按照 Agent 或团队进行授权;涉及高风险操作的工具,则可以进一步要求人工审批。

例如查询类操作可以自动执行,而删除、批量修改、敏感数据导出等操作,可以要求指定人员确认之后再执行。
模型负责生成建议,Agent 负责执行任务,而企业网关负责决定这项动作能不能真正发生。
5
模型与成本:让 AI 服务真正成为基础设施
企业 AI 使用规模扩大之后,模型服务不再只是一个 API 调用,而是一项需要持续运营的基础设施。
UAG 可以统一管理商业模型和企业私有模型,根据任务、负载和服务可用性等情况进行统一调度,并通过账号池、故障切换和多模型协同,提高整体服务稳定性。
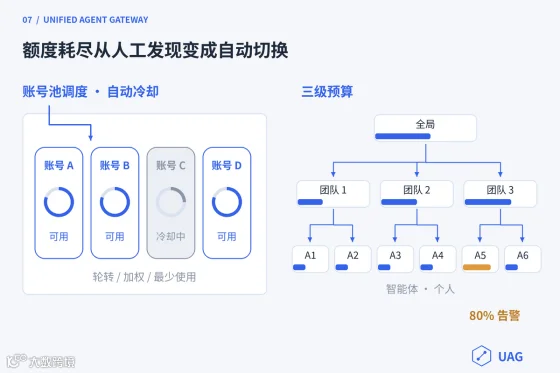
同时,企业可以按照组织、团队、Agent 和人员进行 AI 使用量与成本归属,并设置额度和预算策略。
这样,AI 网关承担的就不只是“安全控制”,同时也是企业 AI 服务的运营入口。
6
完整审计:让每一次 AI 行为都能够被还原
当 Agent 开始代表员工执行任务,企业最终需要回答的不只是“发生过什么”,而是完整还原一次 AI 行为的全过程:谁发起了请求,哪个 Agent 执行,访问了什么系统,调用了什么工具,经过了什么安全策略,是否有人审批,以及最终产生了什么结果。
UAG 对 AI 请求、Agent、工具调用、安全策略、审批、额度和使用量等关键行为进行统一记录,并通过 TraceID 串联完整链路。

发生问题之后,企业可以沿着调用链回溯,而不是只看到一条孤立的 API 日志。
对于对数据留存有严格要求的场景,也可以采用隐私模式,在不保存具体 Prompt 和 Completion 内容的情况下,保留治理所需的元数据和使用记录。
7
私有化部署:AI进生产,数据不出域
对于金融、能源、制造、医疗以及政企等高敏感场景,AI 网关本身不能成为新的数据出口。
UAG 支持完整的离线、私有化部署,并支持商业模型与企业私有模型统一接入,让企业可以根据自身数据等级和安全要求决定模型使用方式。
核心原则很明确:AI 可以进入企业生产环境,但企业的数据边界不必跟着出去。
写在最后:
6TB 数据事件真正值得关注的,不只是某个中转服务发生了泄露。
而是:当 AI 流量开始承载企业代码、数据和凭证,并由 Agent 代表员工执行操作之后,AI 请求经过的那一层,本身就已经成为企业新的安全边界。
过去企业建设 AI,首先考虑 "用什么模型"。但当 Agent 真正进入生产环境,企业需要回答的是:AI 流量从哪里出去,凭证由谁保管,Agent 代表谁执行,它拥有哪些权限,高风险操作由谁批准,出了问题能不能完整还原。
企业真正需要建设的,是一个属于自己的 AI 控制层。让模型快速接入,让员工真正用得起来,同时让身份、凭证、权限、数据、工具、成本和审计,重新回到企业自己的安全边界之内。
如果企业已经在使用 Claude Code、Cursor、Copilot、企业级 Agent 平台或自研 Agent,现在值得重新审视几个问题:
AI 流量经过哪些链路?Agent 是否可能接触企业凭证?权限是否与任务匹配?高风险操作能否被控制和审计?
欢迎联系派拉,获取《企业 AI 网关与 Agent 安全治理方案》,进一步了解 AI 网关建设、Agent 身份与权限治理、工具调用安全及 AI 审计体系。
扫码添加派拉顾问,获取方案并预约企业 AI 安全架构交流。