

2023 年 9 月,我在这个号上写过一篇《两款炸裂 AI 视频神器:Runway & Pika Labs》。
应了李碧华那句话:当初惊艳,只因为少见多怪!
后面这两年,视频模型狂飙突进,可灵、Veo、Seedance、海螺……说实话我已经有点麻了。每家发布的demo 都好看得不像话,真拿去用又是另一回事。
所以这周看到一个名叫 HiDream-O1-Video-1.0(他们自己简称 HD-V1)视频模型刷屏,我第一反应也是:哦,又一个。
让我停下来多看两眼的,是两个榜单。
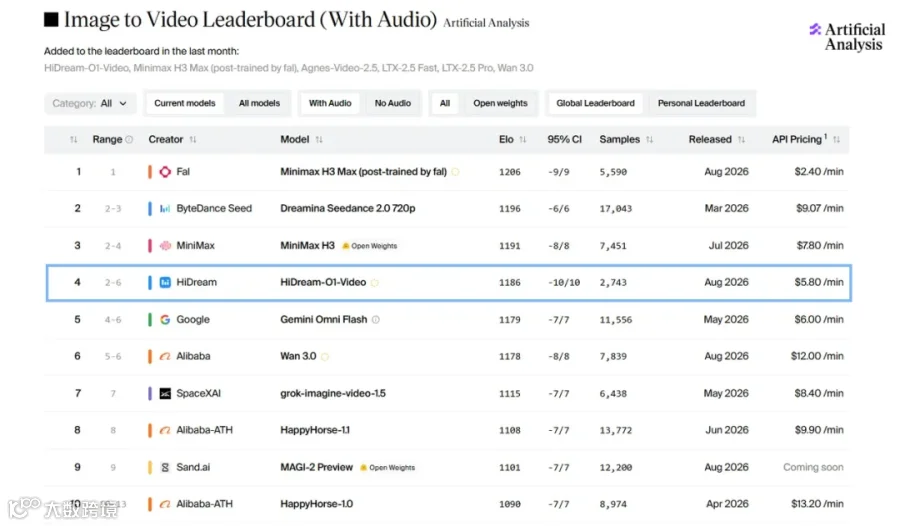
一个是 Artificial Analysis 的图生视频榜(带音频那个分榜),HD-V1 排全球第 4。另一个是 Arena 的图生视频盲测榜,排第 8。
2024 年 7 月,我在一个选品社群的日报里见过一个名为vivago.ai的AI视频生成工具,当时记录的用户注册数是 110 万,一个月涨了 90 万,日报上给它的标签是「出圈产品」。我当时没注意它背后的开发者,现在才知道与HiDream V1同源——背后都是智象未来——一家已经估值超过 10 亿美金的生成式人工智能企业。
回到HiDream V1,模型本身的参数先放这里:文字、图片、视频都能当输入,一次直出 5 到 20 秒的 1080p 视频,声音跟画面是一起生成的,不是后配的。然后我拿到了一份同题对比:15 组题,MiniMax H3、Seedance 2.5、HiDream V1 三家用同一个提示词、同一张参考图跑。视频我一条条看完了,我自己也申请到了测试额度,实测的部分放在后面。
看完这些东西,有几个判断,想跟做内容、做产品的兄弟聊聊。
一、先说榜单:别光看名次,看名次周围是谁
我把 Artificial Analysis 那个榜的前六名抄下来,你感受一下:
第一名到第六名,一共差 27 分,基本就是一个梯队。Google 的 Veo 3.1 在第 11。
前六里除了 Google 那一个,全是中国公司的模型:MiniMax 占两席,字节、智象、阿里各一席。以后聊国产 AI 视频,这四家得放一起说。
Arena 那边是盲测,用户同时看两条视频投票,不知道是哪家的。HD-V1 第 8,前面是 MiniMax H3、Gemini Omni、万相 3.0、Seedance 2.5 和 2.0、Grok。
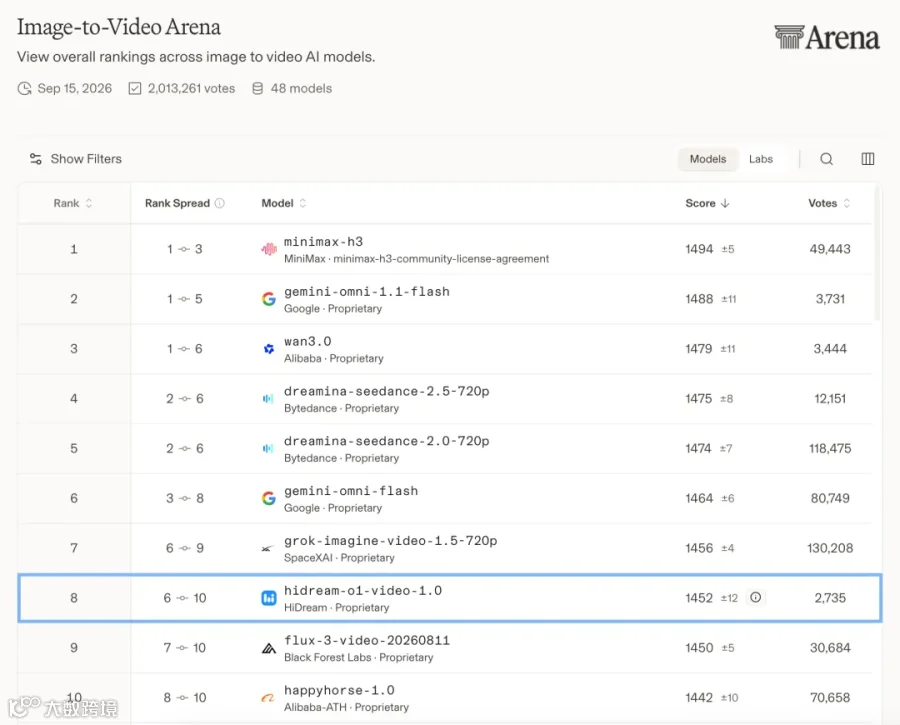
我的判断是:中国 AI 视频在全球第一梯队这件事,现在不是宣传话术,是榜单上摆着的。
但也得说清楚两点。一,这两个榜都只是「图生视频」这一项,不代表文生视频,也不代表长视频。二,前六名分差这么小,下个月顺序可能就换了。榜单能告诉你的,只是它在牌桌上;坐哪个位置,得自己试。
二、真正让我改主意的:先理解,再生成
我自己做内容,最烦的一步是写提示词。
我手里有一套给 Seedance 2.0 用的「导演提示词」,今年 5 月开始用的,两阶段:先让 AI 做脚本分析,把总时长、分镜数、角色映射表、情绪弧线列成一张表,我确认了,它再生成正式的提示词。为什么要绕这一圈?因为我发现直接把一句人话丢给视频模型,出来的东西经常跑偏。你说「一个人回头看镜头」,它可能给你三个人,或者回头回到一半就切镜头,人脸也变了。
模型会画,但它有可能没听懂乱画。
HD-V1 把这一步做进模型里了。它前面挂了一个多模态意图理解模块,你输入一句口语化的描述,它先把这句话拆成一张分镜表:
拆完了,再拿这张表去生成。
理解得越准,规划就越稳,后面生成就越不容易跑偏。
对普通人的意义很直接:你不用学什么提示词工程,用大白话把事说清楚就行。
三、时长不是你定的,是内容定的
有一组题我印象很深。
提示词:一个人一只手拿着红苹果,抛向空中,另一只手接住,然后握着苹果在半空停两秒,绝对静止。
三家都生成了。前两家都硬撑满了 10 秒:一家在动作做完之后,从第三秒起就让手一直握着苹果发呆到结束;另一家干脆用慢放来凑时长。HD-V1 那条,抛出、接住、停住,该几秒就几秒。顺带一提,前两家的苹果叶子在抛接过程中都掉了,HD-V1 的叶子还在。
HD-V1 现在原生支持 5 到 20 秒任意时长。你写「五秒钟的回眸」,它把「5 秒」当成意图,不当成硬指标,最后可能给你 3 秒,也可能给你 10 秒,看内容本身需要多长。
做过短视频的人都懂这意味着什么。以前每条 AI 素材,后面那几秒废镜头都得自己剪掉。
四、声音不是后配的,是一起长出来的
音画不同步是 AI 视频的老毛病。原因是大多数模型先逐帧画出画面,再回头配音、配音效,声音跟画面很难对上。
HD-V1 走的是另一条路:文本、视频、音频三路信号在同一个生成过程里一起建模,互相约束。 画面的运动牵着声音的节奏走,台词和音效反过来影响镜头的情绪。
对比里有三组题专门测这个:
如果你做短视频、做带货、做广告,这一条很实际:配音和拟音这两步可以省了,中文台词的口型也对得上。
五、懂物理:画面不只会动,还知道为什么这样动
这块是我觉得最能拉开差距的地方。
这块的技术我不是行家,只能把他们的说法翻译一下:物理规律不是后期贴上去的,是被写进叙事规划里的。
这种对物理规律的理解,一方面是先天优势,原生全模态架构下,模型直接“看”未经压缩的原图,能记住世界本来的样子,更有效地学习空间关系、时间演变和因果逻辑等物理世界的基础规则;另一方面,后天训练上,从训练数据和推理机制两端进行了针对性强化。
六、一致性:这是能不能做成产品的门槛
再说三组题:
这几条,做内容的人可能觉得是小瑕疵,但做产品的人会知道这是命门。
我自己做过 AI 图像和视频类的工具,用户上传自己的照片,出来的东西脸变了、logo 没了,等着你的就是退款和一星差评。模型能不能稳定不崩,直接决定了你敢不敢把它包进产品里收钱。
七、为什么它能一次把这些都补上:一个底座,四个模型
智象未来今年 4 月发布了原生全模态世界模型架构HiDream-O1,该架构下原始图像像素、文本标记与任务条件纳入统一的连续共享标记空间,实现了从“模态拼接”到“原生统一”的转变。。然后基于这同一个底座,他们陆续发了系列模型:

用智象未来创始人兼CEO梅涛的说法是「一个原生全模态底座、四大模型同源演进」。
我用自己的话翻译一下。
市面上做多模态大模型的公司,大概两种路线。一种是专攻视频生成这一个点,把它做到极致;另一种是先把视频做好,再往 3D、交互这些方向往外扩。智象是反过来的:先搭一个底座,图像、视频、3D 交互、具身动作四块在同一个架构上一起长。
6 月我在 X 上转过一条世界模型的推,开头写的是「做 AI 出海这几年,我一直在等一个东西真正成熟,那就是世界模型」。那会儿更多是期待。这次看到一家公司把四块拼齐了,而且每一块都在第三方榜单上有名次,我觉得这事离「能用」近了一步。
八、说点不好听的(客观泼点冷水)
九、我的判断
给做内容的:以前一条 15 秒的 AI 素材,我的流程是写提示词、生成、剪掉废镜头、配音、加音效。现在中间三步有机会一次出。用大白话写需求,比学提示词工程靠谱。
给做产品的:视频类 App 能不能套壳做成,关键在一致性稳不稳。现在国产前排有四家能选,接口成本早晚会被打下来。不要绑死一家,把模型层做成可替换的。
再往大一点说,视频生成这个能力本身,以后大概率谁家都有,差别会越来越小。最后拉开差距的,我觉得会是理解那一层:你说一句人话,它能不能听懂。 这也是我看完 HD-V1 之后,最想记下来的一点。
想试的话,智象官方公众号有内测申请表,或者先去玩 vivago R1(国内叫「够搭」)也行。我自己实测的部分,跑完再单独写一篇。