

论文标题:Uncertainty-Triggered Test-Time Selective Inference for Click-Through Rate Prediction
作者:Moyu Zhang, Yun Chen, Yujun Jin, Jinxin Hu, Yu Zhang, Xiaoyi Zeng
机构:Alibaba Group
会议:CIKM 2026 (November 07–11, Rome, Italy)
DOI:https://arxiv.org/pdf/2605.24989
1. 背景
CTR(点击率)预估是推荐系统的核心模块,直接决定用户看到什么内容。近年来,深度学习驱动了大量模型架构创新——从 DeepFM、DCN 到 PEPNet、HSTU,研究者们不断设计更精巧的特征交互方式来提升预测精度。

然而,现有研究几乎全部聚焦于训练阶段优化,推理阶段的潜力被严重忽视。事实上,即便是训练好的优秀模型,在推理时也面临一个核心矛盾:不同样本的预测可靠性差异巨大。训练数据中充分出现的特征组合,模型预测准确且置信度高;而稀疏甚至从未见过的特征组合,模型学到的表示可能已经"坍塌"——尾部特征的嵌入与随机初始化几乎无异。
虽然自适应门控(如 PEPNet)能在训练时动态调整特征权重,但它学到的是一个确定性的选择函数——当模型对某特征组合缺乏足够训练样本时,其门控决策同样不可靠。更根本的是,训练和推理有着不对称的目标:训练需要接触多样模式来学习泛化表示,推理则应只依赖模型已有把握的特征组合。
这种不对称性自然引出了测试时优化作为训练阶段改进的互补范式。但 CTR 模型基于二分类目标,没有内置的逐样本置信度评估机制;工业系统严格的延迟约束也给额外计算留下极小空间。
那么,如何在不修改模型的前提下,让推理阶段自主识别"不确定"的样本,并为其分配针对性的计算策略?
2. UTTSI:不确定性感知的测试时选择性推理
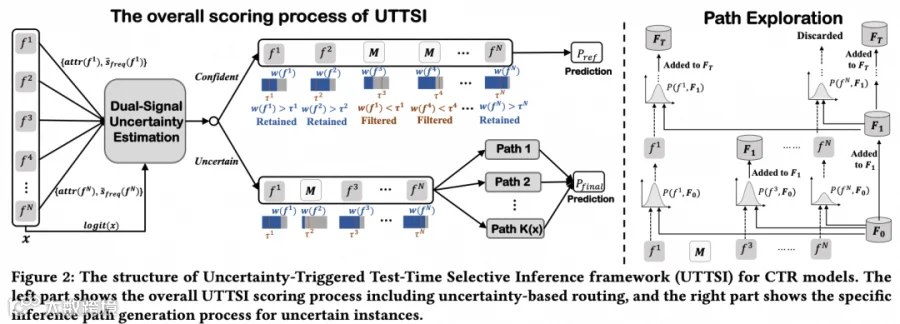
UTTSI 的全称是 Uncertainty-Triggered Test-Time Selective Inference——不确定性感知的测试时选择性推理框架。它是一个无需训练、与模型架构无关的框架,可以直接即插即用部署到任何已训练好的 CTR 模型上,不修改参数、不重训、不改架构。
核心思想很直接:在推理时,先估计每个样本的不确定性,然后按需分配计算资源——不确定样本做深度探索,有把握样本零额外开销。
2.1 频率先验估计
动机:特征值在训练集中出现频率越高,嵌入训练得越充分;罕见值的嵌入则不可靠。
做法:由于工业场景特征值数量庞大,UTTSI 采用基于 Count-Min Sketch 的概率哈希结构——为每个特征域维护 张独立哈希表,通过跨表取最小值估计频率,既保证上界又控制存储开销。归一化后的频率分数 取值 ,供后续模块使用。
好处:全部离线预计算,线上查询几乎零开销;为不确定性估计提供数据层面的可靠性信号。
2.2 双信号不确定性估计
动机:单一信号不够——模型置信度低可能是认知不确定(特征覆盖稀疏)或随机不确定(标签本身噪声大);频率先验能标记稀有特征值,但无法区分"可靠"和"不可靠"的预测。两个信号互补,才能精准识别真正需要额外探索的样本。
做法:对输入样本做一次标准前向传播,再反向传播获取每个特征嵌入的梯度范数(归因强度),然后计算两个置信度:
● 模型置信度 :将预测 logit 绝对值归一化到 ,接近 0 表示模型处于决策边界
● 频率置信度 :用归因强度对各特征频率加权平均——不仅看特征有多常见,更看真正驱动预测的特征有多常见
最终不确定性分数为两者的加权补数,探索路径数 与之成正比。不确定性越高,分配越多路径。
好处:连续分配机制实现精细化预算控制;平均约 2.8 次模型调用即可覆盖全部样本。
2.3 自适应特征过滤
动机:每个样本中都可能有"噪声"特征——嵌入训练不充分的特征会干扰预测,需要在进入模型前过滤掉。
做法:对每个特征计算综合得分 (频率可靠性 + 梯度归因强度),与每个特征域的自适应阈值比较。阈值从训练数据按域分别计算——因为用户 ID 域、商品属性域、上下文域的分数分布差异很大,单一全局阈值会系统性地过度过滤或过滤不足。
好处:特征仅在频率和归因双低时才被移除,保守策略避免误删有信息量的稀有特征。对于置信样本( ),过滤后直接输出结果——因为它们的特征组合已被模型充分学习,单次精炼预测已经足够。
2.4 选择性多路路径探索与一致性聚合
动机:过滤解决了特征级噪声,但不确定样本仍面临组合级不确定性——即使每个保留特征单独看都可靠,它们的联合交互模式可能在训练中稀疏出现。
做法:对不确定样本( ),UTTSI 在过滤后的特征子集上做迭代 Bernoulli 采样生成多条推理路径。每步中,候选特征被选中的概率与其可靠性-归因综合得分成正比——有信息量的稀有特征被优先保留,同时噪声特征更可能被排除。
所有路径(加精炼路径共 条)的预测通过一致性加权聚合:与多数路径一致的预测获得更高权重,偏离较大的异常路径被自动压低。
好处:所有探索路径完全独立、可并行执行。在水平扩展的服务系统中,最坏延迟等同于单次前向传播。

3. 实验
在 Criteo(45M 样本)、Avazu(40M)、KDD12(60M)和 Industrial(513M)四个大规模数据集上,与 FM、DeepFM、DCN、AutoInt、GDCN、MaskNet、PEPNet、HSTU 等十余个 SOTA 模型比较。
3.1 主实验
OptFu+UTTSI 取得全部四个数据集上的最优 AUC,且相对最强基线 OptFu 提升显著:
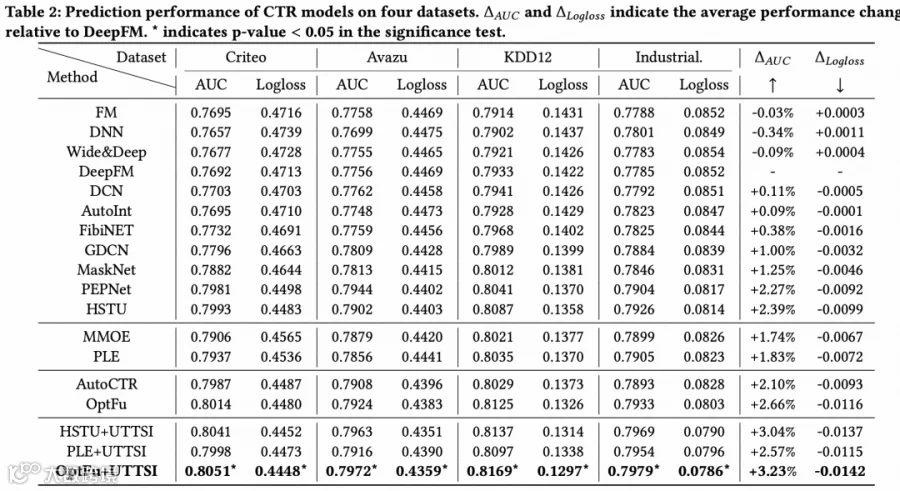
所有提升均通过统计显著性检验( )。在特征稀疏性更高的 KDD12 和 Industrial 上提升最为明显,直接印证了 UTTSI 针对稀疏特征的定向改进能力。
3.2 消融实验

三个消融变体验证了每个核心组件的不可替代性:
- 去掉双信号估计
(仅用 logit 置信度,RD):所有数据集一致下降——单信号无法区分认知不确定与随机不确定 - 去掉归因引导采样
(替换为均匀随机采样,RA):高稀疏数据集下降最大——单条路径质量更关键 - 单路替换多路
(WS):即使信号和采样都正确,单路径仍不及多路集成——鲁棒性来自探索多样性
3.3 线上 A/B 测试
在大规模电商平台上部署 UTTSI 进行 7 天线上 A/B 测试(2026 年 4 月 15–21 日),相比 PEPNet 架构基线模型,CTR 相对提升 5.3%( )。
计算开销:约 62% 的样本 ,仅需特征过滤、无需多路探索;平均约 2.8 次模型调用/样本,即 2.8 倍基础开销。所有路径完全并行,实际延迟与单次前向传播相当。
3.4 不确定性校准
按不确定性分数将样本分为低、中、高三层(Industrial 数据集):

高不确定样本获得最大 AUC 提升 +0.0088。不确定性分数与预测误差的 Spearman 秩相关达 0.91(仅 logit 置信度为 0.76),证实双信号设计可靠地将额外预算分配到模型最薄弱的地方。
4. 关于我们
我们是阿里国际-智能技术-Lazada推荐广告算法团队,我们致力于融合前沿深度学习、生成式推荐、用户超长序列建模、多场景建模、大模型算法等技术构建工业级推荐大模型,通过更深刻地洞察用户个性化偏好与决策逻辑持续助力商家投放效益与平台收益的快速增长。近年来,我们在前沿算法领域持续深耕,已经在WWW、SIGIR、CIKM、WSDM等顶级学术会议发表了多篇高质量论文。也欢迎感兴趣的同学加入我们,共同开创AI推荐的新篇章。
点击上方名片,关注我们吧~