
作者 |Don
来源 | 至顶AI实验室
最近看到一条既昂贵又硬核的本地AI测试视频。视频作者Alex Ziskind在一台4U液冷设备Comino Grando(来自欧洲立陶宛)上面,直接装了8张96GB的NVIDIA RTX PRO 6000 Blackwell Server Edition,单卡价格大约12万RMB,显存也达到了768GB!
总显存惊人,但更重要的是整个过程中它如何应对长上下文、多模型适配以及几十乃至上千个并发Agent。
768GB显存装进一台4U设备
测试机使用AMD EPYC 9474F处理器,拥有48核96线程,搭配512GB DDR5内存。8张RTX PRO 6000每张配备96GB显存,总显存达到768GB。作为参照,单张RTX 5090拥有32GB显存,这台机器的显存容量相当于24张RTX 5090的总和。当然,两者在产品定位、显存类型和多卡通信方式上并不能简单等同。
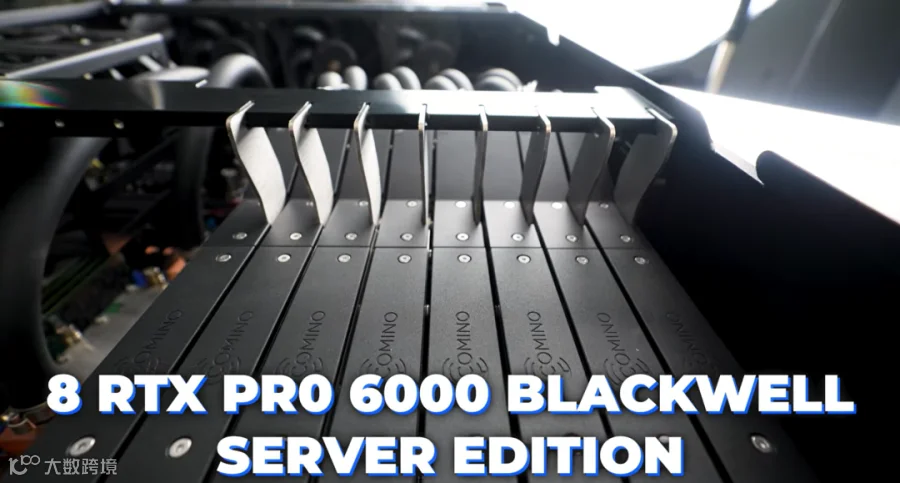
Grando能把8张卡压进4U空间,关键在于定制液冷。每张GPU拆掉原有双槽散热器,换成覆盖核心、显存和供电模块的铜制冷头,整卡厚度被压缩到单槽。两张卡共用一组分水器,快拆接头允许单独取出GPU,无需排空整个水路。视频记录到的最高GPU温度为62℃,CPU峰值约65℃,这套液冷系统承担了高密度部署的基础条件。
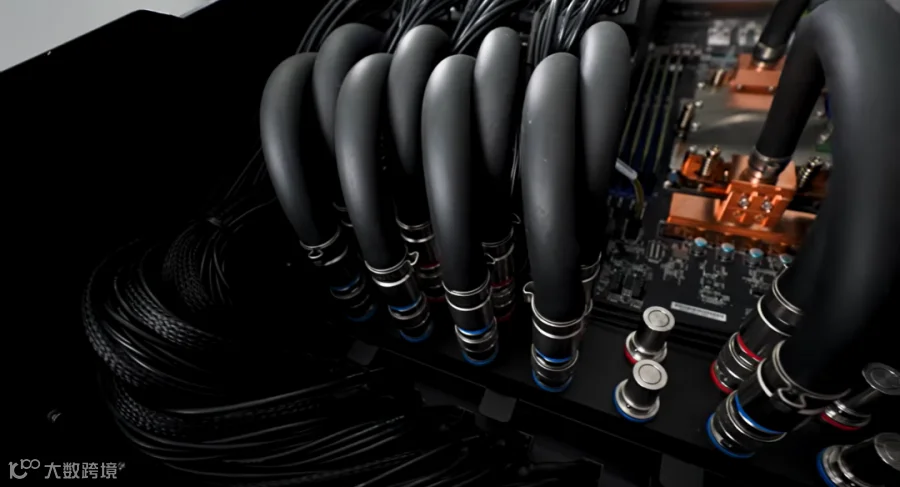
高密度也带来明显代价。整机重量约55公斤,噪声范围约39—70分贝,满载时并不适合放在工位旁。供电压力更直接:测试机配有4个热插拔电源,视频作者需要把它们接到不同电路,并把每张GPU的功耗上限设为300W。EPYC 9474F提供128条PCIe 5.0通道,其中7张GPU获得x16连接,另1张为x8;系统没有NVLink,多卡同步全部经过PCIe。这一设计随后直接影响了模型并行效率。
433GB模型跑到48 token/s
软件环境为Ubuntu 24.04、NVIDIA Open Driver 610、CUDA 13和vLLM Nightly,模型采用8卡张量并行。视频共测试5个模型,多数使用Blackwell支持的NVFP4量化格式。NVFP4以4位浮点表示权重,重点在于压低显存占用并利用Blackwell的低精度计算能力,让数百GB级模型能够留在GPU显存中完成推理。
体量最大的GLM-5.2权重约433GB,加载耗时约4分半,最终占用738GB显存,接近整机可用显存的95%。在2048 token输入、128 token输出的单请求测试中,它的生成速度约48 token/s。Qwen3-235B达到85 token/s,DeepSeek V4 Flash约102 token/s,GLM-5.3 Flash约104 token/s,Qwen3.8 Flash Next则达到126 token/s。

编码Agent还要看提示词处理速度。Agent每轮请求往往会携带代码库、终端记录、工具返回和此前对话,输入规模很容易达到数万token。测试中,GLM-5.2的提示词处理速度约2200 token/s,Qwen3.8 Flash Next达到约12600 token/s。在128K长上下文下,后者首token等待时间约14.5秒,GLM-5.2约50秒。如此规模的输入仍能在一分钟内开始输出,768GB显存和8卡并行的价值也在这里显现。
视频还专门测试了vLLM的前缀缓存。以约1.6万token的连续对话为例,GLM-5.2未命中缓存时首token需要5.9秒,命中后缩短到0.83秒。前缀缓存会复用此前已经计算过的KV Cache,对于反复读取同一代码库和历史对话的Agent工作流,收益通常比单纯提高解码速度更明显。
300W和600W,推理速度几乎没变
整段测试里最有现实意义的结果,来自功耗上限对比。作者分别把GPU限制在300W和600W,GLM-5.2单请求仍维持约48 token/s;在32路并发下,总吞吐约111 token/s。Qwen3-235B在64路并发下,两种设置分别约254和252 token/s,差距落在测试波动范围内。
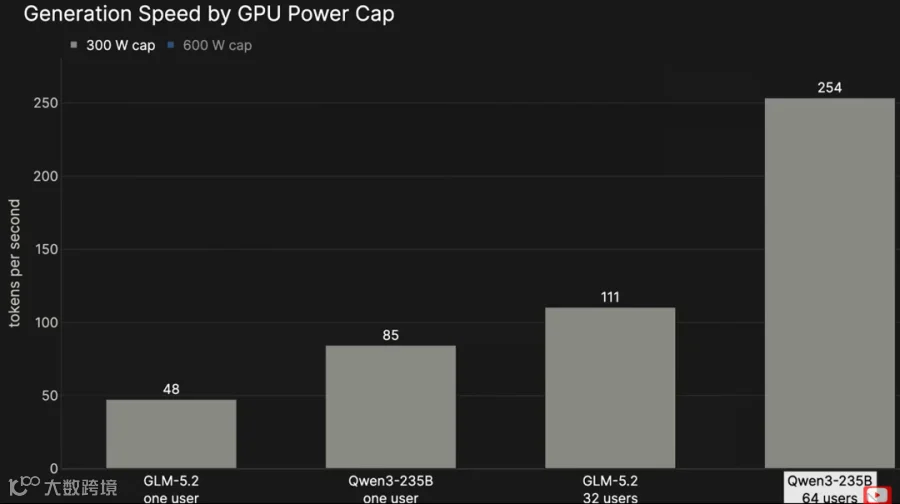
监测数据显示,8张GPU在GLM-5.2推理时总功耗约1550—1700W,单卡峰值只有268W。大模型解码阶段更容易受显存带宽和跨卡通信限制,GPU计算核心没有吃满,放宽到600W只会增加散热与供电压力。待机同样不便宜:模型加载后即使没有请求,8张卡合计仍可能消耗约700W。
PCIe通信还决定了多卡数量并非越多越快。Qwen3-235B使用4卡张量并行时约58 token/s,扩展到8卡后降至37 token/s,多一次All-Reduce同步产生的通信成本抵消了新增算力。对于能装进4张卡的模型,更合理的方案可能是部署两个4卡实例,分别服务不同用户;超大模型需要8卡容量时,再启用TP8。
1000个Agent跑起来,瓶颈变成等待时间
视频最后模拟了真实的团队负载。4台客户端同时连接Grando,每台先启动32个Agent,共128路并发,总吞吐约3000 token/s;随后增加到每台256个Agent,总并发达到1000路,系统仍完成了任务,总吞吐升至约6000—7000 token/s,测试期间生成超过63万token,且没有报错。不过,首token等待时间明显增加,说明机器能扛住请求,并不代表每个用户都能获得舒适响应。

更有参考价值的区间落在8—16路并发。Qwen3.8 Flash Next单用户约126 token/s,8路并发时每路仍有约82 token/s;到16路并发,几款Flash模型大致还能维持每路60 token/s、首token等待约2.5秒。对于一名同时调度多个编码Agent的开发者,或一个十余人的研发团队,这已经接近可持续使用的状态。
继续把并发推高,体验会很快下降。Qwen3.8 Flash Next在64路并发时,每路生成速度降至20.6 token/s,整机总吞吐约530 token/s;GLM-5.2的首token等待时间则升到约33秒。这组数据说明,衡量团队级推理设备需要同时观察两个方向:总吞吐决定机器一天能完成多少工作,单请求速度和首token时间决定开发者是否愿意持续使用。1000路并发展示了系统上限,8—16路并发更接近它的舒适区。
硬件装得下,软件仍要持续调
视频里的部署过程也暴露出新GPU与新模型之间的适配时差。测试采用vLLM Nightly,而非稳定版镜像。GLM-5.3 Flash在多个现成vLLM镜像中都遇到内核报错,原因与其注意力机制尚未获得完整支持有关。视频作者还提到,官方配方通常只覆盖4张RTX PRO 6000,扩展到8卡时需要自行修改张量并行规模;模型较小时,还要尝试4卡双实例等部署方式。
这类设备因此更接近一套需要运营的AI基础设施。团队要跟踪驱动、CUDA、推理框架和模型实现的版本变化,还要根据模型体量、上下文长度和并发规模重新调整TP、缓存与功耗策略。硬件容量解决了模型能否进入显存的问题,稳定运行仍依赖持续的工程维护。
看完整段测试,我更愿意把Comino Grando理解为一台面向团队的本地推理节点。它能在同一个机箱里容纳超大模型、长上下文和并发Agent,也把本地AI的工程约束摊在桌面上:供电、噪声、散热、PCIe拓扑、推理框架适配都要一起计算。对企业用户而言,采购前最该测的也不只包括峰值TPS,还应覆盖目标模型所需卡数、典型上下文长度、并发下的首token时间,以及长期运行的电力和运维成本。