


在不懈追求效率的过程中,供应链部门如今可以依靠由大数据催生的新技术来提升其活动的绩效。其各参与方每天产生的海量且多样化的数据,促生了众多极具吸引力的应用。然而,在人工智能(AI)领域,关键在于人机协作。这种人类智能与算法已确立?在构建互联供应链的过程中,人类的地位如何?本文提供解答。
供应链管理的新纪元
在学术研究和沃尔玛、宝洁等大型企业的推动下,物流行业在 20 世纪 90 年代经历了第一次重大转型。尽管一些企业仍在努力实施最佳实践,但大数据如今正在再次彻底改变供应链。
以“供应链 4.0"或“互联供应链”为名,这些令人瞩目的进展是数据科学家团队利用人工智能、区块链甚至机器人技术的成果。这些技术旨在使供应链对组织而言更具敏捷性、可预测性和盈利性。它们如何实现这一目标?通过缩短交货周期、全面自动化需求预测,以及提高按时生产和交付的能力。
数据科学对供应链领域的贡献
提升需求预测能力
数据科学与机器学习能够处理海量且多样化的信息源,因此在从大量数据中识别趋势方面具有特别重要的价值。
在供应链领域,数据科学主要用于:
-识别需要积极监控的微弱信号,以制定前瞻性决策;
-整合来自不同来源的数据(如网络数据等)。
-根据不同的消费行为对产品进行分类;
-突出针对每种情况采取的行动策略。
优化物流流程的管理
在仓库管理方面,数据分析可以与某些外部因素(如原材料供应问题、货物交通、天气状况等)相关联,以帮助公司降低中断风险。
为了便于选择承运商并优化配送路线的组织,可以考虑多种因素:成本、待处理的产品类型、特定的运输标准和条件、包装、道路交通等。
通过根据仓库自身数据最优分配任务,人工智能算法也有助于更好地配置资源,从而提高效率。
改善客户关系
随着数据科学的发展,与消费者建立的关系也日益个性化。无监督机器学习算法使我们能够对客户进行精细细分,从而针对每种用户画像精准投放促销优惠和服务。
结合对客户反馈的分析,这些细分数据为提升客户满意度提供了宝贵信息,而客户满意度始终是任何供应链的核心关切。
人机协作:数据科学的关键议题
从数据到行动
在任何人工智能过程中,赋予机器的自主性是逐步实现的。这张 Gartner 图表展示了系统承担的工作(蓝色)如何逐步取代人类干预(绿色)。
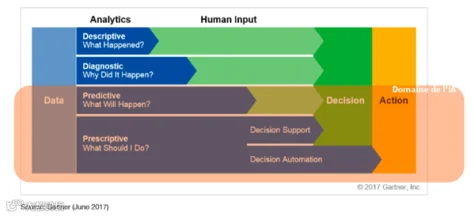
人机协作随后分为四个主要阶段:
1. 机器对数据的分析(分析);
2. 解释数据所必需的人类干预(人工输入);
3. 由此产生的决策(决策);
4. 转化为具体行动(行动)。
随着时间的推移,留给机器的自主权逐渐增加,直至我们对系统完全信任。但要使机器具备与人类相当的决策能力,在算法开发的各个阶段中,协作阶段至关重要。该阶段的长度和深入程度取决于所期望的自主权水平。
不同类型的算法
根据人机协作的性质和强度,机器学习算法主要分为三类:监督学习、无监督学习和强化学习。
监督学习
在监督模式下,算法基于由人类根据其特征及其对结果已知影响而选择的数据进行工作。例如:室外温度曲线会影响饮料销售,或待发货订单数量会影响仓库拣货负荷。销售预测模型尤其使用这类算法。
在这种情况下,智能主要由人类提供。机器则主要基于多组数据系列发挥其计算能力。
无监督学习
此处的目标旨在实现两个特定目的:
-创建聚类,即具有相似行为的个体群体,以便制定更精细且因此特别高效的管理规则;
-借助机器发现哪些数据对供应链绩效产生影响:作为专业人士所获得的理论方法并不总能充分检测并解释可能影响仓库效率的某些现象。机器能够实时、持续地识别微弱信号,因此成为运营分析和流程改进的强大工具。
在这两种情况下,机器用于建立诊断,而人类则在数据利用及据此定义应采取的行动方面发挥作用。
强化学习
这类算法主要用于语音助手、银行助手和机器人领域,它们通过经验循环运作,并在每次迭代中提升性能。这是人机协作中最先进的模式。通过评分机制,人类逐步教会系统做出最佳决策。它将自身经验传递给系统,并教导其适应多种不同情境。
数据科学为供应链带来了绝佳机遇。它不仅有助于提高效率、缩短处理时间和降低运营成本,还能增强应对突发状况的反应能力,并满足消费者的需求。然而,重要的是要牢记,数据科学离不开人类。事实上,正是人类为 AI 算法的开发提供了必要的智能。