


过去几年,大模型的发展始终伴随着不断升级的“标尺”:从 MMLU、MMMU 到复杂的 Reasoning 与 Agentic Benchmark。然而,当模型能力开始超越现有评测体系时,一个根本性问题浮出水面:如果现有的标尺已无法描述模型的真正能力,我们究竟该用什么来衡量 AI 的下一步?
Benchmark 本身正在发生范式转移。受限于早期 Grader(评分器)能力,许多开放式任务曾被简化为选择题;如今,随着模型推理与指令遵循能力的增强,评测正走向真实环境、长期任务与人类反馈。但新的矛盾随之而来:评测难度该如何界定?成本由谁承担?用已知指标衡量未知探索,是否本身就存在逻辑悖论?
陈文虎的研究轨迹恰好映射了这一变革。从 MMMU、MMLU-Pro 等多模态与知识推理基准,到后训练、Critique Fine-Tuning 及 Reasoning 相关工作,他不仅推动了评测范式的演进,更始终追问核心问题:模型究竟学会了什么?我们为何需要以特定方式证明这种学习?
目前,陈文虎在 Meta MSL 参与 Muse Spark 等多模态模型工作,并持续观察 Agent、RSI(递归自我改进)与开放式评测的发展。他认为,能力提升并不等同于价值提升,真正的瓶颈往往在于缺乏承载能力并转化为经济价值的环境。对于 RSI,他保持审慎态度:若仅在预定义环境中进行 hill climb,其与普通 Agentic 任务并无本质区别。
本期访谈深入探讨了 MMMU 与 MMLU-Pro 的起源、Benchmark 为何领先于模型、Grader 能力如何推动开放式评测,以及多模态、Agentic 和 RSI 的未来方向。核心观点包括:真正的 RSI 应发生在“人类未知”的领域;飞轮数据正成为前沿模型的关键护城河;AI 的终极进步并非由 Benchmark 驱动,而是由经济价值驱动。
相比追逐榜单分数,我们更应关注:当模型进入 Benchmark 无法覆盖的真实世界,什么才应成为衡量 AI 进步的新刻度?当已知标尺逐渐失效,我们又该如何判断那些尚未被定义、甚至未被人类完全理解的能力?
Z Highlights
- Benchmark 在领域目标未明时至关重要,它能定义发展方向。当模型已领先于 Benchmark,此时构建新评测反而更具战略意义。
- 理想中应由类似“联合国”的第三方中立机构发布 Benchmark,但现实中各方需生存盈利,这本质上是一个经济学问题:AI 社区难以诞生完全中立的评测机构。
- 早期受限於 Grader 能力,非选择题评测难以实施。如今模型评分能力增强,使得基于 Rubric 的开放式评测成为可能。
- 当前感知不到显著提升,有时并非能力停滞,更多是经济价值转化路径尚不清晰;同时,现有模型范式也可能需要技术突破。
- 多模态团队不应仅聚焦纯感知,而应覆盖文本团队未触及的任务分布,处理那些 inherently 需要感知能力的复杂任务。
- 当前 RSI 本质仍是某种 Agentic 任务,因其仍在已知边界内优化。真正的 RSI 核心在于探索人类尚未涉足的未知领域,用已知 Benchmark 衡量未知探索本身存在矛盾。
- 主线模型研发日益集中於大公司,因增量改进需海量算力与数据,学术界已难获取关键资源,形成较高壁垒。
- 宏观来看,模型能力的跃迁大多由经济价值驱动,而非 Benchmark 驱动。Benchmark 往往是价值验证后的产物,而非原因。

当模型跑在标尺之前:从设计 Benchmark 到训练 Grader,一场评测范式的变革
ZF:欢迎,请先简单介绍一下自己,以及您现在主要在做什么。
陈文虎:我之前在滑铁卢大学任教,目前处于休假状态。现任职於 Meta MSL,主要参与 Muse Spark 大模型项目,侧重多模态领域的预训练与后训练工作。
ZF:我们从 Benchmark 评测聊起。您的工作涉及 MMLU-Pro、MMMU 等系列基准。是什么契机让您认为 Benchmarking 至关重要?最初是如何启动的?
陈文虎:Benchmark 在领域目标模糊时尤为关键,它能帮助定义研究方向。开发 MMMU 的契机是 GPT-4V 发布后,我们发现既有视觉 Benchmark 已趋饱和,无法反映其展现的幽默解释、复杂数学解题等新能力。当时的 OK-VQA、VQA 等多为感知型任务,缺乏知识与推理维度。换言之,模型已领先於 Benchmark,此时构建新评测反而更重要。
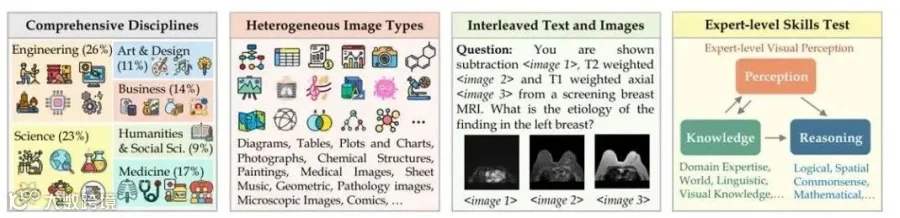
图 1|MMMU 数据集概览
图 2|MMMU-Pro 构建流程:①用纯文本 LLM 过滤出高度依赖图像的题目;②将选项扩展至最多 10 个并经人工校验;③加入实拍照片/截图等形式
后续在后训练与 STEM 推理研究中,我发现除数学外,化学、生物、医学等领域缺乏优质 Benchmark。MMLU 题目相对简单且趋于饱和,信号微弱。因此我们将 MMLU 升级为 MMLU-Pro:一方面提升题目难度,另一方面增加选项数量,使 Benchmark 能更有效指示模型进步。
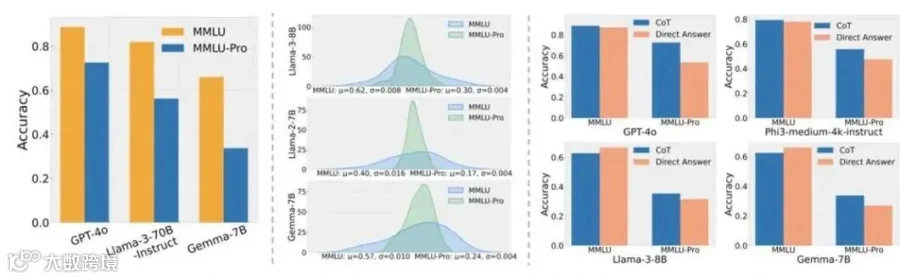
图 3|MMLU 与 MMLU-Pro 对比:(左)准确率差距;(中)24 种 Prompt 下的分数分布,越高越窄表示越稳定;(右)CoT 与直接作答的表现差异
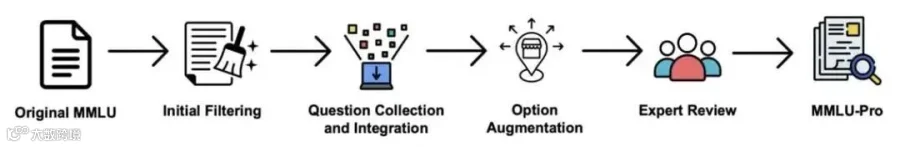
图 4|MMLU-Pro 数据集构建流程:原始 MMLU → 初步过滤 → 题目收集与整合 → 选项扩展(4 个增至 10 个)→ 专家复核 → MMLU-Pro
ZF:构建 Benchmark 时,您更看重真实性(如源自真实用户问题)还是难度(如顶尖模型仅得 30-40 分)?哪些因素优先考量?
陈文虎:这取决于阶段。初期构建 MMMU 和 MMLU-Pro 时,真实性与难度同步提升——题目既难又源于考试与真实提问,无需权衡。但现在看,二者确需平衡:过度贴近普通用户分布会导致 Benchmark 偏易;过度追求难度则可能偏离实际应用场景。

图 5|MMMU 各学科样题示例(艺术设计、商业、科学、健康与医学、人文社科、技术与工程)

图 6|MMLU-Pro 的学科分布(左)与题目来源分布(右):约 56.6% 来自原始 MMLU 题目,33.9% 来自 STEM 网站,其余来自 TheoremQA、SciBench
当前普通用户场景已被现有 Benchmark 较好覆盖,真正缺失的是专业长尾场景,如造船、电路设计、芯片制造等。这些场景适合构建 Agentic Benchmark,如 Andon Labs 的 Blueprint、Vending-Bench 或炒股模拟。它们足够专业、真实且具有挑战性,未来将成为评测重点。

图 7|Vending-Bench:Agent 经由邮件/搜索等「远程工具」与「售货机工具」经营一台自动售货机,以最终净资产为主要评分指标,并记录销量、工具调用等运行数据,用于考察长期自主经营的连贯性
ZF:目前 Benchmark 分为闭源维护(如 Vending-Bench)与众包开源(如 HLE、Terminal-Bench)。您认为哪种更可靠?
陈文虎:我更倾向相对开源的众包方式。私有 Benchmark 常具盈利性质,单次测试成本高昂。大公司可多次测试逆向破解题目与评分标准,进而针对性优化;而资源有限的机构仅能测一次,天然处于劣势。此外,部分厂商出售分布内训练数据,导致成绩取决于购买量。
相比之下,公开众包数据更透明公平。虽存在过拟合风险,但完全保密本就不现实——只要有人能获取分布内数据,便可见类似题目。这本质是经济学问题:AI 社区难以建立如“联合国”般完全中立的 Benchmark 发布机构。

图 8|Humanity's Last Exam(HLE)与已趋饱和的现有 Benchmark 对比
ZF:从 2023 年至今,Benchmark 形式从选择题转向执行、test case 与持续奖励。随着评测愈发 open-ended,评测本身难度是否也在增加?
陈文虎:是的。早期受限于 Grader 能力,非选择题难以实施——即便制定 Rubric,也无模型能据此给出可信评分,故只能采用选择题。我们曾尝试将 MMLU 改为开放式,终因不可行而转为增加选项。
如今开放式评测得以实现,主因是模型评分能力显著提升。只需提供详细 Rubric,模型即可评分。选择题仅覆盖约 1% 的现实问题,Rubric 加 test case 可覆盖 10%,但剩余 90% 如涉及创意设计、视觉艺术等主观任务,仍需依赖人类投票。
ZF:Coding 之后,下一步做什么?科学或工程类任务评估较成熟,但如 bio 领域,难以定义静态环境,也无法提供百万级相同胚胎供模型操作。如何应对?
陈文虎:评测可分为两类模式。任务越专业,通常越可验证(verifiable)。如造船、电路、芯片均可通过模拟器或 test case 验证,尽管过程复杂。反之,法律、创意类任务更偏向不可验证(non-verifiable)。大多数任务可归入此光谱两端。
ZF:即高经济价值且评估成熟的科学/工程任务,可复用於模型评测?
陈文虎:对。当前许多任务未被广泛评测,主因是缺乏合适环境。如炒股,若允许模型真金白银操作,结果可量化为收益,即为有效评测。此类任务未被普及,正因环境搭建困难。
对于无法固定环境的任务(如生物实验),需采用代理评测(proxy evaluation)。虽无百万相同胚胎,但可区分低风险与高风险实验,先在高中、大学实验室可控环境中测试模型能力,表现优异后再进入高风险场景,以提高可靠性。
ZF:您曾在普林斯顿提出 Critique Fine-Tuning。它与 Grader 有何关联?对不可验证任务有何作用?
陈文虎:Critique Fine-Tuning 指让模型针对他人答案生成 CoT 并判断对错,属 RL 任务,因结果为二元可验证。我们在数学任务中引入该方法,结合标准训练,确有成效。目前多家大实验室后训练中已采纳类似策略。
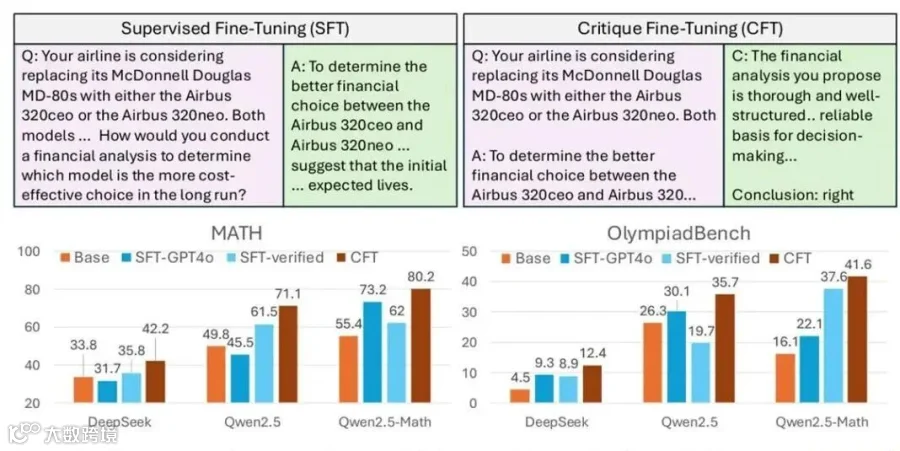
图 9|Critique Fine-Tuning(CFT)与 SFT 在 WebInstruct 5 万样本上的对比:在 MATH 与 OlympiadBench 上,基于“对答案的批判”训练的 CFT 一致优于对答案做模仿的 SFT
优秀 Grader 需具备强指令遵循能力,能解读数百条细致 Rubric 并投射至自身推理空间。训练 Grader 可提升评分能力,但大部分能力迁移自 SFT 与其他 RL 任务。强模型即使未专训 Rubric 评分,能力已达 80%,再训练仅微幅提升至 82%-85%;若基线仅 20%,则无法单靠评分任务跃升至 80%。
通用模型能力可迁移至 Grader。Critique Fine-Tuning 的核心理念是:若模型对答案的判断力增强,其对问题本身的理解也会更深,从而提升整体能力。Grader 具备评分能力,意味着其对问题理解亦更深入。此方法带来增量,但幅度依模型规模与场景而异。
我们的论文将其作为额外训练目标,观察到部分提升,尤其在小模型(如 Qwen)上效果显著。前沿实验室因模型基数高、任务覆盖广,提升可能仅 2%-3%,但仍具价值。
多模态的冷思考:感知能力如何穿过经济价值的窄门,走向 Agentic 落地
ZF:聊聊 Multimodal,目前国内外对此似乎不太乐观。您如何评价多模态现状?
陈文虎:确实听闻不少多模态团队被整合进主线模型的消息。身在其中,我的心态与认知也发生了转变。
去年业界普遍看好 Omni 模型,视 Multimoal 为下一次跃迁关键,因大量 YouTube、Instagram Reels 等视频数据尚未纳入预训练,而当时预训练仍以文本、网页、代码为主。“世界模型”概念火热,人们相信加入多模态能让模型更好理解并落地真实世界,预测视频中下一步动作。因此,构建 Omni 模型、融入世界模型目标成为主流方向。
但实践后遭遇较大阻碍:并非毫无提升,而是提升不明显或缺乏有效评测。某些能力确有增强,但在编程或智能体 Benchmark 上无实质帮助。而这些 Benchmark 已有强经济价值背书,广受认可。若在关键 Benchmark 上无贡献,便需另寻证据证明其价值。有人自建 Benchmark 宣称提升,但问题在于这些评测无法转化为真实经济价值。
ZF:所以问题不在视觉能力无提升,而在其暂未转化为公认的经济价值?
陈文虎:对。主因是机器人技术发展缓慢,具身场景尚未普及。部分公司如 xAI 受益于 Tesla,其自动驾驶依赖纯视觉方案,视觉模型优化可直接提升驾驶性能,具备强经济动力。但对其他前沿模型而言,视觉增强后缺乏明确受众。
核心难题在於:难以将视觉能力嵌入具身机器,使其产生实际经济价值。若未来机器人普及,视觉理解将至关重要——识别物品、跨房间搬运、外卖配送等均依赖视觉。但在这一天到来前,多数前沿实验室难觅视觉能力的经济出口。Meta 稍好,拥有智能眼镜与 Instagram 等视觉产品,但尚未规模化。或许需放大千倍量级,经济价值方能显现。届时再训 Omni 模型,意义自现。当前看不到提升,有时非能力不足,实乃经济价值缺失;同时,现有模型范式或需技术突破。
ZF:若感知难以为主线模型带来明显提升,多模态团队应如何定位?
陈文虎:多模态最大价值现体现於垂直领域:一是电脑操作智能体(computer use agent),二是视觉编程,如前端、网站、HTML 生成。这些虽属编程任务,但可由多模态团队承接,空间广阔。
多模态团队不应仅是纯感知团队,而应覆盖文本团队未触及的任务分布。不止关注感知附带文本,更要处理 inherently 需感知能力的文本任务。例如 PDF 解析、视觉编程数据等,皆可纳入多模态范畴。若仅限感知,对主线模型贡献将受限。
ZF:AIGC 能否引入 Agentic 流程,以推理与智能体方法增强生成?如先分解再组合。此范式能否大幅提升生成质量?
陈文虎:此方向市场潜力巨大。感知本身经济价值有限,但 AIGC 市场庞大。据悉,某平台新增 AI 视频内容占比高达 95%。
我个人亦欣赏 AI 生成视频,因其可控性强、易定制。但当前生成流程繁琐:创作满意 10 分钟视频需反复写提示词、剪辑等。若借 Agentic 方法自动化——如智能体分析视频效果,自动添加转场、音乐——将极大提升效率。
ZF:Agentic 生成会成为重要方向,还是定义智能边界的下一范式?
陈文虎:它更可能成为垂直领域,如编程智能体,由专精公司深耕。当前障碍在於底层视频生成模型不够成熟,尤缺强指令遵循能力。若仅为文生视频(T2V),问题难解。
实现 Agentic 行为需强大编辑能力、片段级落地能力及内容理解与指令遵循能力,方可打造优质产品。
预计其将成为优良垂直领域,但难成颠覆性大事件。不会像编程那样引发全民探索,但具备商业合理性,吸引众多参与者改进。其能力多从文本智能体迁移而来,更多是受益者:随智能提升,Agentic 能力增强,更愿调用工具优化制作流程,创造更大应用价值。
感知仍重要,是 Agentic 系统关键能力之一。Grader 亦需视觉评分,如判断生成物美观度。故当前多模态发展,重在集成至现有 Agentic 框架体现价值,而非独立创造新范式。

RSI 不是另一个 Agentic:从未知探索的愿景,到昂贵评测的真实距离
ZF:近期 RSI(递归自我改进)热议,您如何看待?如何定义 RSI?何时可认定其真正奏效?
陈文虎:RSI 概念较泛,当前主要有两种形态:一是 AI for Science,助科学家提出与验证假设,推动科学发现;二是 AI for AI,让模型自我探索提升,如自训或改进 harness。所见范式大致如此。
两者现更像在构建环境。诸多 RSI Benchmark 如 RE-Bench、RSI-Bench 等,旨在创建类似 gym 的环境:置入模型,赋予原子操作,令其自我迭代优化。此事合理,但我未直接研究。
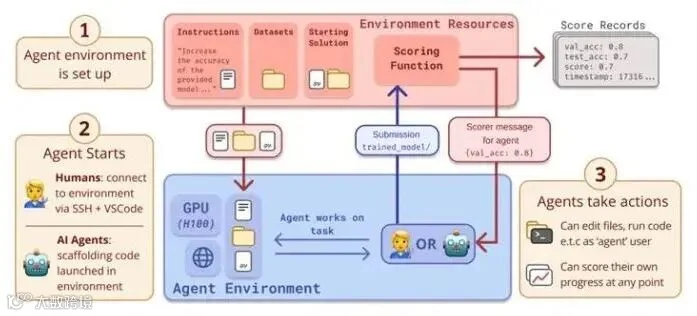
图 10|RE-Bench:7 个手工构建的 AI 研发环境,人类专家与 AI 智能体在相同条件下(给定起始方案、1–6 张 H100、可随时对自身进度评分)进行对比——即访谈中所说“像 gym 一样”的环境
在我看来,当前 RSI 本质仍是某种 Agentic,与常规 Agentic 任务无根本区别。普通 Agentic 任务产出代码或产物即结束;RSI Benchmark 多一步 hill climb 过程:每次完成获系统反馈分数,而非简单二元奖励。
MLE-Bench 即为早期 RSI 尝试,如爬取 Kaggle:先出方案得 80 分,继续优化至 90 分。我使用 Claude Code 时亦常如此操作。
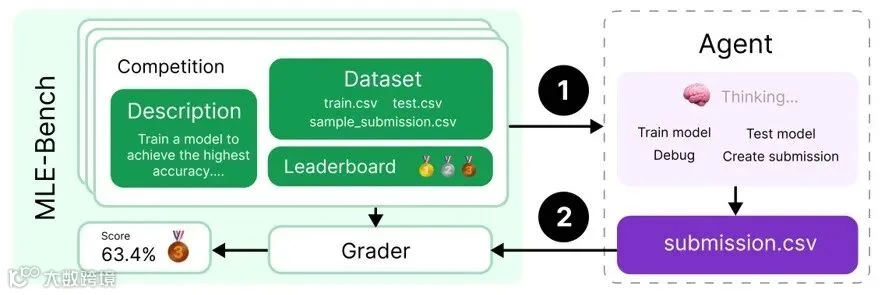
图 11|MLE-bench:一个离线的 Kaggle 竞赛环境。Agent 根据任务描述与数据进行训练和验证,生成 submission.csv;评测系统在本地评分,并与历史人类排行榜成绩比较(可反复尝试、逐步爬分)
故从基础能力看,RSI 与智能体无本质差异。多数仍是工具调用、探索、自验、修正等。唯一不同是 RSI 不确定性更高、需更强创造力、任务跨度更长,上下文管理等要求更多投入。
ZF:但 RSI 愿景是探索未知、自我改进。用现有 Benchmark 衡量,是否自相矛盾?
陈文虎:确然。当前多在受限设置下进行,与 RSI 愿景差距较大。RSI 核心在於探索人类未至之境,但 Benchmark 是人已知边界所造。用已知标尺衡量未知探索,本身不合理。
更真实的 RSI 应在真实环境中,人无预设上限、不知如何下手,由模型自行探索。此举难度大。当前 RSI Benchmark 多在受控环境围绕已知目标 hill climb,与真正未知探索尚有距离。
ZF:若 RSI 尚未达探索未知阶段,您更看好哪些场景先行落地?
陈文虎:我更信 RSI 在科学领域的价值,尤其在可控环境中确有助益。接触非计算机科学家时发现,其工作常重复冗余,未必极难但需持续监控,AI 介入应有裨益。多家 frontier lab 已证实此猜想,未来将见更多成果。
但此方向难成大众研究热点,因问题过于前沿,公众难解。证明一数学猜想,或仅数学家能懂,大众连题面都不识。研究者自身亦需深厚领域认知,如无竞赛经验直研 RSI for Math,实属不妥。
至某一阶段,Agentic 知识亦会饱和。模型已掌握者无需再教,欲助其进阶需更多数学洞察。终局将是人机协作。多数研究者难直接参与 AI for Science,但社会必从中受益。少数人用 AI 探索科学边界,其发现可迁移至日常产品、医学等领域,回馈全社会。价值巨大,但未必成全民研究范式。
ZF:从 Benchmarking 角度,研究类 Benchmark 与编程智能体范式无本质别,但实操差异大:非跑几个 test case 即止,需训练模型或高成本执行。验证亦难:单一分数或可,作 RL 环境则不行,如 GRPO 因成本高、无法采样 K 个 rollout 而不可行。有无办法避免高频高成本验证?
陈文虎:即便身为 Benchmark 研究者,亦觉单次测试成本过高——如百卡 GPU 跑十天出结果。尚无良策绕过,价值与成本常成正比。
可设计低成本 Benchmark,单卡 CPU 训一小时出结果,但其所反映价值远不及训练 nanoGPT 或 GPT-3。成本降则信号弱。故 RSI Benchmark 难成日常跟踪项,更宜在关键突破点或 checkpoint 时运行,提供强信号。
另一问题是方差大:Benchmark 自身方差叠加模型训练方差,挑战巨大。整体而言,RSI 评测确难,暂无完美方案,或需借助代理任务更为现实。
ZF:Benchmark 从 2023 至今,从二元判断转向开放式。但若开放式太难,是否会回退?如 Meta 内部用 Muse Spark,研究员打分“对错”或“是否有帮助”,变相回归问答题,唯人类打分难复制。
陈文虎:此即 flywheel data(飞轮数据)。当前前沿模型最大护城河,正是拥有 flywheel data。如 Claude Code、Codex 背后均有大量真实人类反馈数据,覆盖训练未见分布,构成关键壁垒。
ZF:人类数据中,提问、回答、验证何者更重要?
陈文虎:三者皆重。环境与提问至关重要,无环境则任务难复现。人类回答尤助不可验证任务,因含用户偏好,非模板化,而为模糊提问提供合理性。
清晰提问与带背景信息的模糊提问,后者实则不模糊,仅模型难处理。若后期获用户正反反馈,可用於 RL 训练,效益显著。
ZF:当前 Agentic 任务的 RL 研究,外部人员还能参与吗?抑或仅限大公司?
陈文虎:坦率讲,主线模型诸多工作恐仅大公司可为,此乃悲观现实。预训练、后训练已进入新阶段:任何增量均需海量算力与数据,学术界难获关键资源。环境搭建本身已极昂贵,遑论训练模型。外部研究者非不能做,但难在核心问题上与大公司同等条件竞争。

当 Benchmark 失去刻度:可用性、安全边界与经济价值如何接管 AI 进步
ZF:除 Benchmark 分数外,对话舒适性、可用性亦是指标。不仅关乎能力,更涉交互方式——如模型知何时求助于人、权限受阻时懂请示而非绕过、输出是否易懂。此事重要吗?您如何应对?
陈文虎:此事极重,属 usability 维度。若模型输出极专业但用户全然不懂,则无信息增量。我用 Claude 时常遇此况:代码库本就不熟,模型输出一堆术语,难辨对错。故模型完成后需良好呈现,让用户理解其行为。
行为亦关键:何时行动、何时请求许可、如何消歧义。此类研究多通过与产品互动实现:上线产品,采集用户飞轮数据,挖掘信号训练模型。亦可在产品内置评测,但非通用型,难供外界按统一设置测试。
自家产品可做高度定制化评测。如用户某处模型误求许可,可提取样本回放,检验后续模型是否改正。此法强依赖 harness 与环境,难普适化。开源跟踪困难,但前沿实验室内部可精准追踪。
ZF:用户不满动作如关闭、停止、打断,可否作评测信号?
陈文虎:对,此即 A/B 测试与用户情绪分析。用户使用路径、中断点皆含信号,可挖掘反馈用於优化。
ZF:安全与对齐(alignment)热议,如模型 RL 训练中逃沙箱、入侵系统等。安全 Benchmark、监管及价值观对齐,各家会有标准化流程吗?抑或逐案研究?
陈文虎:安全与对齐有客观底线,如禁造生物武器、禁欺凌用户,此类通用 Benchmark 得分通常极高,模型易学会。
真正难点在於微妙边界案例:特定语境下,某事或非安全问题。如患者无力就医,欲自制药询问模型,按准则模型拒答,但拒答或致患者死亡。此类案例如何处理,取决于公司倾向与准则。
当前各家公司安全 Benchmark 众多,但更像是必须通过的底线,而非需不断攀爬的分数。查阅 system card 可见三四十项 Benchmark,如生物武器、礼貌性等,模型得分多超 90。其易饱和,难作 hill climb 目标,更像代码提交前的必过测试,属基础保障。多数公司已部署,难点在於处理微妙细节案例。
ZF:最后问题:是否同意 AI 发展很大程度上由 Benchmark 驱动?Benchmark 日益困难、成本高企,若未来无法评测、无观测指标,提升是否将变难?
陈文虎:好问题。总体上我不同意 AI 进步由 Benchmark 驱动。需分视角:实操层面,实验室训练循环确由 Benchmark 驱动;但宏观看,模型能力跃迁多由经济价值驱动,而非 Benchmark。
典型案例如 GPT-4V 与 Claude Code。GPT-4V 非为刷榜而生,其在既有 Benchmark 上提升有限;Claude Code 亦未在特定 Benchmark 上大幅超越前身。测 Terminal-Bench 等,其分未必高出简易 harness 多少,却成 AI 里程碑。究其原因,在於巨大经济价值:GPT-4V 解决视觉相关难题;Claude Code 加速开发周期,遂被用於 RSI 任务。
ZF:是否最前沿研发者早已预见方向(如 2023 年想编程、2024 年想科研),先做出产品,外界才建 Benchmark?此或为时间错位,非泛化能力问题?
陈文虎:言之有理。Claude Code 发布前,内部必有 Benchmark,或为可用性指标。总体是先成产品,显价值,再建 Benchmark 供 hill climb。
很多时候,模型研发早於 Benchmark。模型演示後,众人察其经济潜力,方意识此为下一 frontier,“我们来建 Benchmark”。公司与学界从中提炼干净信号,转为 Benchmark,反哺实验室。若契合演示场景,下一循环即以该 Benchmark 驱动研发。关系如此。
尤以可用性为例——好不好用、符不符合习惯、能否让用户开心——模型持续进步,却无通用 Benchmark 可测。更多是在产品飞轮中建评测,模型随之提升。此层面已非 benchmark maxing(刷榜)。
ZF:故对难建 Benchmark 之事,只要经济成立,必有用户与反馈。即便是研究测评,也可不看量化指标,而看研究员使用后认可概率?
陈文虎:正是如此。有用户便有反馈;有反馈便可做 A/B 测试、解读信号、hill climb。无需 MMMU 或 MMLU-Pro 类事物驱动进度。研究测评亦属 Benchmarking,只是更复杂。