

我复刻并开源了全网爆火的 Jev(多模态版)
近日,由前 OpenAI 员工 Diogo Almeida 创立的公司推出了全新模型 Jev,迅速成为热议焦点。
Jev 是一款具备低成本、低延迟、高并发特性的决策模型,能够接收文本与候选项输入,并快速输出决策结果。
随着 Jev 的发布,全网掀起了复刻热潮,各类 OpenJev 项目相继涌现。笔者也进行了一项视觉化实验:Jev Visual,使模型能够基于图像进行选择、判断与打分,并支持本地运行。
项目地址如下,欢迎体验与 Star:
https://github.com/hr98w/jev-visual
什么是 Jev
Jev 是由 TypeSafe 推出的决策模型。用户只需提供当前状态与问题,模型即可直接返回可供程序调用的结果。其核心能力主要包含以下三种:
上述三类任务可在单次请求中并行处理,结果直接交付代码执行。Jev 的优势在于实现了低成本、低延迟且高并发的 LLM 决策,其输出不再是冗长的 Token 序列,而是简洁的选项(如 ABC)或二元判断(Yes/No)。
发布后,围绕 Jev 的讨论与应用实验迅速增加,涵盖了 Browser Use、AI 交易等热门方向。
jev-trader 尝试将其应用于链上交易:读取订单簿数据,决策买入或卖出,并由程序执行挂单。尽管高频交易最具话题性,但其实际可靠性尚待验证。
Browser Use 推出的 jev-ultrafast 项目,利用 Jev 选择下一步操作及页面元素。演示显示,一次包含文本输入与页面等待的 Google Flights 航班搜索耗时约 7.1 秒。
fast-jev-compaction 获得了 Jev 开发团队的认可,该项目将 Jev 的分类器引入 Coding Agent 的压缩(compaction)环节。
然而,目前的 Jev 仅支持文本与结构化状态输入,尚无法直接处理图像。 即便是官方展示的 Doom 游戏演示,输入模型的也是游戏状态数据而非画面。
那么,能否构建一个支持视觉的版本?
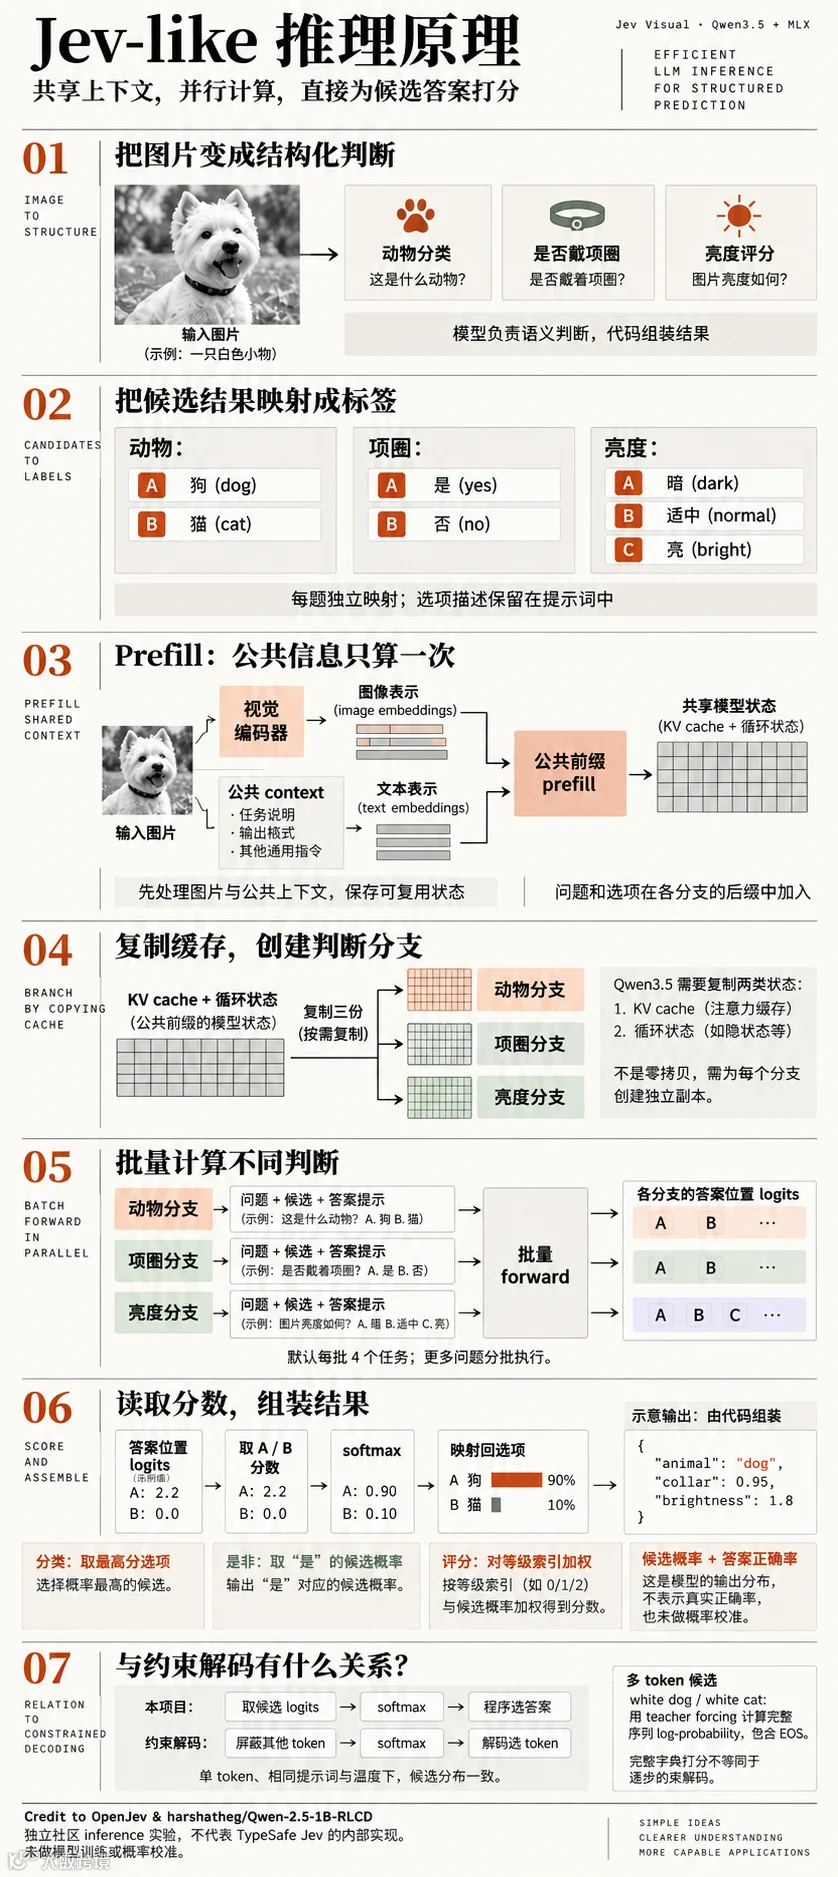
Jev 发布不久,社区便出现了OpenJev 等开源尝试:利用现有模型直接读取候选答案分数,对同一上下文仅计算一次,供多个问题复用,从而省去逐字生成答案的过程。
笔者借鉴上述思路,替换为支持视觉的 Qwen3.5-0.8B 模型,并利用 MLX 在 Mac 上运行。 图片与公共上下文预先计算一次,随后批量对不同问题的选项进行打分,最终由代码组装结果。
以下为两个 Demo 展示其功能:
AI 分拣工厂: 识别传送带截图中的物品,并选择对应的分拣通道。
打砖块: 分析游戏截图,判断球体所在区域编号,再由程序控制挡板移动。此为简化版的视觉分类玩法,目前尚未能稳定通关。
关于复刻原理的说明与免责:本项目仅在推理层复现了 Jev 的形式,其效率不及成熟推理框架,也非 Jev 的官方实现原理,但作为 inference 领域的入门实践仍具参考价值。
代码、运行方法及 Demo 均已开源,感兴趣的用户可在 Mac 上尝试,也欢迎大家 Star:
https://github.com/hr98w/jev-visual