

导读智能体正在走进需要长期陪伴的对话场景,记忆能力成了硬指标。怎么判断一个 AI“记性好”?现有的答案几乎都来自同一种考法:让它在长对话里做“记住并复述”的题,答对得多,就是记性好。这考的是“会不会答题”,而陪伴要的是“会不会惦记”:几个月前你随口说的一句话,不会有人再针对它直接问起,但它该记得,还该在相关的时刻主动想起来。
1. 现有的记忆考试,考的是“背”不是“想”
2. LoCoMo-Plus:把“记住了”和“会调用”分开考
3. T-Mem 的答案:写入时就为记忆铺好联想的线索
出品社区|DataFun
现有的记忆考试,考的是“背”不是“想”
现有长期对话记忆基准,主体仍然是显式事实召回:相关的信息在早前的对话里被明确说过,之后的提问也和它有较强的语义对齐——你问“他叫什么名字、上次聊到几点、那个日子是哪天”,模型把明确出现过的信息复述出来,就算答对。即便 LoCoMo 里也有 open domain 这类需要跨过不明显语义关联的题型,在整个卷面里占比很小,而且本质上仍是“把记忆当作检索”:相关信息被假设为可以直接指认、可以语义匹配。
这样的设定能规模化评测,却也只覆盖了自然对话里很小一部分记忆行为。
现实中,一句恰当的回应,往往依赖一些从来没有人直接问过的东西:对方的处境、藏在话里的目标、没说出口的限制。比如一个多月前,你向 AI 提起过"我周末基本都留给家人,不太想安排社交活动";今天你问它:"同事约我这周休息的时候去爬山,你说我去不去?问题里既没有“周末”,也没有“家人”和“不想社交”,但一个真正懂你的 AI,应该想起你当初那句话,反问你一句:“你休息日不是说要留时间陪家人吗?还想去吗?”而不是顺着问题直接帮你把行程定下来。
这类依赖隐式约束的记忆,有个专门的名字——认知记忆(cognitive memory):记住的不只是对话里明确说过的事实,还包括从对话中推断出来的用户状态、长期目标与价值偏好,并在合适的时机真正把它们用上。
问题在于,现有基准几乎测不到它:它们的判分看的是字面或语义相似,而这类题没有“可召回的事实”,单独看每个答案都说得通,恰当与否只取决于是否记得并遵守了更早的约束——用原来的考法,根本无从判起。
LoCoMo-Plus:把“记住了”和“会调用”分开考
这个空白,被一篇刚被 ACL 2026 主会议接收的论文正面填上:LoCoMo-Plus。
论文举了这样一个例子:一个用户正在备考,聊天时说过“想尽量减少干扰”。很久之后,他问:“我该不该开始追那部大家都在聊的新剧?”单独看这句提问,合理的回答有很多种——追就完了,放松一下也挺好;但真正的人会想到要提醒他还在备考这件事,尽管这句话本身跟“备考”毫无字面和语义的相似度。而这恰好是当前记忆系统的设计盲点:当需要召回的记忆和用户的发言没有字面或语义层面相似时,很难将这些具备深层关联的长期记忆召回。
这反而才是人形成认知记忆的方式:不是被问到才想起,而是在恰当的场合被不相干的一句话悄悄勾起。一个长期陪伴的 AI 想有“活人感”,缺的往往不是像备忘录一样忠诚地将过去的所有事件“归档”,而是这种认知记忆的能力。这个能力直接决定了它是“备忘录”还是“懂你的人”。

图 1|LoCoMo-Plus:“事实性记忆评测”与“生物记忆更丰富的联想本质”之间的差距示意,也正是 LoCoMo-Plus 走向超越事实的认知记忆评测的出发点
构建一个基准来评测记忆系统的联想能力并不容易:这种题没法用“考查字面或语义相似的记忆能不能被找到”的套路生成。LoCoMo-Plus 为此设计了一套构造流程,把 cue 和对应的 trigger 问题从零写出,同时确保两者之间不留任何字面或语义相似线索,杜绝模型靠“看着眼熟”蒙对。一道真正考验认知记忆的题,就此第一次被系统地造了出来,这正是 LoCoMo-Plus 的核心贡献,也是论文标题"beyond-factual(超越事实)"的分量所在。
论文展示的实验结果也印证了这道新考题的分量:在认知记忆场景下,骨干大模型、检索增强方法、专门的记忆系统,表现全线走低。
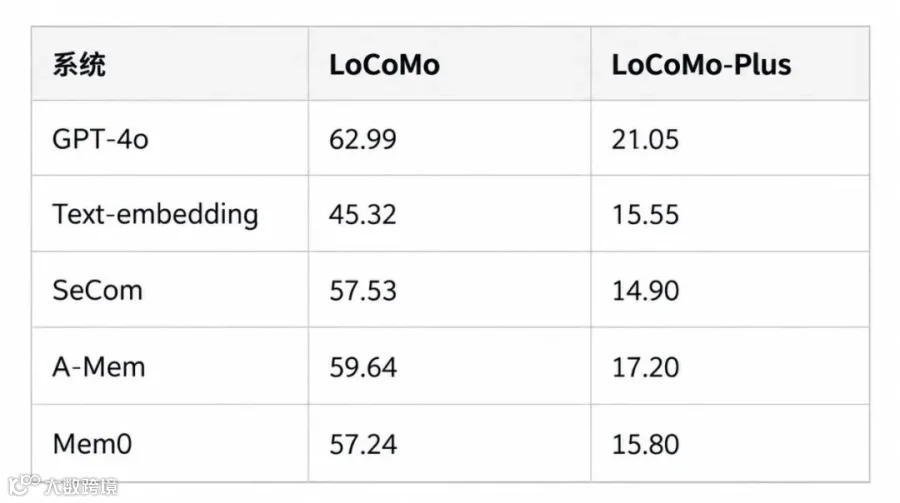
表 1|各系统在 LoCoMo 与 LoCoMo-Plus 上的表现(以上数据来自 LoCoMo-Plus 论文)
换一张卷子,认知记忆相较于事实记忆的分数全线跌去六七成;更值得注意的是,专门做记忆的 Mem0、A-Mem 并没有比通用模型更好——“记住事实”的能力,没法迁移到“遵守隐式约束”上。这正是这张新卷子的意义:让“谁真的具备认知记忆”第一次有了可以比较的答案。
T-Mem 的答案:写入时就为记忆铺好联想的线索
如果说 LoCoMo-Plus 把“认知记忆”从一种说法,变成了一道能被考出来的题,T-Mem 就是这道题的解法:前者负责把问题测出来、证明它确实没人答得上,后者负责把它真正解决掉。没有 LoCoMo-Plus,认知记忆无从被单独度量;没有 T-Mem,LoCoMo-Plus 指出的空白也一直空着。这项工作已被 EMNLP 2026 主会议接收,代码与数据现已开源。
为什么要在写入时做准备?认知科学里有一个经典概念叫“情景未来思维”(episodic future thinking):大脑在记住一段经历的同时,也在为“这段经历将来可能被怎样想起”做着准备——人的记忆生来就不是档案馆,而是面向未来的。
T-Mem 的做法,正是把这一原理搬进工程:既然问题出在“该想起的时候想不起来”,那就在记忆写入时,为每条记忆和每个场景同时生成一组“将来可能会被怎样问起”的联想线索。(论文里叫 Triggers)检索时,问题先跟这些线索比对,而不是只跟记忆原文比对:线索命中了,对应的记忆就被翻出来。这样一来,字面毫不相干、语义确实相关的问题,也能唤起该想起的记忆。描述与联想两条检索路径、事实与场景两种粒度,都在这套设计之内。
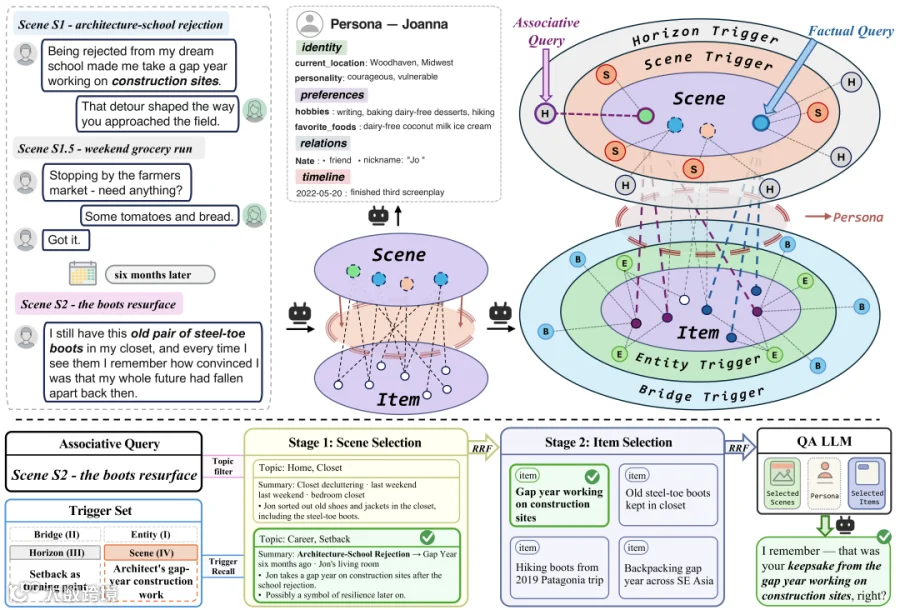
图 2|T-Mem 整体框架示意——写入侧为记忆预写触发线索,读取侧线索可直接参与检索
结果也印证了 LoCoMo-Plus 这套考卷的价值:
· 在 LoCoMo 上,T-Mem 达到 80.26%,刷新 SOTA,证明基础的事实记忆不输任何主流系统;
· 到了专测认知记忆的 LoCoMo-Plus,主流系统从 LoCoMo 跌落到 LoCoMo-Plus,平均要掉 28–50 个百分点;
· 而 T-Mem 只掉了 5.45 个百分点,74.81%依然刷新 SOTA。

图 3|各系统从 LoCoMo 到 LoCoMo-Plus 的跨域落差对比柱状图
差距背后是一件事:LoCoMo-Plus 证明了认知记忆确实是主流方案的结构性盲区,T-Mem 证明了这块盲区可以被补上。两者放在一起,AI 长期记忆的评判标准才算真正迈过“复述”这道门槛——记忆不再等于背得出来,而在于该想起的时候,真的想得起。
T-Mem 作者团队来自腾讯 PCG,论文已被 EMNLP 2026 主会议接收,代码与数据现已开源。
以上工作的作者团队来自腾讯 PCG,主要贡献者包括郭伟东、王达凯、汪子轩、刘辉和徐羽等。该团队长期专注角色扮演领域的研究,在指令遵循、记忆等领域已经发表多篇论文,本文的工作已在相关项目中上线。
参考来源
T-Mem 代码与数据:https://github.com/Sherlockwz/T-Mem
T-Mem 论文:https://arxiv.org/abs/2606.15405
LoCoMo-Plus 代码与评估框架:https://github.com/xjtuleeyf/Locomo-Plus
LoCoMo-Plus 论文:https://arxiv.org/abs/2602.10715
往期推荐
数据要素下一站:数据安全织域!
OpenAI 杀进数据分析,BI 反而成了必选项
Palantir 真正的护城河,终于看清了
用自然语言建数仓:AI 重构数仓开发全流程
当 Agent 成为数据的新用户,最大的风险点在哪?
国央企验证过的 AI Ready 数据底座,一次讲透!
模型越多越贵、越乱?PPIO 用智能模型网关统一选型、路由与账单
AI/Agent 进入企业数据平台:从可查询到可执行的技术现状
智能体架构与实践:构建下一代推荐与搜索系统
面向真实供应链场景,顺丰联合浙江大学提出三维装箱新算法