作者 | 周雅
来源 | 科技行者
日常与 AI 语音交互时,常遇两极分化:要么响应极速但处理复杂任务“犯傻”,要么深度思考导致对话卡顿,节奏尴尬。
这是实时对话模型面临的核心矛盾:“深度思考”与“流畅对话”难以兼得。模型越需深思,实时性越差,导致人机对话不同频。
美国当地时间 9 月 15 日,Google 发布两款实时对话模型Gemini 3.8 Live和Gemini 3.8 Live Extended Thinking,旨在解决此矛盾。此次升级聚焦于能一边对话、一边推理和调用工具的语音 Agent。
两款模型定位清晰:
Gemini 3.8 Live主打轻量、低延迟、低成本,面向实时对话场景。除语音外,支持近实时视觉理解(图片/视频)、工具调用及 Google Search Grounding,适用于客服、日常助手、车载交互等对速度与成本敏感的场景。
Gemini 3.8 Live Extended Thinking为“深度思考”版,专注复杂推理和多步骤任务。它可后台持续思考、调用 API 并等待结果,前台则保持对话流畅。更适合行程规划、复杂客服、销售助手等需边聊边办的场景。
01. 对话质量如何?
Speech to Speech Index由第三方机构 Artificial Analysis 维护,综合评估语音 Agent 在语音推理、智能体任务表现、用户偏好、任务成功率四维度的表现,是行业权威指数。
Gemini 3.8 Live Extended Thinking (High) 以82.6 分登顶,超越GPT-Live-1 (Astra, Medium)的81.5 分及Grok Voice Think Fast 2.0 High的81.3 分。Gemini 3.8 Live 以76.0 分位列第五。

图:Artificial Analysis Speech to Speech Quality Index 位次对比(来源:Artificial Analysis)
值得注意的是,Google 上一代 3.1 系列模型得分均在 72 分以下,落后 3.8 系列超 10 分,证实此次为实质性的能力跃迁。
前三名分差仅在 1.5 分内,表明主流模型在通用对话质量上已趋近,未来竞争分野将集中在具体任务执行力和成本维度。
02. 完成 Agentic 任务如何?
Gemini 3.8 Live Extended Thinking (High)在τ-Voice 测试中以68.6%的通过率居首,微幅领先GPT-Live-1 (Astra, medium)的67.9%;OpenAI 的GPT-Live-1 (Sol, low)以59.3%排第三。

τ-Voice 涵盖航空、零售、电信三大子域,任务特征各异:航空涉及改签退款,零售涉及订单争议,电信涉及套餐账单。
分行业看,Gemini 3.8 Live Extended Thinking在电信场景以84%胜率第一(领先 Astra 的 80%);航空场景以72%并列第一;但在零售场景以50%略逊于 Astra 的 52%。

另一关键基准是 Sierra 的τ³-Banking,专测语音 Agent 在银行业务中的端到端能力,涵盖账户查询、转账验证、争议处理、身份认证等高合规、多步流程。
Gemini 3.8 Live Extended Thinking (High) 以35.1%通过率夺魁,GPT-Live-1 Astra (Medium) 为32.0%,xAI-Realtime 仅16.5%,其余模型均低于 12%。

对比发现,Gemini 在通用τ-Voice 仅领先 Astra 0.7 个百分点,但在高难度的银行业务测试中,优势扩大至 3.1 个百分点。这表明:在需知识检索、规则理解及多步执行的复杂任务中,Gemini 3.8 Live Extended Thinking 的领先优势显著。
然而,35.1% 的绝对通过率也揭示现状:即便最优模型,在处理复杂业务流程时仍有很大提升空间。落地生产环境仍需严格的权限控制、流程约束及人工兜底。
03. 语音推理如何?
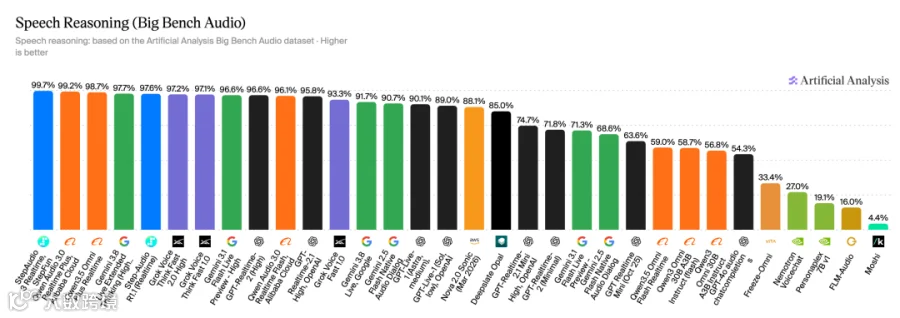
Big Bench Audio评估模型音频推理能力,含语音理解、逻辑判断和内容推断。Gemini 3.8 Live Extended Thinking 得分为97.7%。
榜单前三均由中国团队占据:StepFun的StepAudio 3 Realtime以99.7%居首,阿里云的Qwen Audio 3.0 Realtime Plus以99.2%次之,Qwen3.5 Omni Plus Realtime以98.7%排第三。Gemini 位列第四。
此结果极具参考价值。语音推理是 Agent 的底层核心能力,数据表明中国团队在该领域已跻身全球第一梯队。
04. 成本如何?
若说性能是“窄幅领先”,成本则是 Google 的“杀手锏”。
以“每小时输入音频成本”计,Gemini 3.8 Live 仅0.84 美元/小时,居所有前沿模型最低。Gemini 系列(含 2.5 Flash Native Audio Dialog、3.1 Flash Live)包揽前四,成本均在1.75 美元/小时以下。
3.8 Live Extended Thinking (High) 成本为3.50 美元/小时,属中档,仍低于 GPT-Realtime-2 (High) 的 4.14 美元、GPT-Live-1 (Astra) 的 5.83 美元及 Grok 的 4.80 美元。最贵的 GPT-Realtime-2.1 High 高达 10.75 美元/小时,是其三倍多。

图:每小时输入音频成本对比(Big Bench Audio 子集,数据来源:Artificial Analysis)
Google 直接公开成本对比图,争夺企业市场的意图明确。
若将τ-Voice 通过率与成本结合,Gemini 3.8 Live Extended Thinking 位于“最具吸引力象限”(高通过率 + 相对低成本)。同象限虽有其他模型,但 Gemini 在性价比上优势明显。

图:τ-Voice 通过率 vs 每小时输入音频成本,绿色区域为"最具吸引力象限"
05. 从人工偏好到帕累托前沿
除各项 SOTA 指标外,Google 还引用了 ServiceNow 的EVA-Bench测试作为佐证。
测试显示,3.8 Live 两款模型推动了复杂工作流中“任务准确率”与“对话质量”的帕累托前沿(Pareto Frontier)。
帕累托前沿指两项互斥指标的最佳平衡点。Google 意在表明,Gemini 3.8 Live 系列在保持对话自然流畅的同时,显著提升了任务执行准确率。

该测试基于 Gemini Enterprise Agent Platform 的 Live API,比单纯模型测试更贴近企业实际应用环境(注:仍属标准化基准,非真实生产数据)。
06. 响应时间如何?
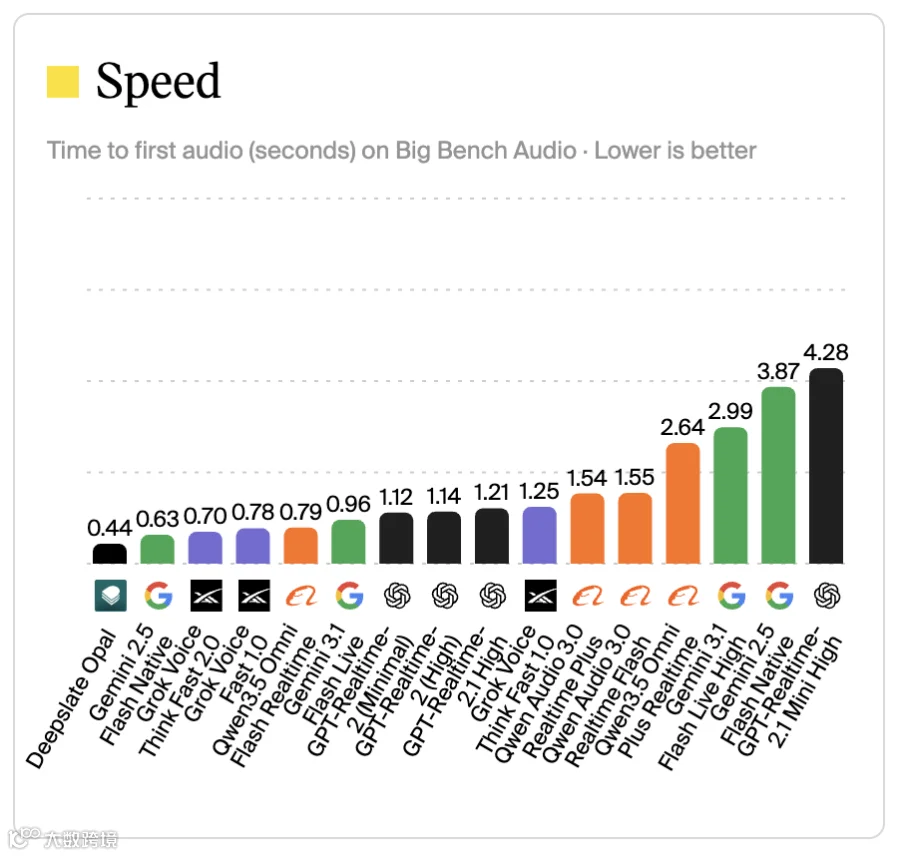
3.8 Live Extended Thinking 虽增强推理,但在速度上有所妥协。Time to First Audio(首字响应时间)数据显示:Extended Thinking 版为1.35 秒,Gemini 3.8 Live 为1.18 秒;而 Grok Voice Think Fast 2.0 High 为 0.70 秒,Google 2.5 Flash Native Audio Dialog 仅需 0.63 秒。
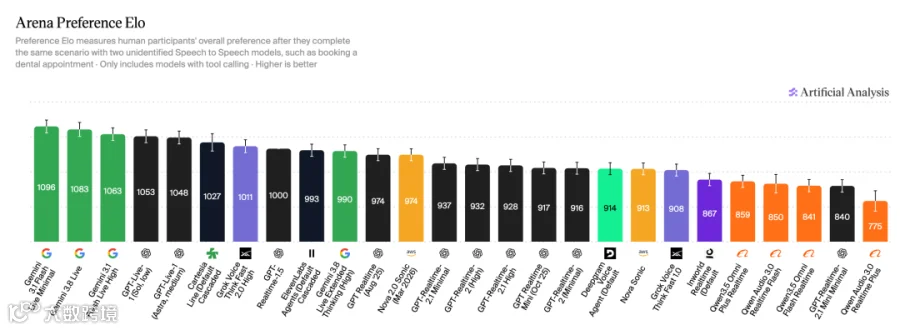
用户偏好方面,Speech Agent Arena通过人工双盲投票评估听感与自然度。
在 Preference Elo 榜单上,Gemini 模型包揽前三。3.8 Live 以1083 分居第二,3.8 Live Extended Thinking 以990 分居第三,榜首为 Gemini 3.1 Flash Live Minimal(1096 分)。
07. 底层能力
Gemini 3.8 Live 系列在产品的设计上有三项关键升级:
一是“边想边说”(reason and speak simultaneously)。传统模式在复杂推理时会陷入静默,新模型会先用口语化提示(如"Let me check that...")接住对话,后台同步推理并通过实时进度叙述让用户知晓进展,消除了“系统卡顿”的错觉。
二是支持97 种语言自动切换,可在对话中途识别并适应用户的语言变化,极大利好跨境业务。
三是异步函数调用,模型可在不打断对话的情况下后台执行工具与 API 调用,无需用户等待返回结果,这对多步业务流程至关重要。
部署方面,Google 通过 Live API 向 Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel、Vision Agents 等开发者平台开放,降低接入门槛。
企业侧,Salesforce、Genspark、ServiceNow 等多家公司已启动测试或部署。内部产品线上,Extended Thinking 版已接入 Google Workspace(Docs/Gmail/Keep Live),标准版接入 Search Live。企业客户可通过 Gemini Enterprise 私有预览使用。
安全层面,所有音频输出均嵌入 SynthID 不可感知水印,确保 AI 生成内容可检测。
随着三大前沿模型能力趋同,竞争重心正从“模型能力”转向“场景应用”与“实际成本”。此次发布为企业采购与开发者提供了清晰的参考坐标。
科技行者团队出品