实测智象HiDream-O1-Video视频模型:嘻哈说唱、NBA绝杀,视频生成开始理解真实世界
 智东西
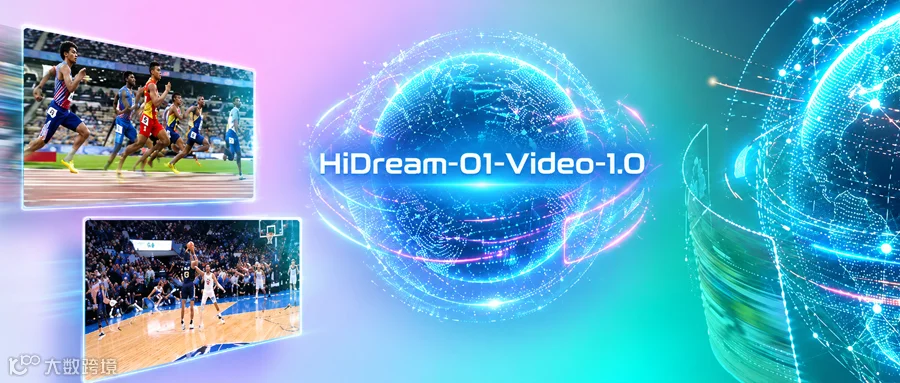
近几月,AI 视频生成赛道竞争白热化。从字节 Seedance 2.5、MiniMax H3 到阿里 Wan3.0,再到 9 月智象发布的 HiDream-O1-Video-1.0(简称 HiDream V1),中国模型在全球权威榜单头部形成集群效应,行业格局正从“单点领先”转向“多家并进”。
作为创业公司,智象的入局标志着全球视频模型头部阵营中出现了新的力量。随着 AI 视频从单一内容创作走向影视、广告等生产场景,竞争焦点已从画质与时长,升级为对复杂运动及物理规律的理解。视频生成正成为探索世界模型的关键路径。
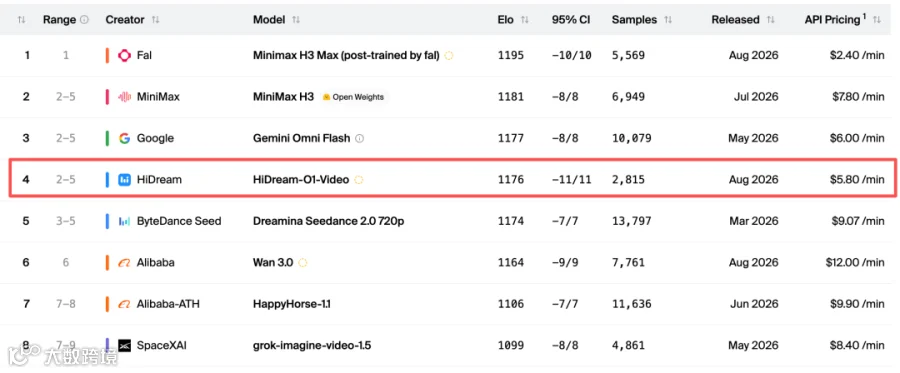
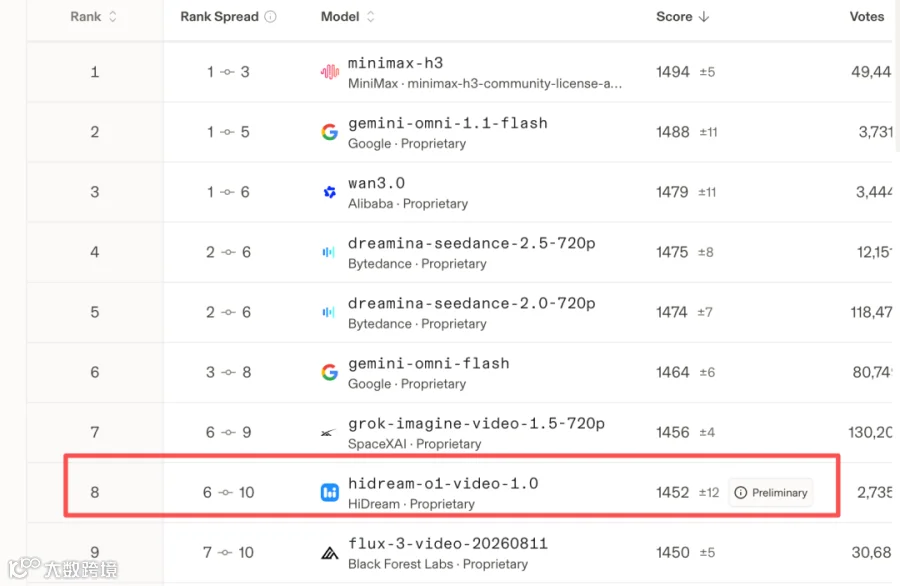
9 月 15 日,智象发布原生全模态音视频生成模型 HiDream V1。该模型在 Artificial Analysis 图生视频榜排名第 4,在 Arena.ai 榜单排名第 8,双双跻身全球前十,正式进入第一梯队。
HiDream V1 的发布,补上了智象围绕世界模型路线构建的最后一块拼图。至此,智象在图像、3D 交互、具身及视频方向的模型矩阵全面完成闭环,标志着其正式跻身视频生成核心决赛圈。
听得懂人话,也敢不凑时长
当前视频生成工具往往依赖详尽的专业提示词,而真实场景中用户输入多为口语化或模糊指令。HiDream V1 通过多模态意图理解模块,将自然语言拆解为包含人物、动作、镜头、光影等要素的结构化分镜,再进入联合生成,有效降低了使用门槛。
在时长控制上,HiDream V1 摒弃了固定窗口模式,转而根据事件展开与叙事节奏动态规划时长,原生支持 5 至 20 秒任意长度。配合 1080p 高保真输出,实现了从“按词生成画面”到“理解意图组织镜头”的跨越。
实测显示,在面对“下班累了抚摸小狗”的模糊语音指令时,模型不仅还原了人与狗的互动,还精准捕捉了人物起身时的疲惫姿态。而在测试动态时长能力时,面对简短提示词,模型未强行注水,而是生成了符合逻辑的 7 秒短视频,完整呈现了猫咪抬头与懒洋洋的状态。
在音画一致性测试中,即便提示词遗漏歌词,HiDream V1 也能自动补全并实现精准的口型同步。在生成的嘻哈音乐节场景中,鼓点、贝斯、灯光与人物动作高度协同,展现了强大的多模态对齐能力。
从生成动作到理解运动规律:一句话生成超燃百米飞人大战、NBA 绝杀
让物体动起来易,让其遵循物理规律动难。HiDream V1 强化了对重力、碰撞、惯性及光影衰减的建模,致力于解决视频中的因果逻辑问题。
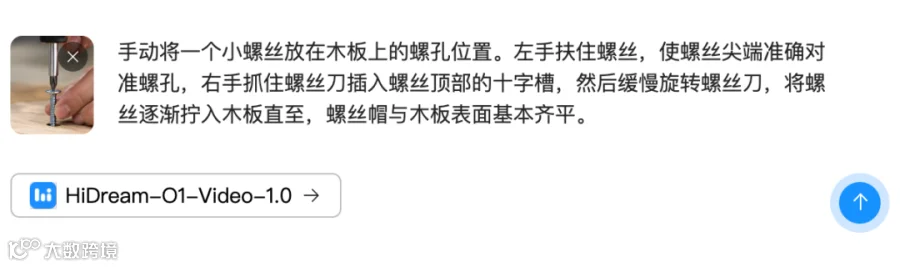
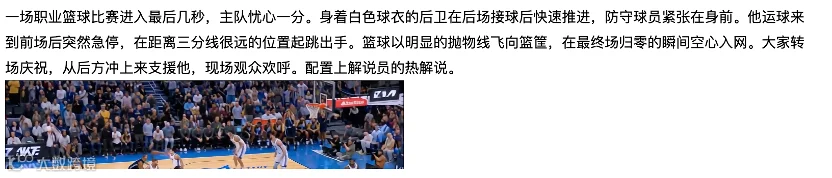
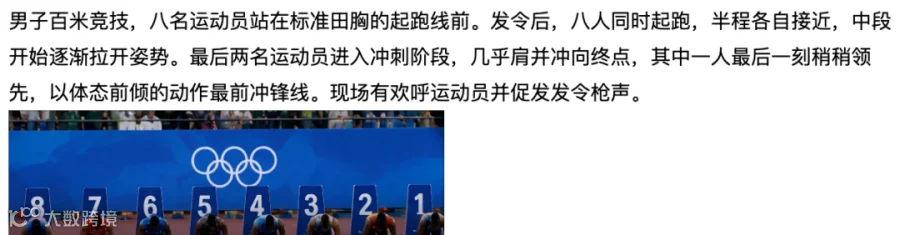
在精细操作测试中,模型成功生成了双手协作拧螺丝的过程,工具与物体的空间关系自然连贯。在多人运动场景下,无论是 NBA 绝杀时的肌肉线条与篮球轨迹,还是奥运会百米赛跑中运动员的姿态与相对位置变化,HiDream V1 均表现出符合现实物理规律的运动逻辑,且无明显肢体穿模现象。
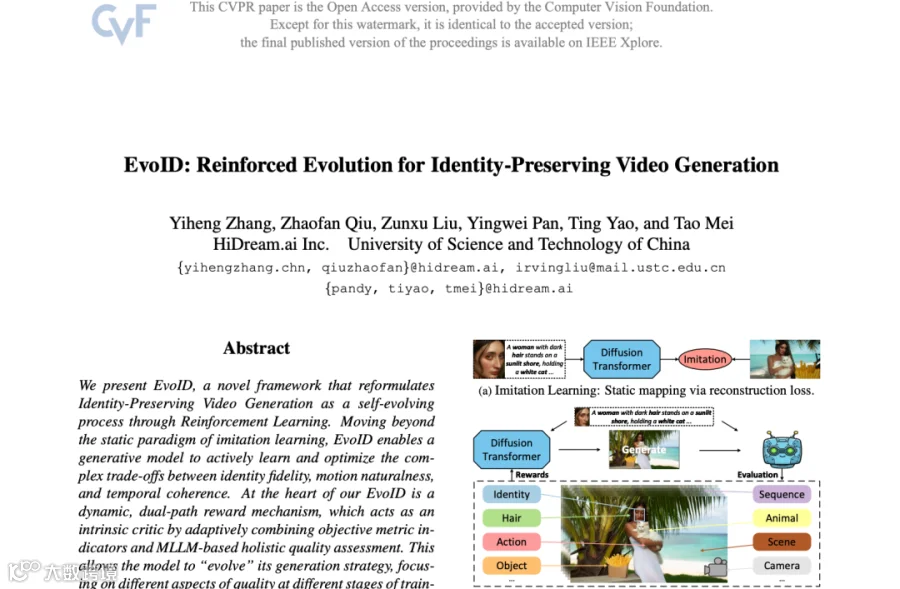
这一能力源于智象“先规划、后联合生成、再以多模态 Reward 对齐”的技术思路。其后训练阶段采用 Diffusion RL 技术,相关成果 DMSampler、DiffusionCompass、EvoID 三篇论文分别收录于 2026 年 ICML、ECCV、CVPR 三大顶会,为模型提供了坚实的理论与技术支撑。
智象联合创始人兼 CTO 表示,视频生成的代际进化在于模型是否真正理解创作者意图与物理规律。HiDream V1 基于原生全模态架构,实现了从“看得清、动得顺”到“听得懂、说得准、演得连贯”的跃迁。
不止路线图:一个 UiT 底座四大模型的体系化落地
HiDream V1 的发布标志着智象“图像、视频、3D、具身”四大模型方向全面就位。这四个模型共享 UiT(Unified Transformer)统一底座,能够在同一表征空间处理多模态数据,分别对应视觉生成、时间维度、交互环境与真实动作反馈四个观察世界的切面。
目前,智象旗下各模型均在权威榜单表现优异:HiDream-O1-Image 文生图能力居中国第一、全球第三;HiDream-O1-World 在交互式世界模型基准中物理一致性夺魁;HiDream-O1-Embodied 在鲁棒性子榜登顶。HiDream V1 的加入,进一步完善了这一同源演进的模型矩阵。
智象 CEO 梅涛指出,公司致力于构建“一个原生全模态底座、四大模型同源演进”的体系,而非独立的能力线。这一布局使其在全球世界模型探索中,形成了从视觉生成到真实世界交互的完整闭环。
结语:中国 AI 视频生成再添一股全球竞争力量
实测表明,HiDream V1 在连续动作、人物关系、物理规律及音画同步等方面表现卓越。特别是在高动态的体育场景中,模型展现出极强的时空预测能力,未出现物理定律崩坏的情况。
这折射出视频生成向世界模型演进的趋势:当模型能够理解时间、空间与因果关系,其能力边界将不断拓展,逐渐成为模拟真实世界的重要路径。HiDream V1 的问世,不仅彰显了智象的技术实力,也为中国 AI 视频生成在全球竞争中增添了重要砝码。