


若将当前的 AI 研究智能体比作一支探索队伍,大模型决定了队员的智力上限,工具定义了其能力边界,而搜索策略则主导了行进方向、路线取舍及算力分配。谷歌最新发布的 Dream-RSI,并未直接改进模型本身,而是聚焦于优化这一关键的“决策层”。
近日,来自 Google、Google DeepMind、马里兰大学帕克分校和弗吉尼亚大学的研究团队联合发布论文《Dream-RSI:通过演化世界实现递归自我改进》。
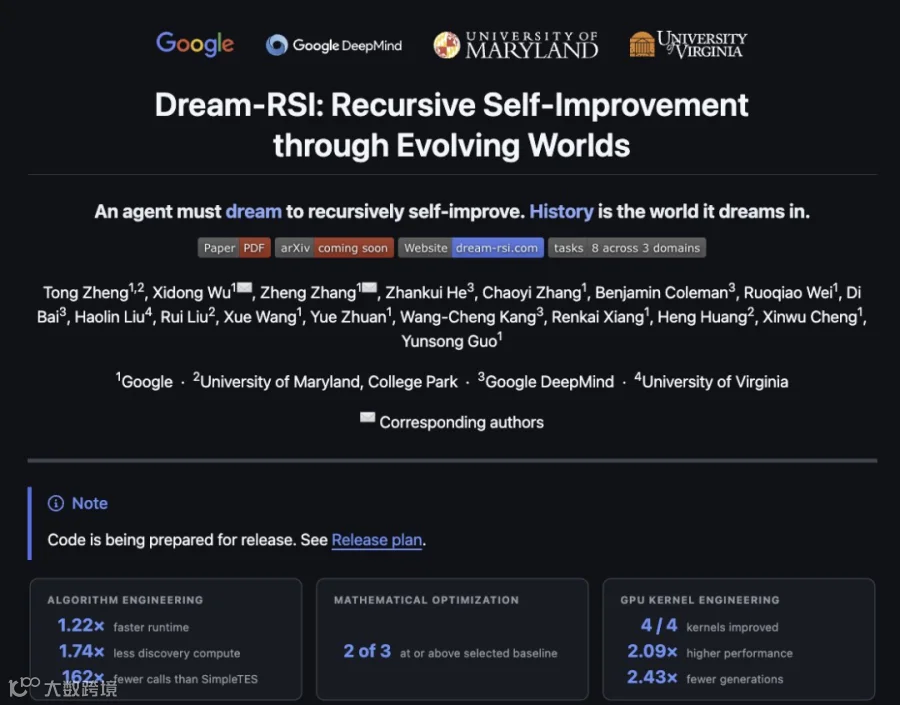
该研究提出了一种新的递归自我改进框架:AI 能够将过往任务的搜索记录转化为“回放模拟器”。无需重新训练模型或反复执行真实任务,系统即可在模拟器中测试并改写自身的探索策略。
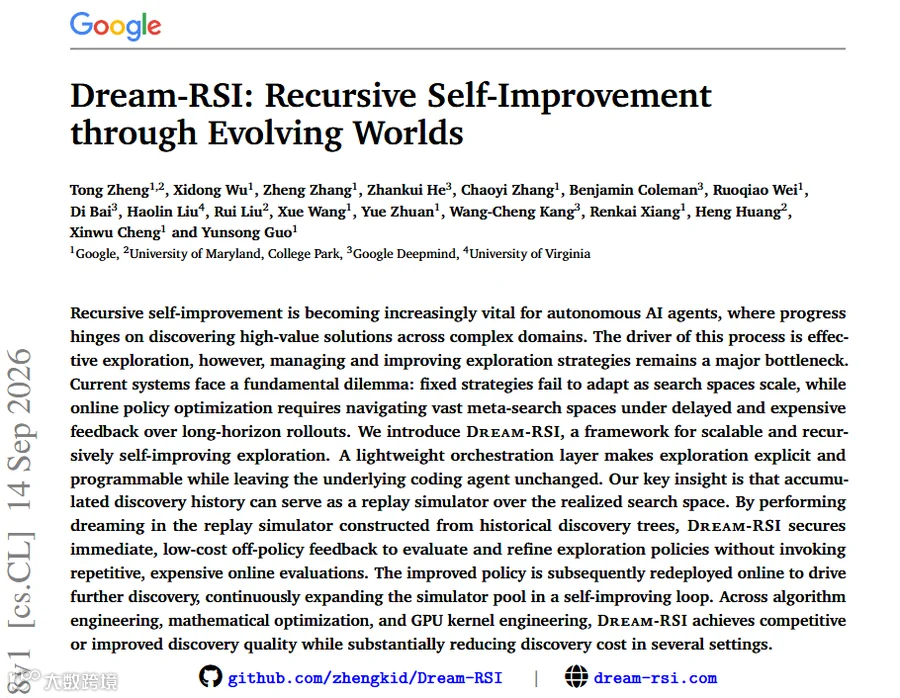
改进后的策略随后被投入真实任务,产生新的探索历史以扩充模拟器,从而形成“行动—记录—做梦—改进—再行动”的闭环。研究团队将这一过程形象地称为"Dreaming"(做梦)。
实验数据显示,在算法工程、数学优化和 GPU 内核优化三类任务中,Dream-RSI 能以更少的模型调用获得相当甚至更优的结果。特别是在 Lasso 算法发现任务中,其调用次数较现有系统最高减少约 162 倍;在 GPU Kernel 任务中,系统在相似计算预算下,将内核性能提升至固定搜索策略的 2.09 倍。

值得注意的是,Dream-RSI 并非科幻叙事中"AI 自行训练出更强 AI"的完全体。它未修改 Gemini 的模型权重,真正进化的是模型外部的搜索与编排代码。准确而言,这是一种发生在智能体 Harness 或元探索层的递归自我改进,而非基础模型能力的无限递归增长。
AI 开始改进“自己如何寻找答案”
过去一年,AI 驱动的科研与算法发现正从单次问答转向大规模、长周期的自动搜索。以 Google DeepMind 的 AlphaEvolve 为例,系统通过数百甚至数千轮“生成—执行—评分—修改”的循环来逼近最优解。
此类系统的效能不仅取决于底层模型强度,更受制于一套隐蔽的机制:探索策略。面对海量候选方案,智能体需决策是深耕当前最优解还是开辟新路径、何时放弃无效方向、并行实验的数量以及资源分配时机等。
目前,这些策略多由研究人员预设且在执行期间保持固定。然而,随着搜索空间扩大和任务周期拉长,固定策略易陷入无效循环,如过度优化接近上限的方案或因早期失败过早放弃潜力路线。
虽然让 AI 在线测试不同策略是直接解决方案,但每次测试均需重新运行完整任务,导致计算成本激增。Dream-RSI 的核心突破,正是在于绕开了这部分高昂成本。
把失败记录变成可反复进入的“世界”
Dream-RSI 的关键设计在于将过去的搜索记录重组为一棵完整的“发现树”。树中每个节点对应一次真实的生成与评估过程,包含工作状态、候选程序、执行结果及得分等详细信息。
当真实搜索结束后,整棵发现树被转化为回放模拟器。由于节点已包含真实结果,系统在测试新策略时无需再次调用模型或运行评估程序,只需让新策略在历史记录中重做选择:
- 若当时探索另一分支,结果会如何?
- 若增加并行任务,能否更早找到高分答案?
- 若在特定轮次停止无进展方向,能节省多少调用?
这些问题的答案已蕴含在历史发现树中。新策略通过按不同顺序读取节点,即可估算其在真实运行中的潜在效果。这一过程被称为“做梦”,即系统在过去经验构成的世界中模拟大量可能的行动路线,其思路与基于世界模型的强化学习有异曲同工之妙。
与 DeepMind 此前的 Dreamer 系列不同,Dream-RSI 未训练新的世界模型来预测未知结果,其模拟器完全由已发生的真实记录组成。因此,在已记录范围内回放结果是确定的,但它无法预测历史记录之外的新分支。
三步形成自我改进闭环
Dream-RSI 的运行流程分为三个阶段:
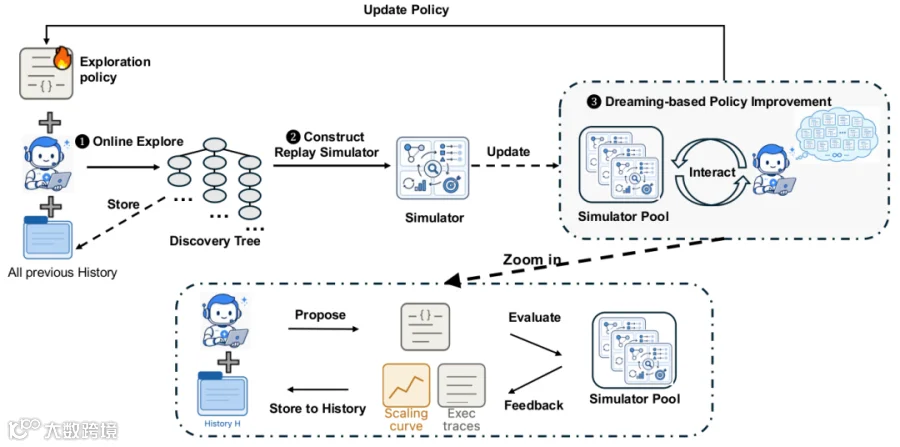
第一步:真实探索。当前搜索策略调度 Gemini 编程智能体,决定生成节点、开启并行分支及停止时机,最终形成新的发现树。
第二步:构建回放模拟器。系统将本轮及此前所有轮次的发现树加入模拟器池,将一次性消耗的经验转化为后续优化数据。
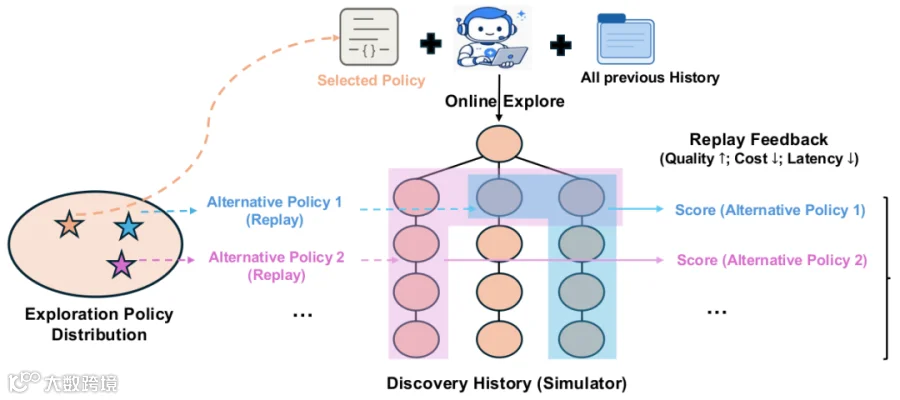
第三步:离线“做梦”。另一个固定的大模型智能体负责修改探索策略代码,生成多个候选策略并在历史模拟器中进行测试。评分指标包括答案质量、模型调用消耗量及并行资源利用效率。得分最高的策略将被部署到下一轮真实搜索中。
在此循环中,Gemini 模型、任务评估器和执行接口保持不变,变化的仅是控制搜索宽度、深度及停止规则的轻量级编排代码。这意味着 Dream-RSI 实现的是“智能体修改自己使用模型的方式”,而非“模型修改自身参数”。
Lasso 算法:调用量最高减少约 162 倍
研究团队首先在 Lasso Regularization Path 算法工程任务上测试了 Dream-RSI。该任务要求 AI 在保证数值正确的前提下,发现运行速度更快的 Lasso 路径求解器。
实验显示,以 Gemini 3.1 Pro 为底层智能体时,Dream-RSI 在使用 317 次调用的情况下,将平均运行时间缩短至 2931.0 毫秒,相比固定策略的 550 次调用和 3587.1 毫秒,结果更优且调用量降低约 42%。
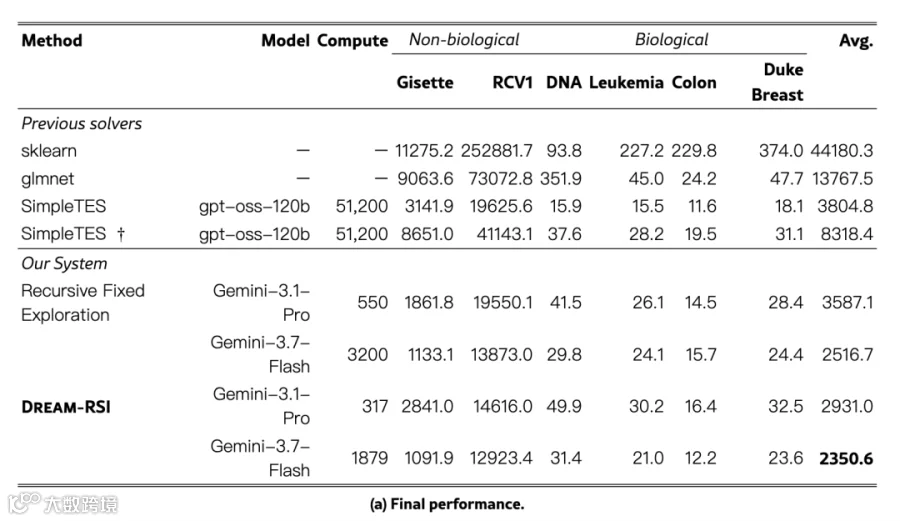
在使用 Gemini 3.7 Flash 时,Dream-RSI 同样以更少的调用次数(1879 次 vs 3200 次)实现了更低的平均运行时间(2350.6 毫秒 vs 2516.7 毫秒)。

与使用 GPT-OSS-120B 并进行 51200 次生成的 SimpleTES 相比,Dream-RSI 最少仅用 317 次调用,由此得出了最高约 162 倍的调用差距。尽管两者底层模型不同,不具备严格的可比性,但其相对于同模型固定搜索基线的优势依然显著。最终,Dream-RSI 找到的程序在多个测试数据集上超越了 scikit-learn 和 glmnet 的标准实现。
GPU 内核优化:更会分配算力
在 GPU 内核工程任务(KernelBench)中,Dream-RSI 展现了更强的资源分配能力。在 VGG16 和 LayerNorm 任务上,系统分别以少 2.43 倍和 1.79 倍的生成次数达到了与固定策略相近的性能;而在 ConvDiv 和 ConvMax 任务上,同等预算下性能分别提升了 2.09 倍和 1.44 倍。
系统的搜索行为表现出动态适应性:在 ConvDiv 实验中,随着结果改善,系统主动减少每轮评估次数以节省资源;当性能进入平台期后,又自动扩大搜索范围以寻求突破。这表明系统学会了根据历史状态调整探索强度,而非遵循固定规则。
研究还发现,将历史经验总结为自然语言提示词的效果反而不如不加建议的版本。这是因为自然语言总结容易将偶然成功的路线固化为强先验,导致搜索空间过早收缩。Dream-RSI 的优势在于不直接告诉智能体“做什么”,而是让其测试“如何分配搜索资源”,从而改进了寻找答案的方法论。
一边推进 RSI,一边成立研究 AGI 影响的新机构
在发布 Dream-RSI 论文前后,谷歌在组织层面也释放了重要信号。DeepMind CEO Demis Hassabis 宣布成立 DeepMind Institute,旨在关注 AGI 可能带来的社会影响。
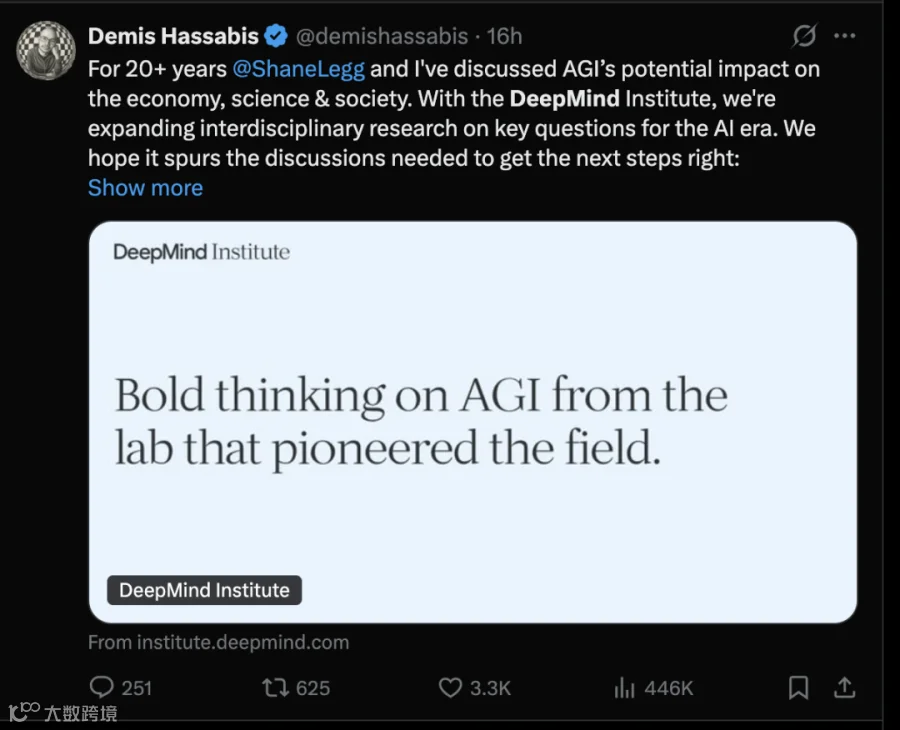
该机构由 Shane Legg 担任执行编辑,将引入经济学、公共政策、哲学等多学科视角,探讨 AGI 的安全部署及其对经济、科研和人类生活的影响。Hassabis 强调,随着前沿技术快速变化,社会需要更广泛的知识讨论以形成共识。
Shane Legg 警告称,AI 能力的进步速度不应超过安全控制的发展速度。递归自我改进已从理论概念逐渐变为现实的治理问题。不过,他同时认为现在宣布 AGI 已经到来为时过早,维持此前判断:到 2028 年出现“最低限度 AGI"的概率约为 50%。

RSI 的竞争,正从模型权重转向整个系统
Dream-RSI 是否算作真正的递归自我改进(RSI)?从结构特征看,它确实形成了“策略修改—经验产生—策略再改进”的持续闭环。但其存在三重边界:未修改底层模型权重、改进局限于特定的元探索策略、且“世界”仅覆盖已探索过的空间。
因此,将其描述为"AI 已可无限自我进化”略显夸大。更准确的定位是:谷歌展示了一种低成本的元层自我改进机制,即在不重新训练大模型的前提下,让智能体根据执行历史持续优化搜索编排方式。
Dream-RSI 的意义在于扩大了"AI 自我改进”的边界。未来衡量 AI 系统的进步,不能仅看模型权重的变化。即使基础模型冻结,一个能够自动修改工作流、调整搜索策略并高效分配资源的智能体,也能在同等 Token 预算下完成更复杂的任务。
从这个角度看,Dream-RSI 创造的是一套会自我管理的研究系统。它或许不会让 Gemini 突然变得更聪明,但能让同一个 Gemini 少走弯路。在需要成千上万次验证的自动科研阶段,减少无效探索本身就是一种重要的能力增长。
参考资料:
https://arxiv.org/html/2609.14858v1
https://www.reddit.com/r/singularity/comments/1whwy4m/google_demonstrated_rsi_loop_for_ai_discovery/
https://x.com/ShaneLegg/status/2100229706641539248
https://www.axios.com/2026/09/16/google-deepmind-institute-agi
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。
