

视频生成模型的画质日益逼真,但其空间感知与方向一致性往往难以匹配真实物理世界。对于具身智能机器人而言,单纯生成缺乏度量关系的二维像素视频,无法支撑真实的路径规划与空间交互。缺乏底层物理约束的世界模型,极易在长距离轨迹下出现地平线漂移、几何畸变与视角失真。
针对这一瓶颈,大晓机器人联合南洋理工大学 S-Lab 等机构提出统一多模态世界模型框架 Puffin-World。该研究从底层重构表征,将外观、几何与物理三态纳入统一体系,打通了物理世界感知、自由视点空间仿真、三维生成与空间重建的完整链路。

图 1|Puffin-World 联合建模外观、几何与物理这三类原生世界状态,并将生成的多视角观测整合为可交互的三维重建结果
该框架在生成新视角时,能同步预测视觉内容、空间深度,并利用重力参照约束相机姿态。目前,团队已公开代码、模型及千万级 Puffin-16M 数据集,并为 28 个公开数据集、约 4450 万张图像补充了相机物理量标注。
从“像素壁纸”走向“原生 3D 世界建模”
对世界模型而言,大范围、持续性的视角变化是检验空间一致性的关键。从正面观察桌子到绕至侧面,桌面的高度与位置需保持合理;相机倾斜或抬升时,地平线与俯仰角也需符合物理规律。这些变化涉及相机运动、场景结构与重力方向的协同。
仅靠连续生成 RGB 图像,往往难以显式表达上述关系。尤其在单张未标定图像、大幅旋转或长轨迹运动下,容易出现单帧合理但连续观察失真的问题。核心难点在于:相对运动描述了视角变化,却无法独立确定初始相机相对于重力的绝对朝向。若初始参照不明确,后续生成便难以稳定保持方向关系。此外,机器人理解环境不仅需要颜色纹理,更需要用于三维重建的几何结构。
为此,Puffin-World 摒弃了“先生成视频再外挂深度模型”的拼接思路,将建模对象扩展为三种相互关联的原生世界状态:
- 外观状态:用 RGB 图像表达场景内容、纹理与视觉细节。
- 几何状态:用深度图描述空间远近,建立多视角观测与三维重建的联系。
- 物理状态:用重力场与纬度图表达观测相对于重力和水平面的方向。
三者共同解决了“看见什么”、“如何分布”以及“以何种姿态观察”的核心问题。

图 2|三种状态共同参与世界理解与生成,为视觉内容建立几何和方向参照。
给生成过程装上“方向仪”
要摆脱“平面画卷”的局限,模型必须同时理清相机在重力坐标系下的绝对朝向,以及画面背后的真实三维距离。团队通过三大核心设计,将机位控制、重力约束与空间深度统筹进同一生成流程。
统一相机语言(Omni-Camera 表征)
团队设计了一套九通道表征作为完整的“拍摄说明”。其中,绝对物理方向包含二维上方向向量与纬度角,将观测机位校准在地球重力与水平面下;相对空间几何则记录射线起点与视向,实现对旋转、平移及视场角(vFoV)的精细控制。
跨视角物理传播机制
模型首先从单张参考图像中解析初始重力方向。当相机发生位移时,通过已知的相对运动关系,将该方向严密投影到目标相机坐标系中,生成对应的重力场与纬度图作为条件先验。这相当于在视角变化过程中保留了一份可追踪的方向参照,即便发生剧烈横滚或大角度俯仰,画面倾斜也能严格遵循重力规律,从根源避免地平线漂移与空间失真。
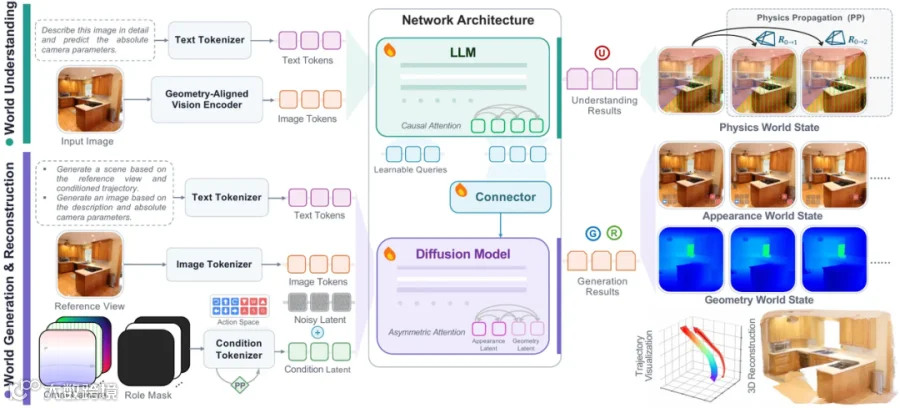
图 3|模型从参考图像感知物理方向,结合相机运动将物理参照传递到目标视角,并同步生成外观与深度
外观与空间深度同步解算
Puffin-World 在同一个生成过程中联合预测目标视角的 RGB 图像与深度。结合相机参数,多视角图像和深度可直接整合为三维场景,省去了生成后调用独立深度模型补估的步骤。这意味着每次视角扩展都能同时获得视觉内容与几何信息,为重建和空间分析提供直接输入。
支撑这一过程的是统一的模型设计:图像与深度共享潜在空间,Omni-Camera 提供相机条件,角色标记区分参考视角、目标视角及不同状态。视觉编码器与语言模型负责理解,其隐藏状态经连接模块处理后,为扩散生成提供条件。
一个框架,打通四类空间任务
这种统一设计赋予了模型四种核心能力:
- 单图物理感知:输入单张图像,模型根据地平线、垂直结构等线索,预测相机横滚角、俯仰角与垂直视场角,并生成场景描述,既分析内容也估计观测姿态。
- 自由视点空间仿真:用户可同时提供文字和显式相机条件,让模型生成指定视角下的观察,相机参数成为直接控制信号。
- 三维世界生成与重建:从图像或文字出发,沿指定轨迹生成新视角,同步输出外观与深度,并将多视角结果整合成三维场景。
- 闭环自校准探索:当当前视角偏离目标朝向时,模型先判断物理状态,再预测纠偏的相机动作并生成调整后的观察,形成“感知—动作—生成”的交替过程。
此外,论文还展示了模仿式世界探索:从共同初始视角出发,按照给定相机轨迹扩展场景。这些能力共享视觉、语言、相机与世界状态表示,切换任务主要通过改变输入条件和视图角色完成。
1600 万核心数据,让模型见过更多“拍法”
空间能力的训练需要丰富的视角变化。现有数据往往偏向水平拍摄和小幅旋转,难以覆盖主动探索中的连续抬头、低头、横滚及完整环视。为此,团队构建了 Puffin-16M 数据集:
- Puffin-Cam-15M:包含约 1500 万组视觉—语言—相机三元组,覆盖多种场景、画幅比例、相机朝向与视场角,帮助模型理解“一张图是怎样拍出来的”。
- Puffin-Traj-1M:提供约 100 万条旋转轨迹,包含连续俯仰、顺逆时针旋转与完整环视,补充大幅旋转和长程视角变化的样本,帮助模型学习“持续转动相机,观察会怎样变化”。

图 4|Puffin-16M 同时覆盖单视图相机条件与连续旋转轨迹。
此外,团队利用模型的物理感知能力,为 28 个公开数据集、约 4450 万张图像补充了横滚角、俯仰角与垂直视场角标注。这些标注为既有视觉数据增加了观测方向信息,可进一步用于机位分布分析、相机条件生成及空间理解研究。
从实验指标,走向可探索环境
论文从相机参数估计、相机可控生成和三维世界建模等方面评估了这一框架。在 Stanford2D3D、MegaDepth、TartanAir 和 LaMAR 四个公开基准上,Puffin-World 在多数相机参数估计指标上取得领先。生成实验同时考察了图像质量、目标相机一致性与多视角一致性,验证了模型让视觉内容服从指定空间条件的能力。
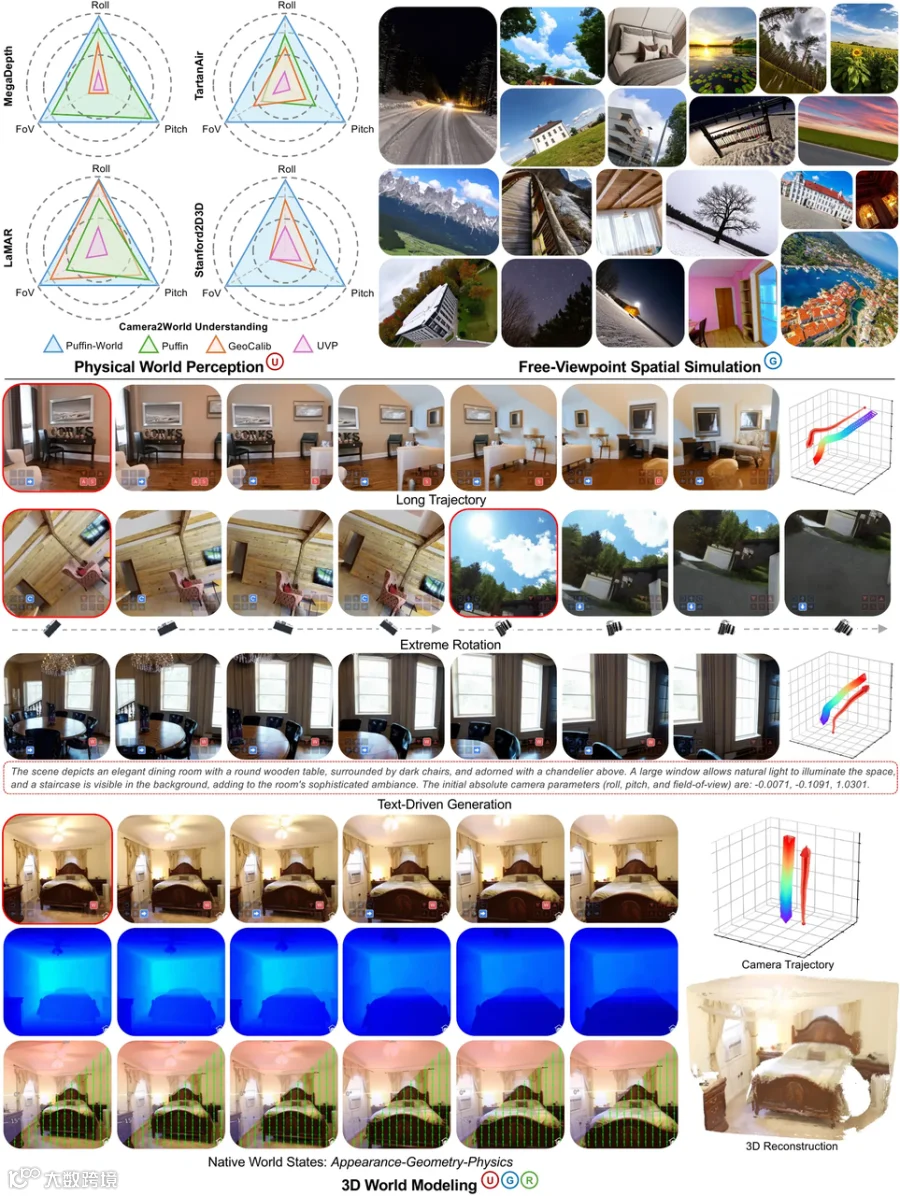
图 5|相机参数估计与生成实验,从方向理解、视角控制和视觉一致性等维度评估模型
目前,Puffin-World 主要面向静态场景,物理状态集中于重力与纬度。单图朝向估计仍有别于完整定位,未观测区域的生成也包含模型补全;闭环示例主要围绕相机动作展开,对真实机器人导航、抓取和复杂接触交互的帮助还需进一步验证。
尽管如此,该研究已实现外观、深度与物理方向共同参与世界建模,并将感知、生成和重建有效连接。这为具身智能提供了一个重要起点:让模型在预测下一眼所见时,同时考虑其背后的空间结构与物理参照。随着模型、数据和标注资源的开放,研究者将进一步检验这种统一表示在智能体环境理解与探索中的潜力。
项目资源
- 论文:Puffin-World — Scaling a Unified Multimodal Model with Native 3D World States(https://arxiv.org/abs/2609.04196)
- Puffin-World 项目主页:https://kangliao929.github.io/projects/puffin-world/
- 代码:https://github.com/KangLiao929/Puffin
- 模型:https://huggingface.co/ACERobotics/Puffin-World
- Puffin-16M 数据集主页:https://kangliao929.github.io/projects/puffin-16m/