


编辑/嘉嘉
近日,全球 AI 视频生成赛道竞争白热化。短短三个月内,四款旗舰模型密集发布:7 月底 Seedance2.5 与 MiniMax H3 同日上阵,8 月阿里 Wan3.0 入局,9 月智象(HiDream.ai)正式发布原生全模态视频生成模型 HiDream-O1-Video-1.0(以下简称 HiDream V1)。
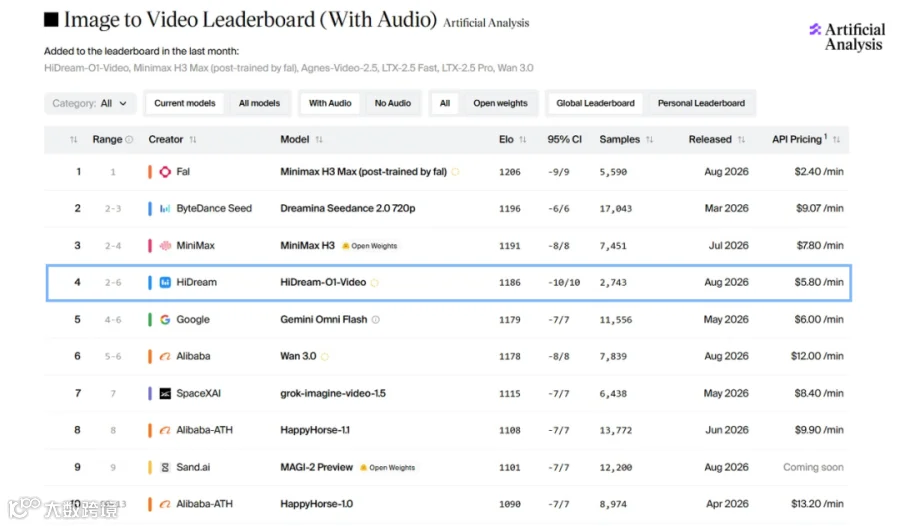
HiDream V1 支持文本、图片、视频等多模态输入,可生成 5 至 20 秒的 1080p 高保真视频。首次参评即表现亮眼:在 Arena.ai 图生视频盲测榜位列全球第八,在 Artificial Analysis 图生视频(含音频)榜单跻身全球前四。
该模型的发布标志着智象完成了“图像模型—交互式世界模型—具身模型—视频模型”的四大闭环矩阵。在大厂林立、单模态产品为主的行业背景下,作为独立厂商的智象凭借统一底座架构,成功跻身全球视频生成第一梯队。
双榜验证:站稳全球视频生成第一阵营
模型性能不仅依赖实验室数据,更需经受权威第三方平台的检验。Arena.ai 通过用户投票反映真实体验偏好,Artificial Analysis 则提供统一维度的专业评估,两者共同构成了对模型能力的交叉验证。
HiDream V1 首战告捷,在 Artificial Analysis 榜单紧随 MiniMax H3、Seedance 等头部模型;在 Arena.ai 盲测中位列全球第八。这表明中国视频生成模型已形成“集团军”优势,字节、MiniMax、阿里与智象四支力量并在国际第一梯队形成集群。

相较于竞品,HiDream V1 的核心亮点主要体现在意图理解与生成质量两个维度:
结构化意图理解:先规划后生成
针对用户指令口语化、碎片化导致的意图漏解问题,HiDream V1 将多模态意图理解模块前置。模型遵循“先理解、再规划、后生成”的路径,将自然语言转化为可执行的专业分镜表达,有效避免镜头跳戏。
原生全模态建模:音画同步与物理真实
为解决“音画不同步”及“叙事不连贯”痛点,HiDream V1 放弃“先生成画面再后期配音”的拼接路线,转而对文本、视频、音频信号进行联合建模。时长决策由内容逻辑决定,而非预设窗口;人物口型、气口与情绪严格同频,物理动作与拟音反馈贴合真实因果。
实测案例显示,在生成 F1 赛车高速驶过的画面时,模型不仅流畅呈现行驶动态与轮胎烟雾,更精准还原了引擎声随距离变化的多普勒效应。在夜晚烧烤摊场景中,脂肪滴落炭火的滋滋声与炸裂声细节丰富,极具质感。而在战争场景模拟中,士兵的躲避动作、呐喊声与环境音效过渡自然,生动刻画了紧张氛围。
世界模型闭环:从单点领先到矩阵协同
HiDream V1 的发布不仅是单一产品的突破,更意味着智象构建了独特的结构性优势。自 2026 年 4 月起,智象相继发布图像生成、交互式世界、具身世界及视频生成四大模型。这些模型均统一构建于 UiT(Unified Transformer)底座之上,分别承担空间理解、时间叙事、三维交互与具身反馈功能,形成了从“理解世界”到“作用于世界”的完整闭环。
当前多数团队仍局限于单一环节,如视频模型侧重动态生成,3D 模型专注空间构建,能力之间存在割裂。智象的差异在于基于统一架构推动四大模型同源演进:图像模型负责空间表征,视频模型建模时间与运动,交互模型连接实时反馈,具身模型转化规划行动。这种矩阵式成长使得各模块能力相互沉淀复利,是单一任务型模型难以比拟的。
独立样本:长期主义的技术兑现
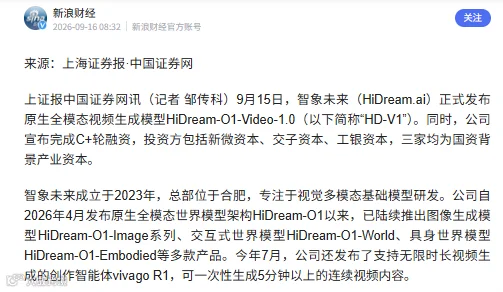
资本市场的连续加注印证了智象技术路线的价值。今年以来,智象在三个月内完成三轮融资,总额超 21 亿元;9 月再获 C+ 轮融资,投资方涵盖新微资本、交子资本、工银资本及社保基金等头部机构。
作为一家独立厂商,智象能与巨头齐头并进,源于其长期坚持的底层架构研发路线。梅涛博士及其团队在 AIGC 领域深耕逾十年,是国内首批完成模型与算法“双备案”的企业。智象未将自己局限为工具公司,而是选择了一条投入重、周期长的原生全模态世界模型之路。
这一路线建立在深厚的视觉生成积累之上。此前,其开源图像模型 HiDream-I1 曾登顶 Artificial Analysis 榜单,编辑模型 HiDream-E1.1 亦进入第一梯队,相关开源模型全球下载量超 200 万次,被誉为图片模型领域的"DeepSeek"。视频模型也非临时转向,团队早在 2024 年便布局 DiT 架构及“扩散自回归”架构探索。
HiDream V1 的问世,既是智象补全原生全模态版图的关键一环,也是其多年技术积累的集中兑现。从图像到视频,再到可交互世界模型与具身智能,智象正证明长期的底层投入能成为下一轮迭代的起点,而非重复建设的成本。