



公司、技术、壁垒,甚至一个人最相信的能力,都在被重新定价。
晚点专栏作者丨五源资本合伙人 孟醒
8 月的一个下午,我从旧金山机场出发沿 101 高速南下。湾区夏日晴空万里,阳光将路面晒得发白。从机场附近的仓库低楼向南行进,风景逐渐被广告牌接管。
这条路的广告牌一直是硅谷最诚实的风向标:两年前挤满 SaaS,去年尚存消费品牌,今年则清一色全是 AI 公司。
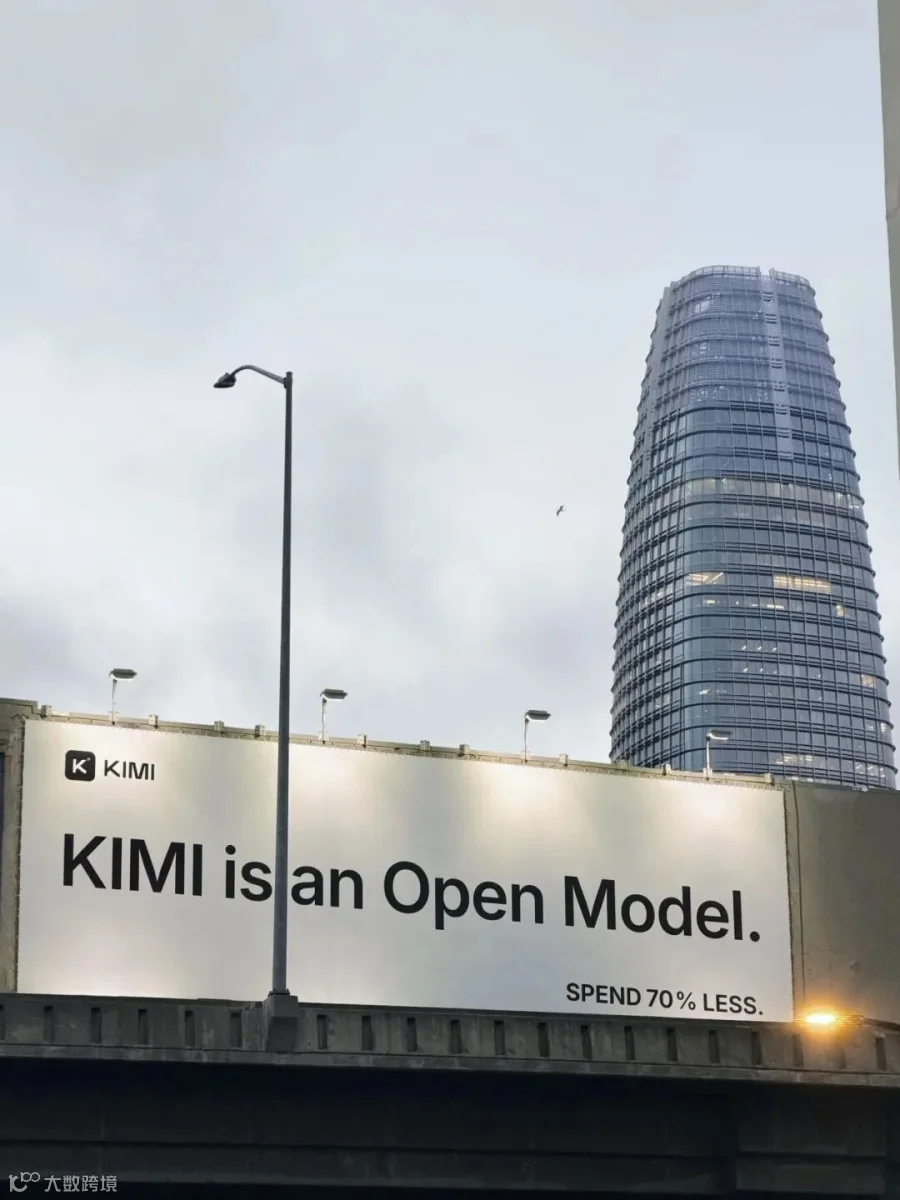

图一:Kimi 加入旧金山"AI 广告牌”大战;图二:Codex 广告牌激增,不惜重金与 Claude Code 竞争(左右滑动查看)
AI 浪潮未见减速,资金、算力与人才仍在涌入。超出预料的是,一些过去罕见的判断开始出现在核心圈层:OpenAI 的朋友复盘押错的方向并拆解中国模型公司的优势;Google 的研究员谈及多模态时直言“打不过国内”。这虽不能概括中美 AI 全貌,但几年前很难想象此类判断出自硅谷一线研究员之口。
人们开始重新评估中美差距,但在预训练、后训练和多模态等不同维度,答案截然不同。
另一种变化发生在过去两年估值最高的 Neo Lab 身上。Thinking Machines Lab 的研究员表示,他们经历的痛苦其他 Neo Lab 迟早会重演。我愈发怀疑,下一家真正跑出来的 Neo Lab 不会长成今天的模样。
此次硅谷之行最强烈的感受是:过去两年形成的边界与共识并不牢固。顶尖研究员聚集能否再造 OpenAI?美国顶级 Lab 是否能在每个战场领先?模型、数据、应用与算力的上下游关系如何界定?最强模型是否应始终维持高价?
就连增长故事也被重新计算:8 月彭博报道 Anthropic 的 ARR 达 650 亿美元,虽两个月内增长 180 亿,但仍低于市场预期的 700 多亿美元。
五个月前业界情绪是“全员 token-maxxing",追求更多 Token、更大模型与更快迭代。五个月后,越来越多人开始反思:过去两年坚信的逻辑,究竟还有多少成立?
“打不过国内”:中美 AI 能力的分化与重构
此次硅谷出差,我反复听到一句以前少见的話:“打不过国内。”说这话的人涵盖 Google 多模态研究员、xAI 及 Frontier Lab 成员,以及研究美国开源模型的专家。这句话在不同场景反复出现,指向具体方向的不同表现。
做多模态的人提到 Seedance,做开源模型的人关注 K3,有人看到数据和运营的优势。与此同时,美国本土的开源模型和 Neo Lab 进展未达预期。在多模态领域,一向坚定投入的 Google 王牌团队也被削减算力,无论是图片编辑 Nano Banana 还是视频模型 Veo,虽属美国第一梯队,但团队纷纷转方向。
过去凭榜单或 Scaling Curve 给中美模型排总名次的方式早已失效。我们需要厘清:哪些地方真正追上,哪些差距依然巨大,以及分化的原因。
Pre-train:方法论趋同,工程经验仍存差距
过去一年,中国模型公司补得最快的一课是如何“爬梯子”(Scaling Ladder)。大参数模型通常先在较小模型上验证数据、架构和训练方法,再逐级 Scale。梯子的完整性决定了小实验误差是否会在大模型上演变成数千万美元的失败。
Frontier Lab 的预训练朋友指出,今年国内头部 Lab 的 Scaling Ladder 已明显完善,训练方法日趋科学。Pre-train 现状呈现反直觉状态:中美在方法论上已非常接近,主要差距在于算力储备及相应的系统工程经验。
最前沿的 Pre-train 仍需巨量算力。美国 Lab 拥有更多超大规模训练经验、更成熟的集群,更清楚数万张 GPU 运行时的潜在问题。中国缺乏的是“将同一套方法稳定 Scale 上去”的工程经验。简言之,路径已知,美国走得更远。
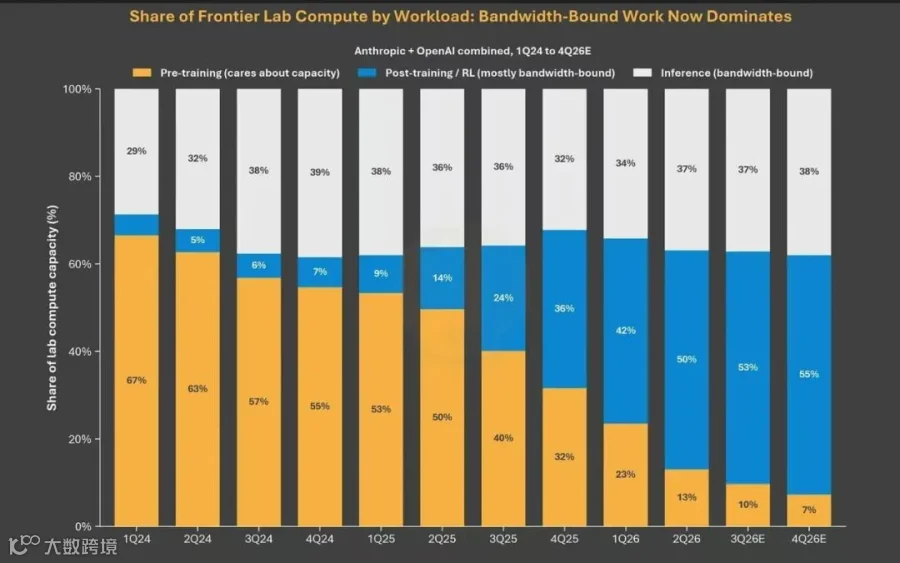
Frontier Lab 算力重心快速转移:Pre-train 占比下降,Post-training/RL 快速上升。竞争焦点从“训出模型”转向“优化模型”与“落地应用”。
Post-train:大规模 RL 是短板,Human Operation 成优势
Post-train 并非统一方法,涉及问题定义、环境设计、Reward 设定及评估稳定运行等。中美差距主要体现在三项能力:大规模 RL、Human Operation(人工运营)及蒸馏。
最难补齐的是大规模 RL。前沿 Post-train 的一次 Big Run 可能占用上万张卡,任务需连续跑上千步,任何环节不稳定都可能导致整条轨迹报废。这需要知道何种 Environment 值得搭建、何种 Reward 有效,以及在规模扩大后原有经验是否适用。这种“肌肉记忆”难以通过论文习得,只能靠大量大规模实验积累。中国因过往算力限制,在此领域的差距比 Pre-train 更深。
但在 Post-train 的另一半,一旦优化目标明确,需要大量人力进行数据标注、评测和反馈迭代,这正是中国公司的强项。以 Seedance 为例,字节拥有最终视频分发平台,能直接定义什么是“好”的视频模型(如运镜偏好、人物一致性等),这些难以通过 Benchmark 提前定义。目标明确后,中国公司能迅速组织大量人力推进数据与训练迭代。
在多模态领域,由于缺乏干净的“对错”标准,大量判断依赖人工,Human Operation 的价值被放大。OpenAI 和 Google 将此概括为运营能力:在训练目标非标准化的领域,中国公司优势显著。
美国公司也在补课。Meta 最近组建了约 6500 人的内部团队 Applied AI,调动大量员工出题、造场景、做评测。
蒸馏与推理泄露:开源模型的逆向利用
蒸馏是 Post-train 的一种手段,可利用已有能力强模型输出作为训练数据。DeepSeek 训练 R1 时,便利用 RL 后模型生成约 60 万条推理数据,配合 V3 的非推理数据重新训练 V3-Base。
随着模型输出可转化为训练数据,推理过程本身凸显价值。今年几家 Frontier Lab 集体关闭完整 CoT 输出,但防线并未完全封闭。5 月研究者发现,即使隐藏完整 CoT,推理信息仍可能通过加密 Reasoning Block 泄露:将强模型的加密推理块输入同一家弱模型,弱模型会以明文输出内容。Anthropic、OpenAI、Google 均受影响。
此外,有美国 Neo Lab 也在蒸馏 K3 等开源模型。原因在于开源模型可直接部署在自有集群,成本低且便于大量生成数据。当 K3 在某些能力足够优秀时,自然进入 Post-train 工具箱。
Coding 领域:高质量 Expert Data 胜过人力堆砌
在 Coding 领域,中国模型未呈现多模态那样的优势。Coding 高度依赖 Post-train,但更侧重大规模 RL。虽然代码运行结果有明确的 Verifiable Reward,但 Credit Assignment(归因分析)极难:在长达上千步的轨迹中,如何将最终成败归因于关键决策步骤是核心难点。
因此,Coding 不仅比拼 Rollout 规模和 RL 稳定性,更考验 Reward 设计及长轨迹归因能力,这是中国模型较难补齐的短板。在此领域,Human Operation 边际价值降低,少数顶尖 Coder 的质量远比大规模标注重要。Anthropic 的高质量 Coding 数据主要来自内部百余名强力 Coder,普通用户数据反而嘈杂。
结论是:若领域目标模糊、依赖人工判断(如多模态),Human Operation 优势放大;若领域有明确 Ground Truth、可自动跑海量 Rollout(如 Coding),大规模 RL 基建与少数高质量 Expert Data 更为关键。
更深层的变化是 AI Research 边界的拓宽:从设计架构、训练模型,扩展到搭建 Infra 乃至组织运营。万卡规模 RL、千步 Rollout 及数据生产组织工作,直接决定模型上限。Researcher 的边界也从“我能想出什么”扩张到“我能组织和管理什么”。中国公司擅长的组织能力在这一轮变得至关重要。
所谓“打不过国内”,并非总排名变化,而是决定模型能力的要素正在移位:某些差距依旧,而过去不显眼的能力突然变得关键。

旧金山 Corgi Cafe:AI 保险创业公司 Corgi 开设的 24 小时咖啡馆,专供深夜工作的创业者与工程师。它是硅谷创业文化的缩影:创新、社交与生活融为一体。
Neo Lab 祛魅:每一代 Lab 都有特定的命运
"Thinking Machines Lab 经历的痛苦,其他 Neo Lab 都会重演。”一位曾与 TML 联合创始人共事的朋友如是说。
过去两年,Neo Lab 是硅谷最昂贵的创业方式:顶尖研究员从大厂出走,VC 追随下注,即便无产品无收入,仅凭豪华团队即可获数亿美元融资。但无论 TML 还是 SSI,结果均低于预期。一位长期关注 Frontier Lab 的投资人感叹:“上一波在美国融到大钱的顶级 Neo Lab,没有一家真正做成。”
Thinking Machines Lab (TML) 是其中最重的一注。成立五个月即融资 20 亿美元,投后估值 120 亿美元,创下史上最大种子轮记录。然而去年底其试图按 500 亿至 600 亿美元估值融资未果,CTO 及核心成员回流 OpenAI。直到最近,TML 才重新开始谈 400 亿美元估值的融资,远低于此前预期。
TML 内部人士透露,公司从一开始就有“拼凑感”。几位联合创始人方向差异巨大:Mira Murati 倾向企业级应用,Lilian Weng 关注交互模型,John Schulman 偏向纯研究。官网宣言是各写一段拼凑而成,最终选择 Human-AI Collaboration 作为愿景,仅是因为这是少数重合点。
一群拥有强烈 Research Taste 的人聚在一起,反而成为问题。在大厂中,组织有既定北极星指标收敛不同意见;而在 Neo Lab,当所有人都有强烈主见且互不相让时,缺乏共同具体目标导致团队分裂。算力资源充足时矛盾尚可不显,一旦需排优先级,冲突即爆发。TML 团队半年内迅速膨胀又经历洗牌,创始人接连离开。
算力也非外界想象般宽裕。尽管签有巨额算力合同,一线研究员仍感觉实验互相挤占,“很多基本实验跑不了”。最痛的教训来自 Tinker 项目:团队过于享受打造优雅框架,忽视了 Prefix Caching、成本优化、部署稳定性等“脏活”,导致毛利受损,市场份额被 Fireworks 等更务实的公司抢占。
TML 暴露了 Neo Lab 1.0 的根本矛盾:一群靠 Taste 出来的人,最缺的恰恰是一个不需要 Taste 的具体目标。
为何这批 Neo Lab 起步猛却慢下来?可将此理解为“跳车”效应:研究员从 OpenAI、Anthropic 等高速大巴跳下时,暂时继承了原车的速度(履历、融资、关注度),但落地后能否自行加速才是难题。他们往往带着“旧地图”:认为聚集最聪明的人并给足算力就能成功,复制了早期 OpenAI 的路径。
然而随着模型发展,行业难题已变。机器人、法律、医疗等场景需回答具体问题:任务是否完成?公司需要清晰的北极星指标指引方向。如今 Frontier Lab 正花费大量精力解决 Environment 搭建、Benchmark 设定、Eval 及 Reward 定义等问题。
每一代 Lab 都有特定命运。下一代真正跑出来的 Neo Lab 可能从完全不同地方长出:先有产品,再有 Environment,最后长出模型。Cursor、Harvey、OpenEvidence 即是例证,它们深入真实工作流,清楚用户需求与失败节点,无需从零讨论解决什么问题。
变化的不仅是 Neo Lab。AI Stack 中各类公司界限日益模糊:Neo Cloud(如 CoreWeave、Nebius)往模型和 Inference 延伸;新型 Neo Lab 往数据公司转型,先做数据服务积累资源再训模型。标签不再适用,大家都在向他人位置移动。未来或许不再有固定的名字,只有不断演进的形态。
除 TML 外,Google 亦经历剧烈人事动荡。Jeff Dean 的离开被视为"Google 的一部分走了”,他在员工心中比 Eric Schmidt 更能代表公司本质。(摄于 8 月 8 日 AASF Event)
全硅谷都在抢数据:数商站到战争中央
美国 Spirit 航空公司虽已停飞,但其遗留数据突然变得值钱。8 月,Google 出价 1000 万美元竞拍该公司几十年积累的内部数据(邮件、消息、代码、财务记录等),Mercor 出价 750 万,Micro1 抬至 1250 万。
买破产公司去年还被视为玩笑,今年已成标准化操作。买方首要任务是“救活”数据:几十年的杂乱记录需老员工解读业务逻辑与协作流程。一家经营失败的公司因“失败得足够真实”而重生价值。
背后原因是互联网公开文本已被 AI 消耗殆尽。全网可抓取文本约 100T,清洗后可用于 Pre-train 的仅剩 15T,即便挖掘隐藏信息也不过 300T。模型公司将目光转向未被整理的真实世界。
“数据”概念也在进化:从静态 Dataset 转向能不断产生新任务、过程与反馈的 Environment。Vending-Bench 2 即为缩影:AI Agent 需经营自动售货机 365 天,面对库存、定价、现金管理等动态挑战。Andon Labs 更进一步,在旧金山签下租约,让 Agent Luna 真实开店,直面租金与市场波动。
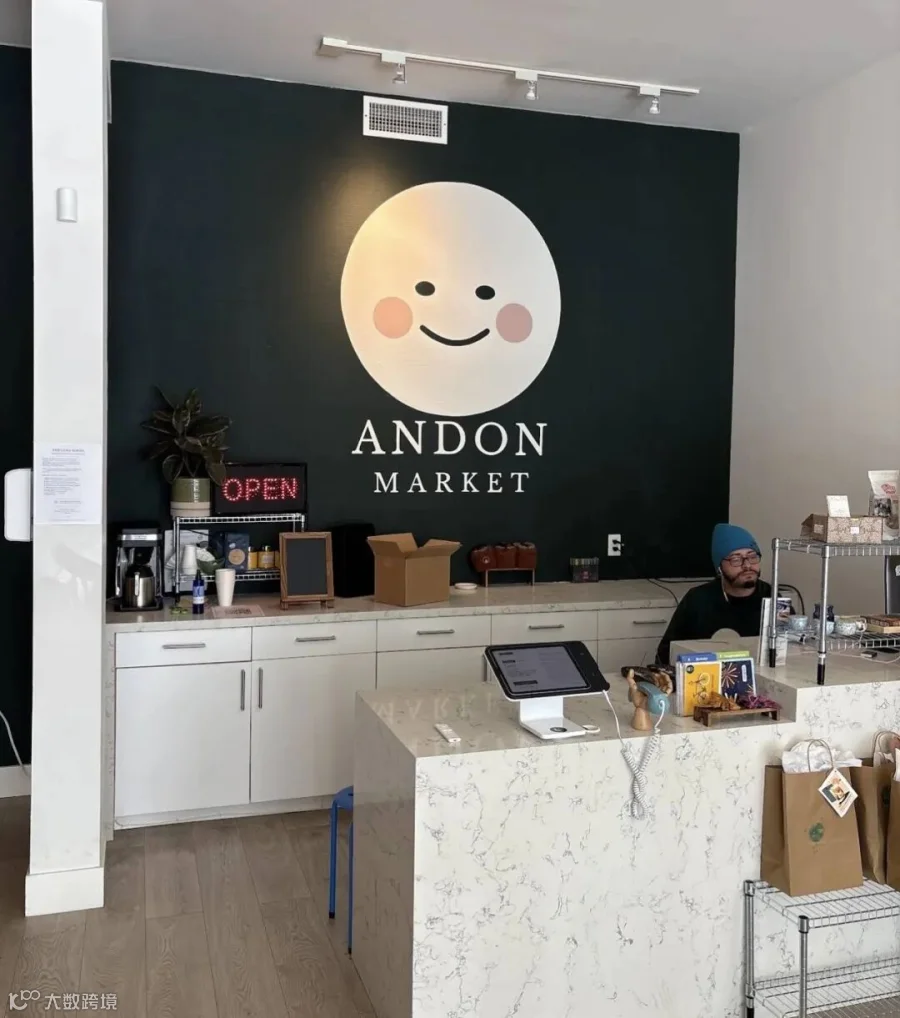
旧金山 Andon Market:Vending-Bench 实验搬进现实。AI 开始直面租金、库存、定价及每日新问题。
此类 Environment 考验 AI 在不完整信息、不可回退的动态世界中持续做对事情的能力。最简单的是售货机,真正值钱的 Environment 存在于“活着”的公司中。破产公司数据仅记录过去,营业公司则持续产生新订单、误判与补救措施。
模型公司获取数据大致有四种方式,成本递增,完整性亦递增:
- Agent 进入工作流(如 Claude Code 记录编码过程);
- 进入沟通场景(如 Agent 入驻 Slack 观察任务推进);
- 派人驻场(FDE 在客户公司部署系统并记录过程);
- 直接收购公司(获取完整 Environment 及持续产生的数据轨迹)。
企业往往对数据记录敏感,促使收购成为终极手段。Scale AI 朋友指出,收购公司可获得整个 Environment,直接跑 RL。卖方不仅有破产公司,不少正常经营企业也愿出售以获取经常性收入。难点在于卖方常不知自身数据价值。
数据公司成为行业 Know-how 交换机,连接需求方与持有方。数商分两派:老一派按人头计价(卖人力产能),新一派按 Environment 和 Trajectory 计价(卖稀缺环境与搭建难度)。两派最终殊途同归:单纯卖人力不够,越接近真实 Environment 越值钱。
核心在于“加工”。数商需将原始数据“退档”拆解为初始任务状态,打包成 RL Environment,并将老师傅的模糊判断翻译成可机器验证的 Rubric。更进阶者需直接跑实验,证明数据能提升基模哪项能力及幅度。
活得好的数商不再被动接单,而是主动赌方向、搭 Benchmark。一旦 Benchmark 被 Frontier Lab 认可,其数据即进入主流。独家数据尤为珍贵,买断数据实则是买断对手赶超的可能性。
数据来源亦成问题。有供应商承认因英语不好先用母语写再由 ChatGPT 翻译,导致数据实为模型生成。这形成“只要别让我知道来源”的默契,数商因此成为模型战争中的“白手套”,隔离来源、合规与交付风险。合法渠道数据报价可达非法渠道的百倍,差价即风险转嫁费。
大厂曾尝试直接从员工身上获取数据(如 Meta 记录鼠标键盘操作),但因员工反对而停摆。这印证了高质量 Human Data 的昂贵与敏感。
数据生意还有更深层次的“加工”:不仅卖数据集,更卖基于数据训练的模型。旧金山 Noetik 公司利用空间生物学数据训练模型,为药企提供虚拟实验与预测能力,而非仅售卖历史数据。加工越深,溢价越高。但此模式难复制,多数 Human Data 仍停留在重脏的加工环节。Lab 虽想掌握数据,却未必愿自建庞大供应链,这使得苦累的数据生意站到了战争中央。
硅谷也是一座“围城”
此行另一深刻变化是:AI 浪潮受益者开始思考人生去向。一位年轻研究员将硅谷比作“缅甸园区”:同质化严重,话题仅限 Agent、Infra 与 Startup。博士毕业一年内换工作已成常态,年薪百万美元以下Offer 已无人问津。
但最早怀疑价格可持续性的也是他们自己。有人像“传教士”坚信 AGI 愿押注多年,有人像“雇佣兵”赚取短期收益。两三年后,AI Researcher 或许不再稀缺。饭桌上话题从模型转向股票、投资与职业规划,不少研究员已出现在湾区基金出资人名单中。
财富自由者探索新生活:卖红酒、跨境贸易、买房甚至建室内滑雪场。有人渴望远离数字世界。两年前硅谷最信的资产是 Researcher 本人,如今连人的能力也在被重新定价:过去独有的能力可能被模型学会,少数人掌握的方法很快成行业基本功。
一位年轻研究员的话令人深思:“没有什么问题是只有我能回答而 ChatGPT 不能的。剩下需要人的,是人与人的沟通,以及在年轻时如何影响和塑造他人。”不少人计划“先赚钱再回学校”,拖延时间长短不一,这背后是对变化的回应。
当公司、技术、壁垒乃至个人能力都可能被重新定价,最终剩下一个无法交给模型的问题:我们到底想把时间花在哪里?
来硅谷前我在法罗群岛休假,那里终年迷雾,只有羊群与零星房屋。本想几日不谈 AI,但打车时因语言不通,仍需靠 ChatGPT 翻译。AI 已成不会消失的背景。模型可无数次 Rollout 试错重来,人却无法重活几种人生再选最优解。时间无法回滚,每个选择只有一次。
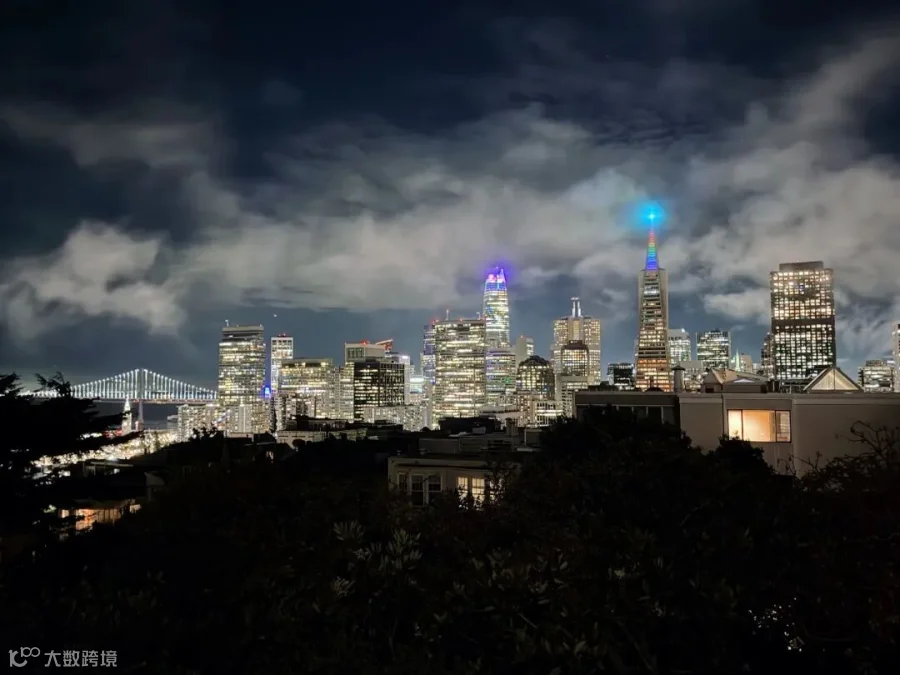
二十年前留学时常登 Telegraph Hill 眺望旧金山灯火,感慨“北漂”心境。二十年后城市天际线未变,但未来五年 AI 必将改变灯光背后的生活与工作。AI 带来的巨变终将落到每个人身上,或许五年后回望,才知今日身处何等转折之中。
晚点专栏作者孟醒:五源资本合伙人、前滴滴自动驾驶 COO。这是他 AI 投资观察系列的第三篇,后续将持续更新。
题图来源:五源资本孟醒
- FIN -