

近期,国内首场 AI 艺人线下演唱会虽惊艳,但互动方式仍局限于屏幕打字。若数字人能像真人般实时点歌、玩游戏,体验将大幅提升。如今,这一愿景已成现实。
当主流视频生成模型仍在比拼时长与清晰度的离线赛道时,生数科技发布的 Vidu S2 已将竞争维度拉升至“边看边改”的实时操控领域。

Vidu S2 核心能力分为两大模块:
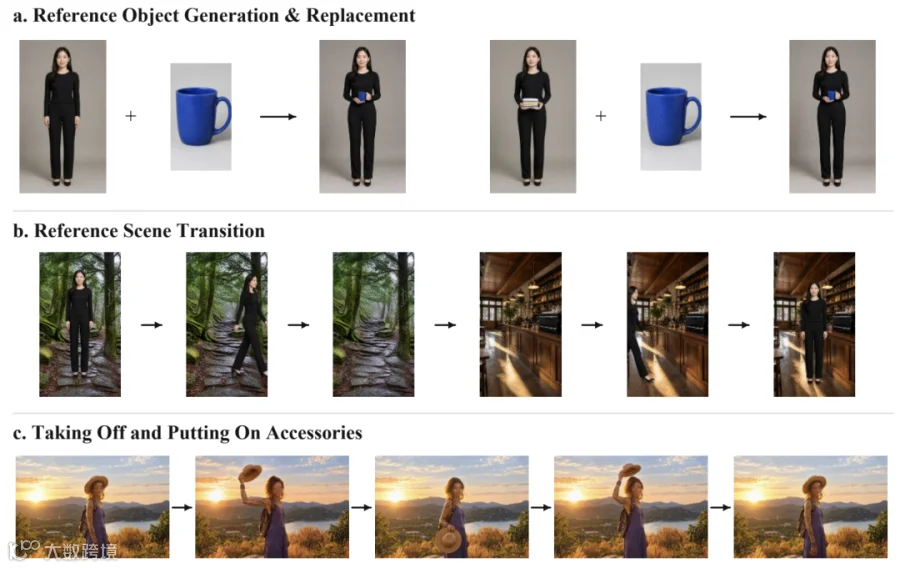
- S2-Avatar(实时交互模型):面向数字人互动,支持 720p 高清输出。增强动作指令遵循与表演能力,支持直播中通过参考图实现持品互动、换装及换背景。
- S2-Editing(实时编辑模型):面向流式视频画面,支持实时修改风格、服装、人物主体与背景,为直播和虚拟演绎提供即时视觉编辑能力。
评测显示,Vidu S2 将实时数字人互动拓展至实时视频编辑,显著丰富了数字人表现力与交互灵活性,赋予进行中的视频画面更大的可编辑空间。
AI 视频实现「边播边改」
高保真数字人交互
Vidu S2-Avatar 大幅提升了对舞蹈、手势及微表情的理解力。用户仅需语音或文本指令,即可驱动摆臂、扭身等高质量动作。通过上传真人、动漫或宠物图片,可快速创建数字分身。
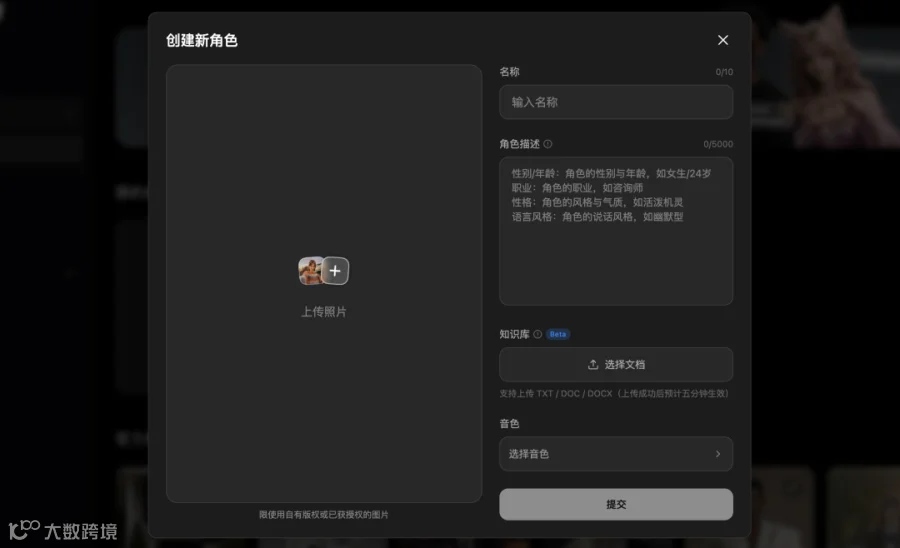
启用音视频权限后,用户可与角色实时对话。在视频流任意时刻,均可插入物品、服装或背景图片,让角色执行拿取、换装或场景切换指令,输出分辨率同步提升至 720p。
针对近期热议的 iPhone 折叠屏概念,测试者利用 Vidu S2 创建了乔布斯数字人。通过输入全身参考图及详细的性格、表达风格描述,模型不仅还原了外貌,更在行为逻辑上高度契合人设。

当被问及"iPhone Duo 是否符合预期”时,数字人乔布斯结合人设回应:“流畅度超出预想,但价格令人犹豫。”此外,模型成功完成了高难度的“乔布斯跳舞”测试,展现了出色的全身动作控制力与人物一致性,证明了其能将固定形象转化为可执行复杂动作的数字角色。
在与其他角色(如学生 Himari、司机 Tom Miller)的互动测试中,模型也能根据指令实时反馈符合身份的回答,展现了强大的情境适应能力。
流式视频的实时编辑魔法
为解决长时流式生成的“崩溃”与“漂移”问题,生数科技独创 SRF(Self-Replay Forcing)训练技术,赋予模型“自我纠错记忆”,直面生成历史并修正误差。
Vidu S2-Editing 的核心升级在于:仅需一张参考图,即可对播放中的视频流实施四种实时编辑——虚拟试穿、换背景、改风格、换角色,实现“拍摄即出片”。
在直播带货场景中,传统数字人难以应对临时展示需求。Vidu S2-Editing 可根据服装参考图实时生成多样穿搭,面料随肢体运动的物理形变逼真自然。运营人员只需上传商品图,主播即可无缝“换装”或“持品讲解”,将单向广播升级为即时响应式导购。
在影视特效方面,该模型支持实时风格渲染与背景替换。无需漫长的后期合成,打开摄像头即可实时呈现不同美学质感,且能精准处理透视对齐与自然遮挡,几乎无拼贴痕迹。
画面持续,指令随行
实时视频生成的本质是交互娱乐。不同于上一代产品,Vidu S2 补全了动态参考图、复杂动作与实时编辑能力,并将输出画质提升至 720p。

实时系统无法预知用户下一句指令,必须在利用已生成画面推进的同时,为新要求预留空间。Vidu S2 采用 Backbone-Refiner 两阶段架构:主干网络以极低延迟负责骨架运动与物理规律推流;精炼网络以异步流水线方式,在毫秒级内完成高清细节重构与光影修复。两者并行作业,兼顾低延迟与高画质。
此外,基于视觉语言模型的 VLM Agent 作为“中控调度脑”,负责解析画面运动相位与空间状态,确保新元素介入符合惯性与光照规律。通过强化学习策略,模型在单向时间流中具备极强的因果逻辑推理能力,大幅降低指令漂移率。
从生成视频到运行实时世界
传统视频中,内容先完成,观众后抵达。实时生成改变了这一关系:画面持续输出,人的意图实时介入。下一代 AI 视频的分水岭,正从“生成结束”走向“世界继续”。
业界分析指出,未来广告或将从“一条视频面对百万观众”演变为“百万条视频,每条只为一人定制”。包括字节在内的多家巨头正布局实时空间视频模型。
Vidu S2 率先将实时生成拓展至空间视频领域。生成或编辑后的画面可转换为同步左右眼视图,兼容头显设备呈现立体深度,让用户在恋爱陪伴、游戏互动等场景中,获得独一无二的沉浸式 Session 体验。
相较于 Adobe MotionStream 的鼠标操控与 HeyGen LiveAvatar 的商业化落地,Vidu S2 的独特价值在于为每个用户实时生成专属的交互内容。在数字革命之前,人类视觉娱乐的本质即是实时在线交互,而 AI 正在让这一本能需求在虚拟世界中重现。