


今天,新一代原生全模态模型 Qwen3.8-Omni-Flash 正式上线。该模型核心目标是提升真实生产力场景中的 Agent 能力,推动全模态模型从“理解内容”向“规划任务、调用工具并完成创作”演进。在具备编程、文本工作及 GUI 操作等通用能力基础上,Qwen3.8-Omni-Flash 进一步拓展了以音视频为核心的 Agentic 应用,在视频剪辑、音乐视频创作、影视解说、音视频转图文摘要及对话等工作流中表现显著。

图 1:Qwen3.8-Omni-Flash 与其在生产环境中的应用
核心特性:支持文本、图像、音频和视频输入,以及 1M 长上下文。
上线平台:千问 AI 平台
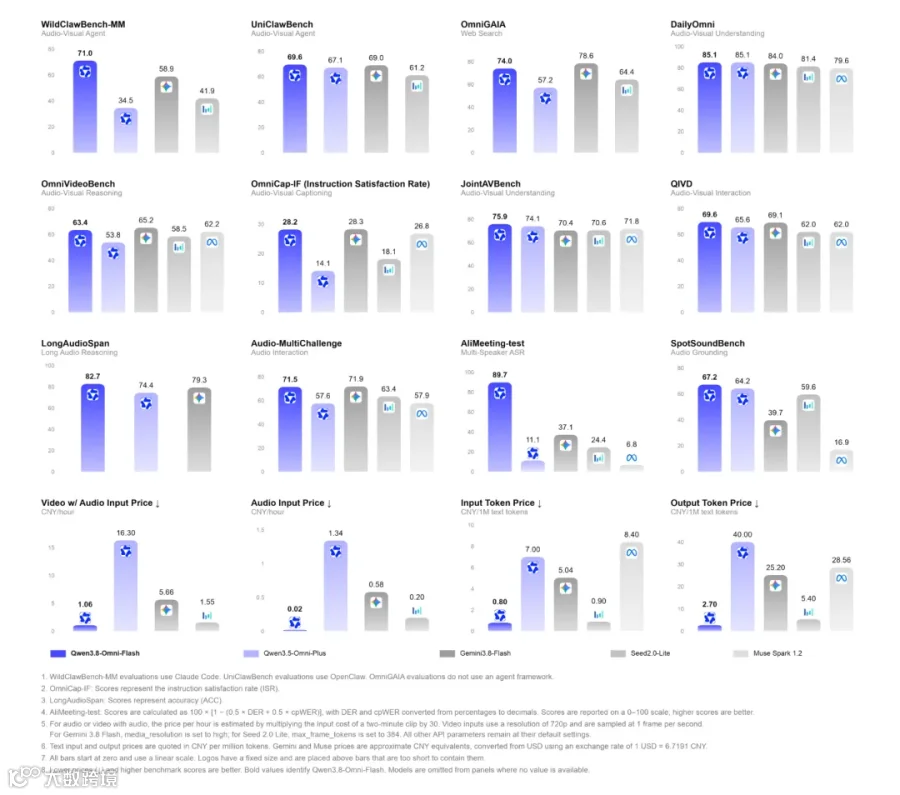
Qwen3.8-Omni-Flash 支持 1M 长序列,在保持与同尺寸文本模型相当的文本能力的同时,全模态能力显著提升。在累计 30 项评测中,相比上一代 Qwen3.5-Omni-Plus,平均得分提升超过 26%。在音视频 Agent、Coding 和长程任务方面,模型在 WildClawBench-MM 上大幅提升 36.5 分,在 AgenticVBench 上提升 22.3 分,并在 UniClawBench 上取得 69.6 的高分。
基础能力方面,模型在长音频/音视频理解、推理、Caption 和多说话人识别上均有明显提升。例如,LongAudioSpan 提升 8.3 分,OmniVideoBench 提升 9.6 分,AliMeeting 的 DER/cpWER 大幅降低。通过扩展数据与上下文,其音视频能力接近 Gemini 3.8 Flash,音频能力整体超越后者。这意味着音视频正从感知输入,成为 Agent 理解环境、推理并执行任务的核心载体。
同时,Qwen3.8-Omni-Flash 的 API 成本大幅优化:每小时音频输入价格降幅超过 98%,每小时音视频输入价格降幅超过 93%。
针对长音视频文件存储、传输成本高及现有框架缺乏原生支持等挑战,Qwen3.8-Omni-Flash 探索了贯穿素材理解、任务规划、工具执行与结果交付的完整链路。为此,团队扩展了 Qwen-MM-Plugins 以支持长音视频按需感知与工作流执行,并开源 Qwen-Live Harness 为实时全模态交互提供原生运行环境。
- Qwen-MM-Plugins: 面向长程工作流
- Qwen-Live Harness: 面向实时交互
长音视频理解
Qwen3.8-Omni-Flash 实现了长音视频理解能力的全新升级:从按需描述、Agentic 主动取证,到理解并推进会议任务,再到生成以视频为中心的深度研究报告,不仅看得更久,更能找得准、理解深、执行快。
可控音视频 Caption
视频描述不应只有一种答案。在 Qwen3.8-Omni-Flash 中,视频描述能力迎来升级:从回答“模型看到了什么”,走向理解“用户想知道什么”。描述对象、时间范围、信息粒度与输出格式均可自由指定;面对同一段视频,既能纵览全貌、定位关键片段,也能深入分析人物动作、镜头、光影与声音,并按需输出结构化结果。
Agentic 长音视频理解
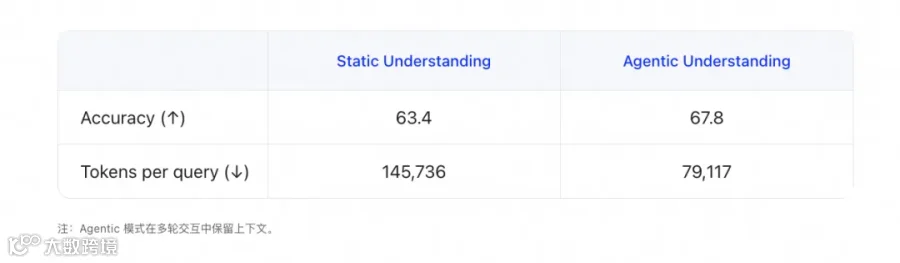
面对数小时的长视频,传统方法通常需处理全部内容。Qwen3.8-Omni-Flash 原生 Agent 则从问题出发,自主决定关注点,通过由粗到细的多轮取证定位关键信息,无需逐帧处理整部视频,即可将计算与 Token 预算集中在相关片段上。
OmniVideoBench 实验表明,Agentic Understanding 将准确率从 63.4 提升至 67.8,同时将 Token 消耗降低约 45.7%。
长会议,从记录到执行
多人会议场景复杂,涉及多人交替发言与声音重叠。Qwen3.8-Omni-Flash 具备多说话人音画协同识别能力,原生支持最长一小时的音视频输入,能够联合理解人物画面与语音内容,端到端完成说话人切分、内容转录与身份对应。输入完整会议视频,模型即可梳理参会者关系、生成会议纪要与待办事项,并分析项目风险。结合 Agent 与工具调用,它还能发送邮件、整理任务,甚至依据会议需求直接开始编码。
通过音视频开展深度研究
当用户带着具体问题观看视频时,所需答案往往不止于视频本身。Qwen3.8-Omni-Flash 能结合用户需求与视频内容,挖掘值得深入研究的问题,检索网页、图片、视频和文档等多模态资料,生成以视频为中心、图文并茂的研究报告。例如,用户在 Photoshop 抠发遇到彩边问题时,模型可拆解教程步骤、研究混合模式原理、对比修复方案,帮助用户判断最适合的方法。
音视频生产与编辑
Qwen3.8-Omni-Flash 正在将音视频 Agent 推向新阶段:从理解声音与画面,到自主规划、调用工具并交付成片,让全模态智能真正进入专业音视频内容生产流程。
Music2MV
以音乐视频(MV)创作为例,Qwen3.8-Omni-Flash 能细粒度精准理解歌曲的结构、节奏、情绪与人声乐器变化,为人物、场景和镜头设计提供灵感。它还能输出带时间戳的句级歌词,让歌声、字幕与画面精准配合。结合 Qwen-MM-Plugins 等工具,模型可贯穿音乐理解、创意规划与成片质检全流程。
短剧翻译
传统视频翻译流程割裂且复杂。借助 Qwen3.8-Omni-Flash 构建的 Agent,用户只需一句话描述需求,即可按需完成区分角色的台词识别、口语化翻译、角色克隆配音、音轨重混与成片质检,将原本割裂的译制环节串联为完整流程,实现短剧视频出海的自动化交付。
长电影解说
面对长影片,电影解说制作通常耗时耗力。基于 Qwen3.8-Omni-Flash 构建的 Agent,用户提供影片并描述需求,即可完成长视频全模态理解、关键情节提炼、解说规划、配音配乐、剪辑渲染与成片质检。Agent 还能智能穿插电影原声对白与解说配音,自动调节语速和音量,打造更具真实感与“电影质感”的解说作品。
从使用模型,到优化模型
真实多模态业务往往复杂且成本敏感,面向具体场景定制小模型是重要路径。然而传统流程周期长且依赖人工。此次尝试将 Qwen3.8-Omni-Flash 推进到模型研发本身,探索“大模型负责研发、小模型面向业务”的新范式。
在一项实验中,Qwen3.8-Omni-Flash 被要求在 12 小时内提升 Qwen2.5-Omni-3B 的四川话识别能力。它自主选定评测集、诊断问题并构建针对性训练数据。在连续 4 轮实验中,Agent 累计构建了 3,413 条训练数据,最终使字符错误率从 25.79% 降至 15.30%,相对下降约 40.7%。这展示了通用多模态模型负责理解数据、规划实验与驱动迭代,小模型沉淀专用能力的可能性。
音视频信息压缩
音视频承载丰富信息,但其线性形态让检索复用困难。Qwen3.8-Omni-Flash 可跨越声音、画面与时间线理解内容,并通过 Agentic 方式完成信息提炼、结构重组与结果校验,将长视频中的核心知识转化为高密度、易消费的信息资产。
Video2Note
围绕视频知识的结构化沉淀,团队在 Qwen-MM-Plugins 中开源了 Video2Note。依托 Qwen3.8-Omni-Flash 对语音、画面与操作过程的联合理解,它能够自动梳理知识结构、拆解关键步骤、筛选代表性画面,并生成图文对应的 PDF 笔记;同时通过自动审阅与迭代修正,将数小时视频内容压缩为清晰文档。
Omni Skill Creator
Omni Skill Creator 作为 Qwen-MM-Plugins 的全新开源能力,可从操作演示中提炼标准作业流程(SOP)并转化为可复用的自动化流程,也可从专家教学中学习工具使用与关键经验。一次演示教学即可转化为经过校验的 Agent Skill,实现基于全模态内容构建可复用技能。
音视频实时交互
面向持续、低延迟的交互场景,推出 Qwen3.8-Omni-Flash-Realtime。它能够在音视频流输入的同时完成感知与响应,并结合实时上下文调用工具、执行任务,让全模态能力从“理解一段内容”走向“参与一场交互”。
实时口语陪练
口语世界没有标准输入。Qwen3.8-Omni-Flash-Realtime 联合建模发音与语义,能够理解受口音影响的非标准表达,将其对齐到正确词汇,并实时生成标准发音示范。在多轮练习中,模型根据新语音持续更新判断,纠正错误同时保留自然节奏与情感。
全模态空间音频感知
在真实空间中,声音是视觉之外的另一条坐标轴。Qwen3.8-Omni-Flash-Realtime 融合空间声音与视觉信息,持续判断声源方向和距离,并同步感知障碍与场景变化,是首个支持“听声辨位”的全模态大模型。面对“过来这里”等指令,模型能从环境噪声中锁定目标声音,调用工具完成定位、搜索与导航。
音视频外部知识接入
实时交互需要随业务动态加载知识与行为。Qwen3.8-Omni-Flash-Realtime 支持通过 Skill 注入身份设定、表达风格、业务知识与交互规则,并通过工具调用延伸能力。在智能客服等场景中,模型可实时加载品牌话术与服务流程,理解用户语音与上下文,生成符合规范的回应并执行操作。
完整性能结果
Omni

Agentic Omni Understanding
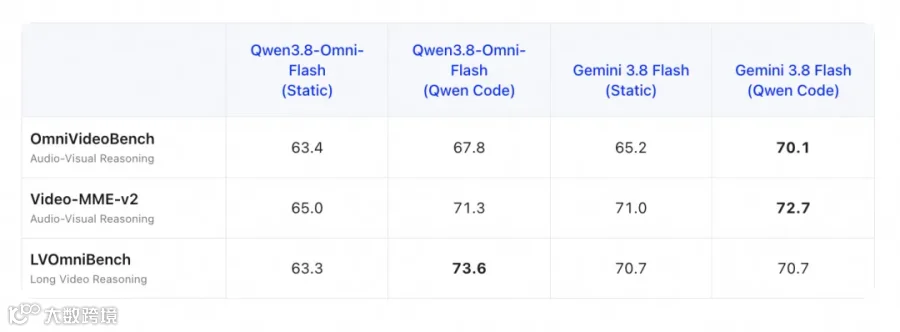
Agentic Omni Understanding 让模型从问题出发,主动规划、调用工具并逐步定位证据,提升长音视频理解的准确性与效率。我们在 OmniVideoBench、Video-MME-v2 和 LVOmniBench 上对比了 Qwen3.8-Omni-Flash 与 Gemini 3.8 Flash 在 Static 模式与 Agent 模式下的表现。
Text

Vision

Throughput & Latency
以下为 Qwen3.8-Omni-Flash-Realtime API 在不同输入场景下的实际吞吐与延迟性能信息。

支持的语种

