

9 月 17 日,智谱发布技术文章,披露了一项由 GLM-5.3 驱动的 Infra Agent 参与搭建和优化 GLM-5.3-Flash 推理系统的工程实战。此次发布并未推出新模型或刷新榜单,而是展示了“模型辅助优化自身基础设施”的技术路径。
十万卡集群:从“能运行”到“跑得稳”
智谱透露,GLM-5.3-Flash 的生产推理服务已部署在超过 10 万张国产 AI 加速器上。从模型在新硬件首次跑通到承载生产流量,全程用时不足两周。经优化,系统端到端吞吐量提升至初始基线的约 3 倍,硬件利用效率与单 Token 成本已达主流英伟达 GPU 水平。
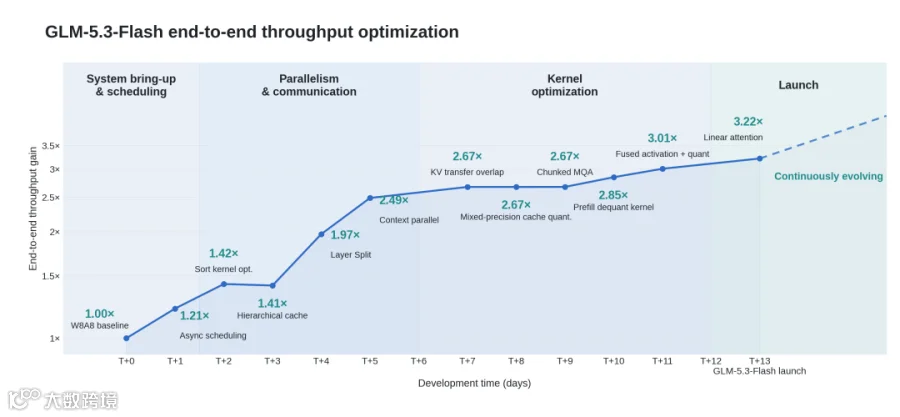
图 1:GLM-5.3-Flash 的端到端吞吐量演变
数据背后是复杂的工程挑战。面对芯片内存带宽受限、部分算子支持不成熟及软件生态不完善等难题,系统还需兼顾长上下文与多模态请求处理。对于大模型而言,“能运行”与“稳定高效”之间,横亘着一整套精密的工程优化工作。
Infra Agent:基于密集反馈的调试助手
在该系统中,GLM-5.3 驱动 Infra Agent 扮演了不知疲倦的调试助手角色。它具备分析日志、定位故障、修改代码及运行测试的全流程能力:针对算子延迟查找根源,对数值精度问题进行复现验证,若局部优化未带来整体增益则自动切换方案。
这并非让 AI 一次性生成完整推理框架,而是通过“密集反馈”机制进行迭代试错。即 AI 每次修改代码后,能迅速获取反馈以确认修正效果及问题所在,从而形成闭环优化。
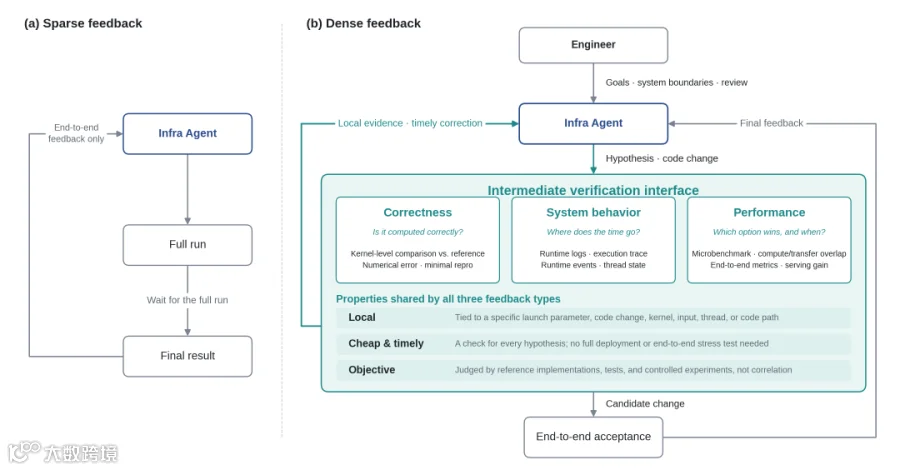
图 2:围绕密集反馈构建的基础设施代理优化循环
此项工作比单纯的“大模型写代码”更为复杂。推理服务涉及算子、通信、显存调度等多维度耦合,单点优化未必带来系统级提速,甚至可能引发新的瓶颈。
理性看待:尚未实现真正的递归自我改进
尽管智谱将此实践纳入递归自我改进(RSI)的讨论范畴,但其原文表述十分克制:目前尚未真正实现 RSI。真正的 RSI 意味着系统能自主设计、训练并改进后继模型。而在本案例中,AI 仅参与推理基础设施的适配与优化,目标设定、上线决策及风险控制仍由工程师主导。
更准确的定义是:AI 开始参与优化承载自身运行的系统,但距离“自主制造下一代 AI"仍有差距。这是 RSI 方向的早期工程实践,而非完整的 AI 自我进化。
竞争新焦点:基础设施与落地效率
大模型竞争的风向正在转变。过去行业聚焦于参数规模、训练数据及跑分;而在生产环境中,推理框架、算子库、通信效率、显存管理及集群调度决定了服务的可用性与成本。
智谱的案例表明,大模型公司的核心竞争力正从“模型智商”延伸至“工程效率”:谁能更快完成部署、在不同硬件上运行更稳、并将 Token 成本压至更低,谁将占据优势。
结语:人机协同的工程新范式
智谱披露的十万卡规模、两周部署周期及三倍吞吐提升等数据,尚需在更多第三方明确条件下复现。但无论数据是否成为行业通用结论,该案例已展示了一条现实路径:人类设定目标与边界,AI 负责海量分析、代码修改与实验验证,双方通过持续反馈共同调优系统。
虽然距离"AI 自主研发下一代模型”尚远,但模型深入基础设施工程现场的时代已经到来。