

(本文阅读时间:5 分钟)
视觉 - 语言 - 动作模型(VLA)已成为机器人操作的重要基石。尽管经过少量微调即可执行抓取、堆叠等任务,但在面对精密接触、狭小容差或分布外位置时,其成功率仍显著下降。
真机强化学习是解决该问题的关键,它能让机器人在真实环境中试错以适应具体场景。然而,真机试错成本高昂,核心痛点在于:如何用尽可能少的真实交互,让策略快速收敛?人类介入纠正是一个自然方案,但对于基于流匹配(flow matching)的 VLA,人类提供的动作与模型优化的初始噪声之间存在表示鸿沟,缺乏可靠的接口。
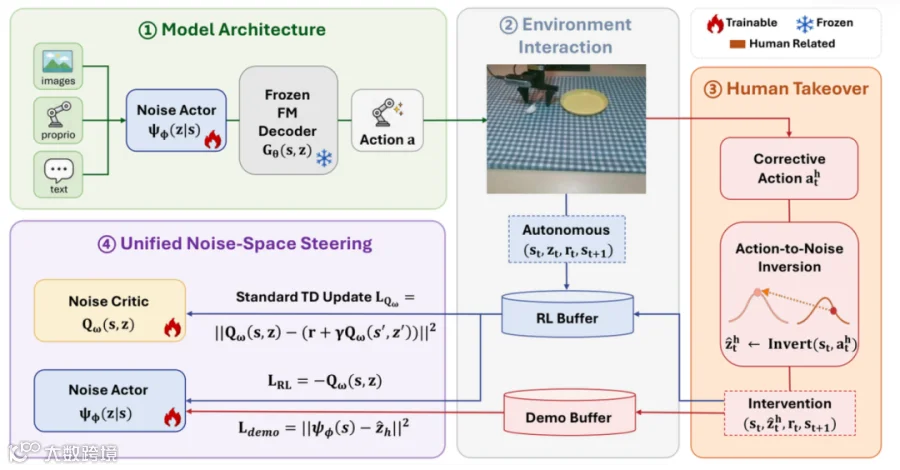
对此,研究团队提出了 UniSteer。该方法通过动作到噪声的近似反演,将人类纠正转化为噪声监督,使监督学习与强化学习能共同更新同一个轻量噪声行为体(noise actor),同时保持预训练 VLA 的动作解码器冻结。
为验证其在高精度任务上的潜力,研究人员挑战了极具难度的“拼豆”任务:机械臂需逐颗夹取细小颗粒并精准放置,最终仅用两条完整人工演示轨迹作为数据预算,便成功拼出了微软 Logo。
在 模型基础上,UniSteer 训练了额外的 noise actor,完成了上述高难度操作。
演示视频:UniSteer 微调后的 VLA 完成拼豆任务
噪声空间微调:轻量但探索昂贵
当前许多 VLA 采用流匹配生成连续动作:先采样高斯噪声,再经多步去噪转换为机器人动作。若直接对整体 VLA 进行在线强化学习,计算代价高且训练不稳定。噪声空间强化学习提供了一条轻量路径:冻结预训练 VLA,仅训练小型 noise actor 选择初始噪声,再由冻结的 VLA 解码为动作。
执行过程如下:

其中, 为可训练的 noise actor,
 为冻结的 VLA 动作解码器。该设计优势明显:仅更新小型 actor 大幅降低训练成本,且动作仍由预训练 VLA 解码,确保不偏离原有动作先验。
然而,轻量不代表高效。若初始策略成功率低且奖励稀疏,noise actor 难以通过自主试错找到成功轨迹。此时人类纠正本应发挥作用,但人类记录的是动作 ,而 noise actor 需学习的是噪声
 。关键技术问题在于:能否找到一个噪声,使冻结的 VLA 恰好生成接近人类纠正的动作?
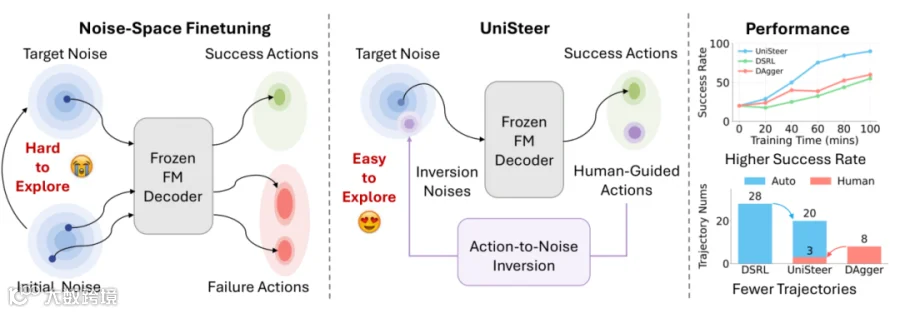
动作无法直接监督?UniSteer 选择反演生成过程
UniSteer 的核心思路是沿冻结 VLA 定义的映射路径反向寻找产生人类动作的初始噪声。对于固定状态 ,流匹配解码器从初始噪声
 出发,沿速度场
 演化得到动作
 :
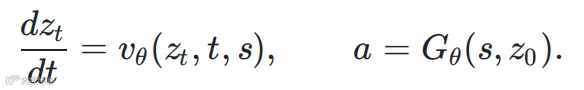
理论上该映射是双射,但实际模型采用离散 Euler 步解码,单步逆映射依赖未知输入。定义一次前向更新为:
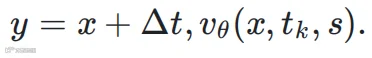
要从输出 恢复输入
 ,需求解:

由于右侧包含未知的 ,这构成了一个不动点方程。UniSteer 从
 开始反复迭代:

当速度场满足特定 Lipschitz 条件时,该映射为压缩映射,迭代会收敛到唯一不动点。由此,UniSteer 可从人类动作逆向推导每一个 Euler 去噪步骤,最终恢复对应的初始噪声 。
统一噪声接口:融合人类纠正与强化学习
获得目标噪声后,人类指导可直接用于 noise actor 训练。系统记录自主执行时的状态、噪声、奖励及下一状态至强化学习缓冲区。当人类接管时,UniSteer 将纠正动作 反演为目标噪声
 。该数据一方面进入演示缓冲区,通过均方误差直接监督 actor:

另一方面进入强化学习缓冲区,辅助 critic 学习高价值状态 - 噪声组合。随后,actor 依据 critic 的价值信号继续优化:

至此,人类纠正与强化学习通过同一噪声接口更新同一个 actor。监督学习引导 actor 进入有希望的区域,强化学习则在该区域附近利用任务奖励进一步探索巩固。
实验成果:66 分钟内成功率从 20% 跃升至 90%
研究团队在 AgileX Piper 机械臂上测试了拿起勺子、堆叠积木、插入方块和折叠毛巾四项真机任务。系统接收双路 RGB 图像、6D 末端位姿及夹爪状态。每项任务先使用 30 条示范预热,再进入在线真机微调。

 表 1:真机实验结果
相比 DAgger,UniSteer 人力投入更少。实验中 DAgger 每轮收集 8 条纯人工轨迹,而 UniSteer 在更少人工轨迹下效果更佳。此外,UniSteer 使用的纯模型轨迹少于 DSRL 基线,证明其提升源于更有效的探索而非数据堆砌。
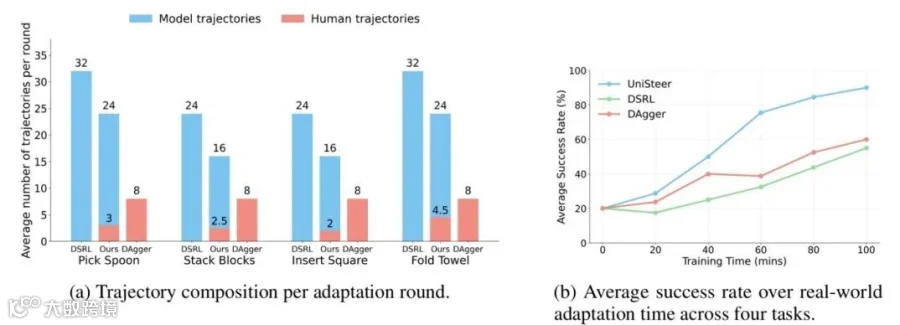
该结果不仅意味着更高的最终成功率,更代表更快的提升速度。DSRL 依赖自主探索,初始策略弱则难获成功轨迹;DAgger 虽能快速利用人工动作,但可能覆盖已有行为。UniSteer 则先借少量纠正锁定有希望的噪声区域,再通过奖励驱动优化保留并扩展能力。
固定点反演的价值:速度与精度的平衡
研究团队还比较了两种替代方案:一是将噪声作为优化变量通过梯度搜索重建;二是不显式恢复噪声,直接从动作重建误差反向传播。实验显示,固定点反演在速度、精度和成功率间取得了最佳平衡。
在拿勺子任务中,固定点反演耗时 73.26 秒且 8/8 成功;基于优化的反演耗时 208.04 秒仅 3/8 成功。插方块任务中,两者分别为 40.42 秒(8/8 成功)和 80.96 秒(4/8 成功)。直接动作监督虽成功率尚可,但训练耗时显著更高。
固定点反演的核心价值在于以较低成本找到与冻结 VLA 一致的噪声监督目标,既避免了反复优化单个噪声,也无需每次更新都穿过完整动作生成过程。
结语
VLA 为机器人提供了强大的动作先验,但从“会做”到“做好”仍需真实环境的适应。UniSteer 通过将人类动作反演为初始噪声,实现了监督学习与强化学习在轻量 noise actor 上的汇合。人类纠正指明探索方向,强化学习基于奖励优化,冻结 VLA 提供先验保障。
从 66 分钟内将成功率由 20% 提至 90%,到仅用两条演示完成拼豆任务,UniSteer 展示了一条现实可行的路线:不必全量更新庞大 VLA,也不必盲目试错,而是让人类纠正在关键时刻成为噪声空间中可学习的方向。随着 VLA 进入更复杂任务,如何将有限的人类参与转化为高效策略改进至关重要,UniSteer 为此提供了一个简洁统一的接口。
UniSteer: Unified Noise Steering for Efficient Human-Guided VLA Adaptation
论文链接:
https://arxiv.org/abs/2605.10821
代码链接:
https://github.com/microsoft/UniSteer
#AI #人工智能 #Agent #智能体 #Unisteer #VLA #具身智能