
这两天被 Jev 刷屏了。简单说,它是一个非常擅长做选择题的大模型,不替代以前的模型,面向程序而非人类,为的是把 AI 自动化真正跑起来。
发布它的公司叫 TypeSafe AI,创始人 Diogo Almeida 在 OpenAI 时参与做过让语言模型听指令、和人对话的方法,后来成了 ChatGPT 背后的研究。他在推文里的自我介绍是"co-inventing ChatGPT"。隐身两年,9 月 15 日发了博客《Introducing System One Models & Jev》,推文两天 3100 万次浏览。
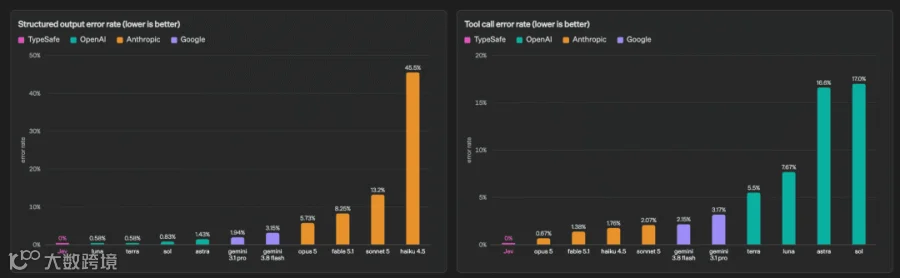
官方博客的三张证据图之一:结构化输出错误率和工具调用错误率,Jev 那一栏是 0%,因为按定义不可能出类型错误(图源:TypeSafe 博客)
01Jev 想解决的问题
现在的大模型(OpenAI、Claude、DeepSeek 等)输出的都是"一段话"。人看没问题,程序没法直接用。你让它判断"这个客户会不会流失",它可能回你一篇小作文,可能格式不对,可能瞎编,而且永远一副很自信的样子。
博客里那张对照表把这件事说透了。RLHF 优化的是人类偏好,RLVR 优化的是可验证的奖励,TypeSafe 提出的 RLCD(Reinforcement Learning for Calibrated Decisions)优化的是"带诚实概率的校准决策"。LLM 的输出是字符串,什么都能装:聊天、代码、幻觉、拒答,程序要用得先解析再校验,还总有跑偏的风险。Jev 的输出是类型安全的结构化值,可能的输出和结构事先定义好,模型不可能出类型错误。
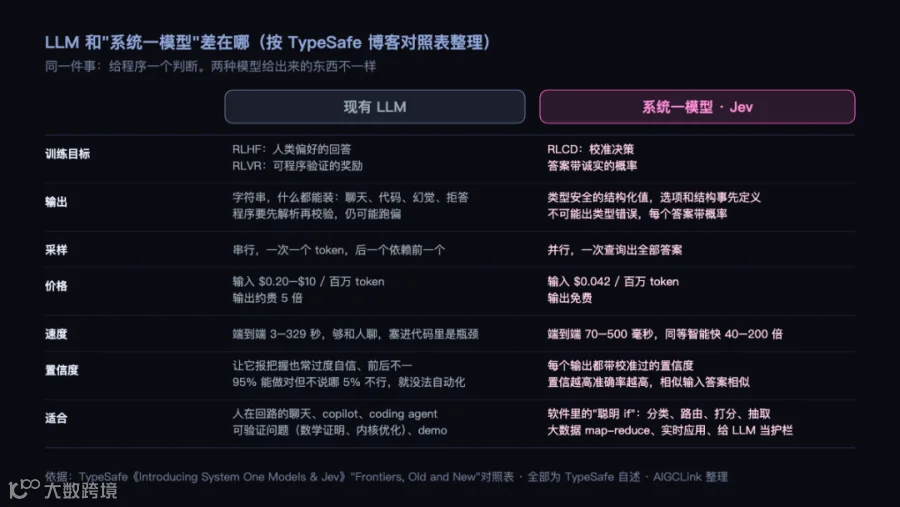
LLM 和系统一模型的对照,按博客里的表整理
02Jev 的做法:干脆不让它说话,直接做选择题
你给它一堆信息(博客叫"程序状态"),再给它一张"选择题答卷":
1. 这封邮件是投诉吗?是 / 否2. 紧急程度?高 / 中 / 低3. 该转给哪个部门?A / B / C
它只能在选项里选,所以不可能答非所问、不可能编造格式。每个答案都附带"我有 92% 把握"这样的数字,把握低的交给人处理,把握高的直接自动执行。博客的说法是校准过的:置信度越高,准确率越高;相似输入给相似答案。
因为不用一个字一个字往外蹦,它一次性并行给出所有答案:
- ▪速度
:端到端 70 到 500 毫秒。前沿 LLM 是 3 到 329 秒。同等智能水平下快 40 到 200 倍 - ▪价格
:输入 $0.042 / 百万 token,也就是 10 亿 token 42 美元;输出免费,官方原话"便宜到不值得计费"。LLM 的输入是 $0.20 到 $10 / 百万,输出还要贵 5 倍左右
选项上限是 255 个。选项更多的场景,它分两段,先各自打分再显式选一次。

创始人发布视频里的并排演示:左边 TypeSafe 0.114 秒、$0.000081 出完 27 个问题的答案和置信度,右边 GPT-5.6 Terra 还在等第一个 token(图源:@CompleteSkeptic 推文视频截帧)
03数字怎么来的
博客写了一句"非同寻常的主张需要非同寻常的证据",然后把证据和每一条的 nuance 都列了。这部分值得看。
工作流评测。 他们不拿固定的分类标签当真值,假定有一个正确的计算图(用代码写的工作流),拿最大、最贵的模型(GPT-6 Astra 和 Fable 5.1 的平均)的预测当参考概率。每个模型跑同一个工作流。

博客给的最简单一个工作流:安全告警的分诊、处置、遏制、剧本四步,每步都是布尔、打分、选择三类问题(图源:TypeSafe 博客)
结果是这张帕累托图:Jev 在准确率和成本的边界上独占了将近两个数量级。
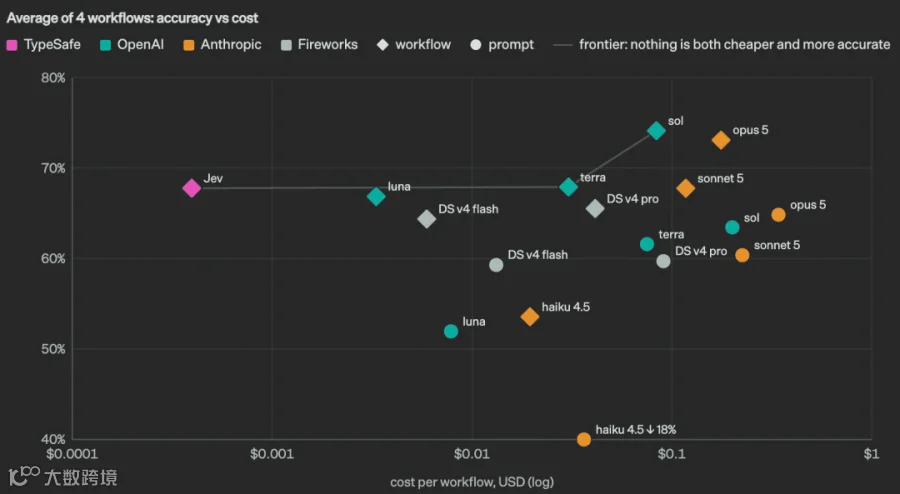
四个工作流的平均:准确率 vs 每次工作流成本(对数)。Jev 约 68% 准确率、每次约三万分之一美元;GPT-5.6 Sol 约 74%、每次约八分之一美元(图源:TypeSafe 博客)
官网首页"快 193.6 倍、便宜 444.6 倍"就是从这里来的,作者自己说这是真实收益的偏高一端。图上也能看到,Jev 的准确率约 68%,比 Sol 的 74% 低,它赢的是同等准确率下的成本,而非绝对准确率。
作者列的偏差:参考答案取 OpenAI 和 Anthropic 模型的平均,天然偏向这两家,可能低估了 Jev 和 DeepSeek 的相对表现;工作流由自家能力团队写,不在训练分布里,但可能有偏;LLM 那边用的是他们自己的 System One 封装,强制 LLM 输出兼容格式的结构化决策,这比直接要答案更慢更贵。
幻觉和类型安全。 LLM 的错误率数字来自 OpenRouter,复杂请求可能被路由到更好的模型,有偏。Jev 的 0% 没有测,schema 匹配有保证,所以直接填 0。
04它不能干什么
写文章、写代码、聊天、复杂推理,统统不行。它不是来取代 ChatGPT 的。博客里"不可能幻觉"这句要读准:指的是不可能输出预定义之外的东西、不可能出类型错误,选错选项仍然可能,所以才要带概率。
05它能干什么
那些量巨大、要求快、不能出错的"小判断":审核内容、分拣工单、风控打分、从海量数据里筛东西,以及给别的 AI 当"监考老师",检查它们有没有胡说。博客的分类是四种:塞进普通软件的"聪明 if 语句"(分类、路由、打分、抽取、分支),对大数据做 map-reduce,100 毫秒级的实时应用,以及给 LLM 的提示、推理轨迹和输出做打分、判断、护栏和越狱检测。
两个官方 demo 说明了实时性。一个是打 Doom,每秒 10 次查询,一小时约 7 美元。一个是 Wikiracing,从一个维基页面只靠链接跳到指定页面,每步在几百到几千个链接里选,Jev 步数更少,这个 demo 里对手关了推理模式,作者说开了推理 LLM 会好看很多,加速倍数也会小很多。
06对行业的影响
- ▪
以后 AI 会分工:大模型负责"慢慢想、好好写",Jev 这类负责"秒级拍板" - ▪
现在大量公司拿大模型干分类、审核的活,又贵又慢,这块生意要被 Jev 接管了 - ▪
便宜到几乎不要钱之后,以前"不值得用 AI"的地方都会用上,需求反而会爆发
第三条正是它名字的来历。Jev 取自 William Stanley Jevons,蒸汽机效率提高后煤的需求反而上升,TypeSafe 赌智能也是这条路:每便宜一个数量级,就解锁多几个数量级的用法。"系统一模型"这个类名来自卡尼曼的《思考,快与慢》,快的直觉系统一,慢的推理系统二。
目前是早期访问,排队放人,有 Python 适配器开源在 GitHub。
LLM 把智能做成了对话,Jev 把智能做成了函数调用:非结构化状态进,带概率的类型化决策出。
项目地址官方博客:https://typesafe.ai/blog/introducing-system-one-models-and-jev官网:https://typesafe.ai/文档:https://docs.typesafe.ai/工作流评测:https://evals.typesafe.ai/Python 适配器:https://github.com/typesafe-ai/system-one-adapter-python创始人推文:https://x.com/CompleteSkeptic/status/2099925682726002904