


导读9 月 16 日,豆包 2.1 Pro 更新 0915 版,四个升级方向里有两个直接写着“Agent 任务交付”和“长程开发”。“长程”这个学术词,正在变成产品主战场的关键词。这篇不做新闻转述,而是借人大、北大、清华等机构的 149 页长程 Agent 综述当主线,串起近一个月的四篇代表性论文(PILOT、TokenPilot、T1、LongDS)和一套工程方法论:长程任务为什么会系统性退化,外化的运行时工程和内化的模型训练各自解决哪一环,以及什么任务才真的适合交给长程 Agent。
本文 3326 字,阅读约 8 分钟|长程的定义 → 错误为何滚雪球 → 时间视界趋势 → 外化三件套 → 内化训练 → 评测标尺 → 什么任务值得托付
三五轮很稳,三十轮就废
让 Agent 改一个文件、回答三五轮问题,现在的模型基本很稳。但一旦任务拉长——连续改五个文件还要保持兼容、几十轮工具调用后记得最初的边界条件、分析中改了三次口径后还能接着算——系统就开始明显退化。这不是“多试几次”能绕过的噪声,而是随轮次增加单调恶化的趋势。
浙江大学、蚂蚁集团联合实验室的 LongDS-Bench 给了量化版本:多轮长程数据分析任务里,按进度从最初 10% 到最后 10% 对齐,整体正确率下降约 46.8 个百分点。同一个模型、同一项任务,开头做对和结尾做对,难度差出近一倍。
 图片说明:LongDS 原版实验显示正确率随任务推进持续下滑;每一轮平均直接依赖约 2.85 个历史轮次,最远依赖平均追溯约 11.3 轮。图片来源:LongDS-Bench 论文
9 月 16 日火山引擎发布豆包 2.1 Pro 0915 版,四个升级方向里 Agent 任务交付排第一,多模态 Coding 强调“跨文件、长程开发任务,从理解结构到运行验证完成交付”。头部厂商把“长程”写进版本说明,意味着问题已从论文讨论进入产品交付的核心指标。但要谈解法,得先把这个词说准。
长程看的是依赖链,不是跑了多久
人大 Guanting Dong 等的综述《Towards Long-Horizon Agents: A Survey》(149 页,OpenReview 公开稿,RUC-NLPIR 维护配套仓库)给长程 Agent 下了第一个统一的形式化定义:
Agent = π_θ ⊕ H
即基座策略(模型权重里的能力策略 π_θ)与运行时 Harness(循环、记忆、工具、编排、钩子、验证等外挂支架 H)耦合的系统,后者决定模型何时被调用、动作如何被校验、什么状态跨步骤留存。长程能力从来不是基座模型的单独属性。
判断一个任务是不是长程任务(Long-Horizon Task,也译长时程任务),判据不是运行时长,而是内部逻辑依赖:目标可能一开始就欠规范、要边做边澄清,子任务深度耦合,必须把一连串相互依赖的决策串成连贯轨迹。跑一整夜的独立批处理不是长程,只是长时运行;十分钟内改五个文件且要保持兼容,反而是长程任务。
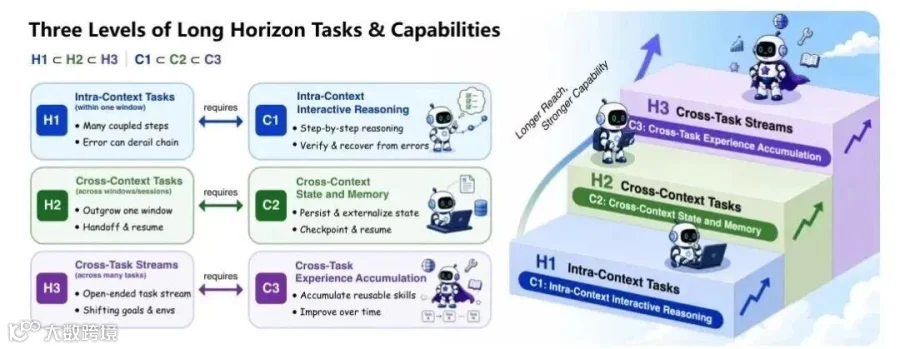 图片说明:H1 上下文内(约分钟级)要求交互式推理 C1;H2 跨上下文(约小时到天)要求跨窗口的状态与记忆 C2;H3 跨任务流要求经验沉淀 C3,三级嵌套。图片来源:Towards Long-Horizon Agents 综述
综述按“执行要跨出单个上下文多远”分三级:H1 上下文内,一个窗口完成但决策链高度耦合;H2 跨上下文,要跨窗口或多 Agent 接力,依赖历史外化、读写记忆和断点续跑;H3 跨任务流,要求把经验沉淀成可复用技能。三级嵌套,每升一级叠加新的失效模式。再澄清两个混淆:自主 Agent 说的是“要不要人批准”的治理属性,与长程这个能力属性正交;自进化只是服务 H3 的一种机制,不是长程的同义词。
错误为什么会滚雪球
LongDS 对 3207 个错误轮次归因后发现,上下文记忆、状态管理和级联三类长程错误合计占 52% 到 69%,其中级联错误占比最大:当前轮计算完全正确,错的是更早生成、又被沿用的中间状态——代码运行成功,用的却是错误版本的数据,不报错,但后面每一步都在错误的地基上盖楼。论文还有个反直觉发现:交互步数更多并不总意味着更高正确率,沿着错误状态多推理,只是把错误算得更细。
这也是“把上下文窗口做大”不构成完整答案的原因:窗口扩大只抬高 H1 的天花板,任务状态依然只活在会被压缩、冲淡和淘汰的隐式记忆里,H2、H3 需要的跨窗口存活和经验积累它不提供。
工程圈流传的 Plan Pane 方法论把这个问题说得很直白:任务状态不能全寄托在不断膨胀的单一上下文里。它的药方朴素到像常识——规划和执行硬分离,先产出结构化步骤清单当“合同”,执行阶段只管“如何完成当前步骤”;用独立维护的计划面板实时标记 [ ] → [x],每步对应一个独立的 ReAct 轮次;三层上下文各司其职:System 规则层永不压缩、Plan 状态层工具维护、对话细节层用完即弃。背后是个很硬的立场:即便模型规划能力大幅提升,分解仍有必要——检查点带来的可验证、可回滚,是能力提升替代不了的架构收益。
时间视界在翻倍,但“能做”不等于“靠谱”
综述引用 METR 截至 2026 年 5 月 8 日的实测:前沿 Agent 的 50% 任务完成时间视界,从 GPT-2 时代的秒级涨到 Claude Opus 4.6 的约 12 小时;翻倍时间约 196.5 天,只看 2023 年后的新方法论序列则缩短到 130.8 天(约 4.3 个月)——翻倍还在加速。
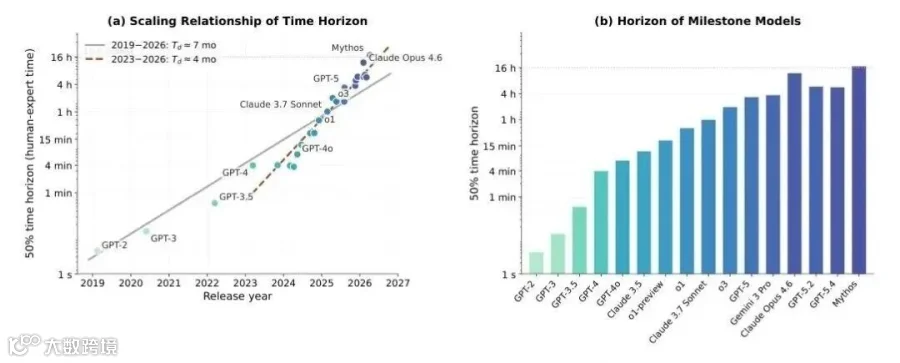 图片说明:METR 实测的前沿 Agent 50% 成功时间视界增长曲线,纵轴为对数尺度的任务时长。图片来源:Towards Long-Horizon Agents 综述(原图引自 METR)
但 50% 这个口径容易被忽略:同一批测量里,80% 成功率的时间视界只有约 70 分钟,相差 5 到 10 倍。这恰好量化了生产常识:每步 95% 可靠,连做二十步只剩约 36%。时间视界衡量的是能力边界,不是生产可靠性;后者只能靠分解、验证和运行时设计一节一节挣回来。
外化 Harness 的三件套
把综述的六组件落到近一个月的新工作上,能看到三条最活跃的进攻路线。
第一条,让监督独立且实时。PILOT(arXiv:2608.26530,8 月 25 日)指出,Reflexion 这类事后反思有两个根本缺陷:第 47 步发现的问题,总结出来时本次运行已经结束;提炼的知识也没法当场验证。而单 Agent 自我修正,是执行者和诊断者争抢同一个上下文,像要求外科医生在手术中同时当审计员。PILOT 冻结模型参数,改用 supervisor-worker 架构:worker 在隔离上下文里执行,死胡同和冗长工具输出留在本地;supervisor 通过双向通道实时“转向”或“中止”,并把运行中发现的成功做法和失败模式即时蒸馏进技能库,后续 worker(哪怕在同一次运行里)直接加载。
 图片说明:PILOT 架构对比:单循环无独立监督、子 Agent 只能事后汇报,以及 supervisor 实时转向活跃 worker 并沉淀技能记忆。图片来源:PILOT in the Loop 论文
论文自报:Terminal-Bench 2.0 上最多领先 9.8 个百分点,自我改进设置下最佳通过率提升 14.6 和 12.4,平均输出 token 反而下降约 43% 和 47%。注意这是论文自报口径,且用同一个冻结模型兼演两个角色,隔离的是编排本身的效果。
第二条,给上下文算经济账。长程成本不只是 token 数量:连续请求共享稳定前缀时,命中 KV Cache 的部分成本极低;但频繁截断、重排上下文,改动前缀一小部分就可能让整段缓存失效——上下文变短了,总成本未必降。浙江大学联合 HomologyAI 等的 TokenPilot(arXiv:2606.17016,EMNLP 2026 Findings)两头管:信息进入前先整理,易变字段占位化以稳定前缀,对 HTML、终端日志等结构噪声确定性压缩(单任务最多移除约 11.5 万字符 HTML、88.3 万字符日志);退出时按剩余使用价值让片段经历 active → completed → evictable,原文归档外部、保留恢复工具。
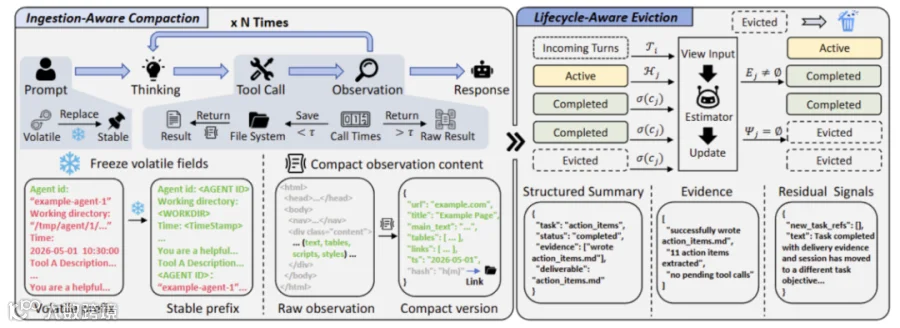 图片说明:TokenPilot 在 runtime 层管理上下文的进入、布局与退出,不改模型参数;压缩与恢复工具必须配套。图片来源:TokenPilot 论文
消融实验说明了边界:去掉恢复工具后成本回升、任务分从 80.92 掉到 77.12——压缩可以,但必须能找回。整体上 PinchBench、Claw-Eval 隔离模式推理成本降低约 61% 和 56%,任务分数基本持平,已作为插件适配 Codex、Claude Code 等框架。
第三条就是前面的显式计划与状态外化。三条路线回答同一件事:把计划、监督、记忆和预算交给外部结构,而不是押在模型的隐式记忆上。
内化训练:让“部分完成”也能被学到
另一条路线是把经验内化进权重。腾讯混元的 T1(arXiv:2609.11042,底座 Qwen3.5-122B-A10B)处理训练侧的信用分配难题:一道终端任务跑几百轮提交,最后只差一项测试没过,奖励若只看全成功,整段轨迹的有效工作全部归零。T1 用计数奖励 r = P / 20(P 为通过的断言数)把“多完成了多少项”变成稠密反馈,奖励在轨迹片段末尾发放、由价值网络向前分配;同时修正长程 MoE 训练中 token 重编码和专家选择的两类训练-推理错位。
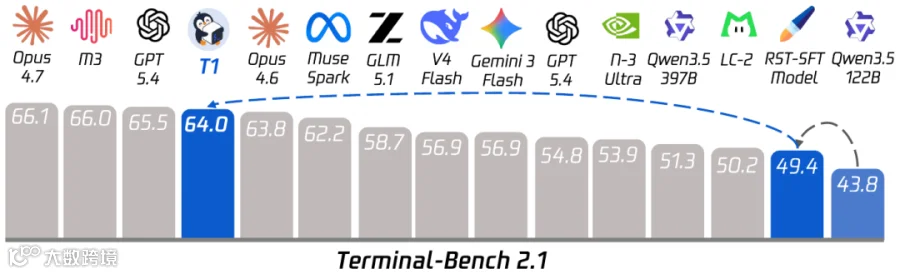 图片说明:同一框架下,底座 43.8%、监督微调 49.4%、T1 强化学习后 64.0%,RL 贡献约 72% 的后训练增益。图片来源:T1 论文
同一 Terminus-2 框架(Terminal-Bench 2.1,89 个任务、60 轮上限)下,同一底座从 43.8% 经 SFT 的 49.4% 升到 64.0%,RL 占后训练增益约七成。三条边界要守住:跨框架分数不能直接比——Claude Opus 4.6 在 Terminus-2 下 63.8%,换 Claude Code 框架就是 70.1%;增益集中在中等难度,高难组只多约 3 个百分点;长程专项 LHTB 的 27.9 是部分完成程度分,不是完全解决率。综述把两条路线的关系讲成双螺旋:Harness 机制逐步被训练内化进策略,更强的策略又解锁更高级的 Harness。
评测标尺:没有长程评测,就没有诚实的进展
外化和内化都需要一把量长程的尺子。LongDS v1.1 从真实 Kaggle 分析工作流构建 68 个任务、2225 轮交互,覆盖六个领域,已被 EMNLP 2026 主会录用;Lite 版精简到 24 个任务、777 轮,每项仍保留约 32 轮完整长程对话。截至 2026 年 9 月 7 日的 v1.1-Lite 榜单上,GPT-6 Astra 以 78.17 分领先,Claude Fable 5.1 为 76.53。
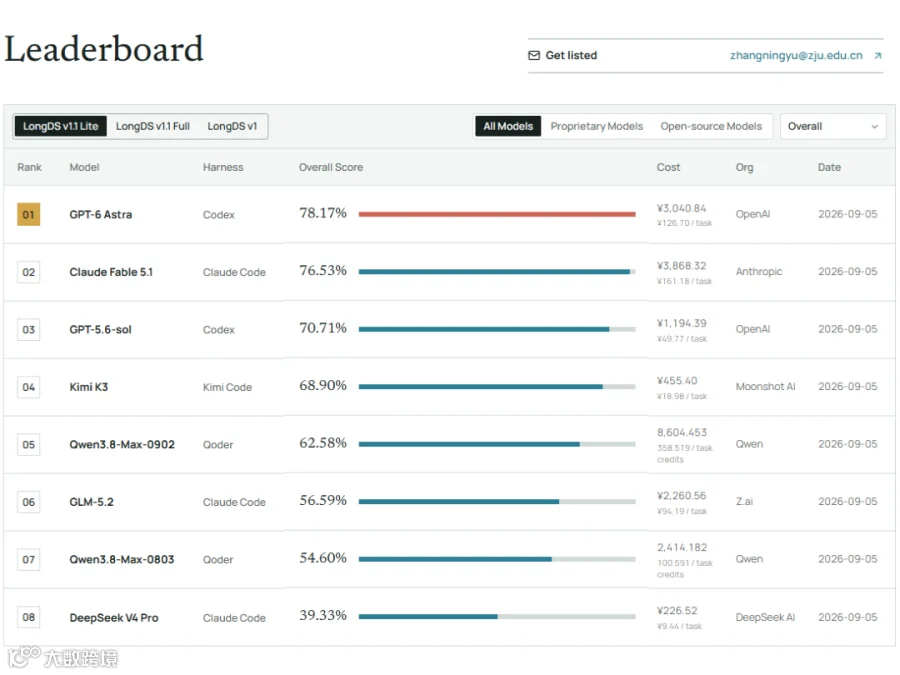 图片说明:LongDS v1.1-Lite 榜单(评测记录日期 2026-09-05);Lite 分与论文原版 DSGym 口径不同,两组分数不可直接比较。图片来源:LongDS-Bench 论文
口径纪律同样适用:榜单是 v1.1-Lite 加新框架,论文原版用 DSGym(最高分 Gemini-3.1-Pro 的 48.45),两套数字不能串读。对工程团队更实用的是论文的改进方向:记录数据来源轮次和有效版本、临时分支与默认状态分开、状态冲突后只重算受影响部分——和 Plan Pane 是同一个思路。
什么任务才值得交给长程 Agent
沿着定义、退化、时间视界、外化三件套、内化训练和长程评测走一圈,能得到几个可操作判断。
先看任务,再看模型。朴素判据:适合长程的任务要有可验证闭环、可迭代反馈、可拆解步骤;PPT、头脑风暴这类没有验收标准的任务,硬上 Agent 只会让昂贵的错误跑更久。这和 T1 的前提一致:只有“完成了哪些要求”可辨认,执行经验才有地方附着。
成本要当成架构变量。TokenPilot 证明前缀稳定和缓存复用可以砍掉过半推理成本,多模型路由(贵模型打关键点、便宜模型跑常规步骤)是同一思路。反过来,没有验证器、没有状态分层、没有预算约束的“放手让它跑”,不是提效,是昂贵地犯错。
最后接受一个现实:50% 与 80% 视界相差 5 到 10 倍,意味着未来一段时间长程 Agent 的生产形态大概率不是无人值守,而是人在关键检查点上当 supervisor——就像 PILOT 里那个随时喊停的角色;豆包 0915 版强调证据溯源和数据核验,本质也是把验证往前提。时间视界还在以 4.3 个月翻一倍外扩,但“能跑多久”和“能被托付多久”之间的距离,只能靠 Harness 和训练一行一行填。长程 Agent 不是更长的 Chatbot,而是状态必须显式、过程必须可验证、经验必须能回流的系统。
参考资料
综述:Towards Long-Horizon Agents: A Survey(OpenReview 公开稿),https://openreview.net/forum?id=HyhfhlbWGh
综述配套仓库:RUC-NLPIR/Awesome-Long-Horizon-Agents,https://github.com/RUC-NLPIR/Awesome-Long-Horizon-Agents
PILOT in the Loop: Live Self-Improvement for Long-Horizon Agents,https://arxiv.org/abs/2608.26530
TokenPilot: Cache-Efficient Context Management for LLM Agents,https://arxiv.org/abs/2606.17016
T1: Terminal Agent Reinforcement Learning for Long-Horizon Tasks,https://arxiv.org/abs/2609.11042
LongDS-Bench: On the Failure of Long-Horizon Agentic Data Analysis,https://arxiv.org/abs/2605.30434
长程任务的可执行分解:Plan Pane 与显式步骤跟踪方法论,https://mp.weixin.qq.com/s/NKpKgco0_yaIYMxqZDEYVA
豆包 2.1 Pro 更新 0915 版本报道,https://mp.weixin.qq.com/s/VHUWFkBNDTuOqHPAq0Co4Q
长程 Agent 与超级团队的未来(企业落地视角),https://mp.weixin.qq.com/s/G_uQ_oD6GCLcSljzo3JmhA
— THE END —
文章仅做学术分享,如有侵权请联系删除,非常感谢!