


点击下方卡片,关注计算机视觉Daily
AI/CV重磅干货,第一时间送达
添加微信号:CVer2233,小助手拉你进群!
扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料及应用!发论文/搞科研/涨薪,强烈推荐!
来源:西电人工智能学院
点击下方卡片,关注计算机视觉Daily
AI/CV重磅干货,第一时间送达
添加微信号:CVer2233,小助手拉你进群!
扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料及应用!发论文/搞科研/涨薪,强烈推荐!
添加微信号:CVer2233,小助手拉你进群!
扫描下方二维码,加入CVer学术星球!可以获得最新顶会/顶刊上的论文idea和CV从入门到精通资料及应用!发论文/搞科研/涨薪,强烈推荐!
欧洲计算机视觉会议(European Conference on Computer Vision,ECCV)是计算机视觉与机器学习领域最具影响力的国际顶级学术会议之一,ECCV 2026于9月8日至12日在瑞典马尔默举行。大会同期设置的国际研讨会与挑战赛,聚焦计算机视觉、人工智能及多模态学习等领域的前沿热点与关键技术问题,吸引了全球高校、科研机构和科技企业的优秀团队参与,赛事竞争激烈,是展示前沿技术成果、检验算法创新能力与实际问题解决能力的重要国际平台。
西安电子科技大学人工智能学院参赛队伍在焦李成教授、刘芳教授、马文萍教授、杨淑媛教授、李玲玲教授、刘旭副教授、陈璞花副教授、孙龙博士、杨育婷博士、马梦茹博士、路小强博士以及团队博士生张柯欣、柴金铭、郝佳瑶、马芹、张京、谢兴霖、贺晶、王一晴等人的共同指导下,在ECCV 2026系列国际竞赛及相关挑战赛中累计斩获13项冠亚季军奖(6冠4亚3季)。团队围绕音视频多模态理解与分割、生成式图像压缩、长时序视频点跟踪、音频理解与生成、具身智能与协同导航、跨域三维感知等前沿研究方向,提出了一系列具有创新性的解决方案。相关成果充分体现了团队在多模态感知、视觉理解、具身智能和跨模态学习等前沿方向扎实的研究基础与持续创新能力,也进一步展现了团队参与国际高水平计算机视觉竞赛的综合实力。本次竞赛所有参赛队伍均得到国家自然科学基金重点、联合项目,教育部创新团队,国家学科创新引智基地等平台与项目的支持。


“ECCV 2026 HOI关节估计挑战赛”聚焦于第一视角(egocentric)RGB 视频中的人-物交互关节理解。赛事设置两级任务:Level 1 将操作关节判别为旋转型(revolute)或平移型(prismatic);Level 2 在第一帧 RGB 相机坐标系下估计关节轴的三维方向向量。赛事提供 kitchen_9 与 kitchen_16 两类厨房场景的 40 段第一视角 RGB 交互片段及配套相机内参,构建了动态第一视角下的小样本关节估计评测数据集。该竞赛由苏黎世联邦理工学院的 Zuria Bauer 高级科学家与弗莱堡大学的 Abhinav Valada 教授等联合主办。由2026级硕士研究生“朱照星、简俊强、龙昊颖”和杨育婷博士组成的队伍获得该赛题冠军。
(朱照星、简俊强、龙昊颖、杨育婷)
冠军方案:参赛队伍针对“相机与关节同步运动、单目深度尺度歧义、小样本无本地真值”的赛题本质,自研“语义-几何双线互补”的关节估计技术体系。在判别端,队伍将片段加工为多模态证据面板,以光流方向图、手部骨架与腕部轨迹等把运动“翻译”成结构化证据,交由 Qwen3-VL-4B-Instruct 视觉语言模型以思维链与强制选择双提示词集成完成关节分类,并以全局物理常数构成的单向几何精修纠正视觉歧义下的系统性偏差;在几何端,队伍挖掘“相机在动、背景静止”的物理事实,以静态背景 SfM/COLMAP 双后端恢复相机位姿,将 KLT 轨迹射线校正至第一帧参考系后经 RANSAC 鲁棒轴拟合与保守融合估计轴方位,并结合实际情况构建了一套基于几何自检的优化方案。最终队伍取得 Level 1满分、Level 2的本届大赛最优性能。该方案突破了动态第一视角下相机运动与关节运动强耦合导致的三维轴方位估计技术瓶颈,解决了小样本无真值条件下旋转/平移关节判别与关节轴精估计的难题,实现了面向厨房家具关节物体理解的可扩展智能解决方案。
“ECCV 2026 LSVOS 基于音频的指代表达视频分割挑战” 聚焦语音引导的指代视频目标分割任务,要求参赛者根据视频和目标运动的语音描述,识别并分割视频中符合描述的目标,当所描述目标不存在时,模型还需输出空掩码。该赛题使用 MeViS v2 数据集,包含大量涉及运动方向、时间顺序和目标交互关系的复杂描述,重点考察模型对语音指令、目标运动及视频时序信息的综合理解能力。该竞赛由复旦大学,南洋理工大学等机构联合举办。由2025级硕士研究生“任苡雯、刘佳宁、王英鑫”和孙龙博士组成的队伍获得该赛题冠军奖项。
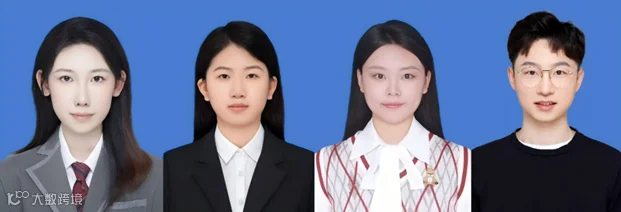
(任苡雯、刘佳宁、王英鑫、孙龙)
冠军方案:队伍提出了一种基于多模型一致性选择的语音引导视频分割方案。该方案首先使用 Qwen3-ASR-1.7B 将语音描述转换为文本,再以 MolmoPoint-8B 和 SAM3 完成目标定位与视频掩码传播,同时结合 SAM2.1、SaSaSa2VA 等模型生成多组互补候选轨迹;随后比较不同候选掩码轨迹之间的一致性,选择可靠性最高的完整轨迹。最后,融合 Qwen3-VL、Qwen2.5-Omni 等模型的判断结果,识别视频中是否存在描述目标。该方案突破了单一模型容易产生目标误判和跟踪偏移的技术瓶颈,有效提升了复杂运动场景下目标分割与存在性判断的准确性。

“ECCV 2026 视频点跟踪挑战赛”聚焦于复杂动态场景下的视频点级目标跟踪任务,要求算法根据视频首帧给定的多个二维参考点,在后续视频序列中持续、准确地预测各目标点的位置,重点考察算法在目标运动、形变、遮挡以及复杂场景变化条件下的时空跟踪能力。赛事构建了覆盖人体运动、动物行为、机器人交互及复杂动态场景的多领域点跟踪数据集,用于全面评估算法在这些场景下的点跟踪精度与泛化能力。赛事鼓励参赛团队开展自主方法创新,并高度重视研究成果的开放性与可复现性。该竞赛由卢布尔雅那大学Matej Kristan教授、捷克布拉格技术大学Jiří Matas教授等视觉跟踪领域学者联合组织。由2025级硕士研究生“杜政霖、李正阳、文怡”和博士研究生“张柯欣”组成的学生队伍获得该赛题冠军。
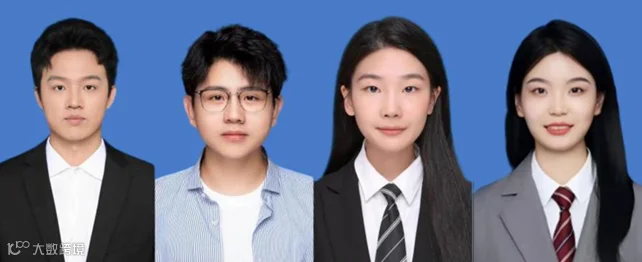
(杜政霖、李正阳、文怡、张柯欣)
冠军方案:队伍提出一种基于AllTracker的高效高分辨率多点跟踪方案。该方案以公开的AllTracker为基础模型,针对VOTSp仅需预测人工指定点轨迹的任务特点,重新设计VOT folder protocol推理封装:按照查询帧对点进行分组,复用同一锚点帧的特征,通过滑动窗口处理长视频,并仅在指定查询位置进行光流采样,避免生成整幅图像的密集轨迹场;同时引入查询点邻域集成、双线性光流采样以及基于像素中心的缩放坐标映射,减小高分辨率缩放和离散采样带来的定位误差,并利用最大图像尺寸与Token数量联合约束控制显存开销。该方案解决了高分辨率长视频点跟踪中计算量与定位精度难以兼顾的问题,在有限算力下实现了高精度、稳定的轨迹预测。


“ECCV 2026 SLoMO音频描述生成挑战赛”旨在推动长视频叙事理解与智能音频描述技术的发展,参赛者需针对电影或短片中的指定时间区间,生成简洁、连贯、符合播放时长且能够准确呈现人物、动作与情节信息的英文音频描述,为盲人和低视力观众提供更具可及性的影视体验。该赛题使用CMD-AD与SF20K两类数据集,设置公开测试与隐藏测试两个阶段,并设有Main Track与Special Track,综合考察模型对跨镜头叙事、人物身份和关键视觉信息的理解能力。该挑战赛隶属于ECCV 2026第二届SLoMO故事级电影理解与音频描述研讨会,由牛津大学、Google DeepMind、巴黎综合理工学院、海得拉巴国际信息技术学院、上海交通大学及MBZUAI等机构的研究人员联合组织。由2025级硕士研究生“彭波连、唐颖”和博士研究生“柴金铭、马芹”组成的学生队伍获得该赛题Special Track冠军与Main Track亚军。
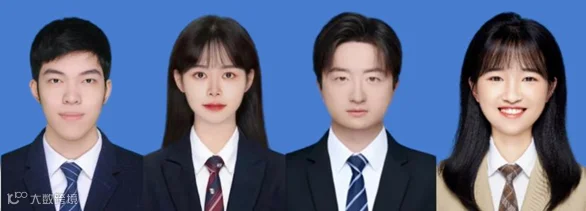
(彭波连、唐颖、柴金铭、马芹)
冠军方案:队伍提出了一套角色锚定、时长感知的多模态音频描述生成系统,以Qwen3-VL为核心,通过目标区间时序采样与边界上下文扩展还原完整动作轨迹,并融合人物肖像和角色候选信息,构建跨镜头、跨场景的身份记忆。在此基础上,方案利用语速控制与专业字幕约束精准控制内容密度,并通过视觉—语言联合QLoRA实现对叙事语义、人物关系和关键动作的协同适配。该系统突破了传统单帧描述在人物一致性、时序连贯性与可朗读性之间难以兼顾的瓶颈,实现了从局部画面感知向故事级影视理解的跨越,为面向视障群体的智能无障碍内容生成提供了高效、稳定、可推广的新范式。

“ECCV 2026 LoViF AIGC 图像压缩挑战” 聚焦AIGC生成图像的超低码率压缩,要求参赛者在平均码率不超过 0.025 BPP 的条件下,兼顾图像重建的像素保真度与感知质量,重点考察文字、边缘、小目标及合成纹理等细节的保留能力。该赛题使用 AIGC-IC-1000数据集,覆盖简短组合指令、密集场景描述、图文混合提示和长篇双语内容四类提示词。该赛题由中国科学技术大学、北京大学联合举办。由2025级硕士研究生“任苡雯、王英鑫、刘佳宁”和路小强博士组成的队伍获得该赛题主观赛道冠军奖项。

(任苡雯、王英鑫、刘佳宁、路小强)
冠军方案:队伍提出一种融合生成式压缩与自适应码率分配的超低码率图像压缩方案。该方案以 NeFIC 为基础编解码器,首先生成低码率锚点重建图像和熵编码码流,再利用 CogVideoX-1.5-5B 扩散模型进行单步重建,恢复图像的纹理与感知细节。同时设置四个固定码率模式,根据不同图像的压缩难度,在全局码率约束下自适应选择最优模式。该方案有效突破了超低码率条件下图像细节易丢失、生成结果易失真以及像素保真度与感知质量难以兼顾的技术瓶颈,显著提升了文字、边缘、小目标和合成纹理的还原效果。

“SLoMO-QA 长视频开放式问答挑战赛” 聚焦于长篇叙事视频的故事级理解与推理,要求模型根据长达10分钟及以上的电影片段,完成长距离情节关联、跨场景人物关系、事件因果关系理解等任务,重点考察模型对长时序视频的关键信息检索、多模态证据整合以及开放式答案生成能力。其中特殊赛道要求最终答案生成模型每个Token激活参数量低于100亿,鼓励参赛团队探索兼顾推理效率与可复现性的轻量化方案。赛事构建了包含20,143部完整短片,总时长超过3,600小时的开放式问答数据集sf20k,面向长时序、故事级视频理解与推理任务。该竞赛由牛津大学、Google DeepMind、上海交通大学等高校及科研机构的研究人员联合组织。由2025级硕士研究生“文怡、杜政霖、李正阳”和马梦茹博士组成的队伍获得该赛题特殊赛道冠军,由2026级硕士曾舒蕾、宋佳轩、邵琳涵组成的学生队伍获该赛题季军。

(文怡、杜政霖、李正阳、马梦茹)
冠军方案:队伍提出了一种基于问题感知帧检索与多源证据增强的免训练开放式问答方案。针对长视频中有效证据稀疏、相邻帧高度冗余以及视觉Token预算有限的问题,首先利用VideoITG-8B根据问题对视频候选帧进行相关性排序,在此基础上结合DINOv2与时空MMR进行重排序,综合考虑图像全局语义、局部特征以及帧间时间距离,最终从长视频中选择32帧关键视觉证据;随后方案融合Whisper语音识别、视频字幕以及基于Qwen2.5-VL 的OCR信息,通过清洗后从不同模态中筛选与当前问题最相关的文本证据;最终,将经过筛选的关键视频帧与多源文本信息按照时间顺序输入Qwen3-VL-8B生成答案,并针对人物、地点、是非因果类问题分别设计回答规则约束,从而降低冗余输入和无依据推理。该方案解决了长视频开放式问答中关键帧分布零散、多模态信息整合困难的挑战,将有限的计算资源集中于真正与问题相关的内容,在无需进行模型微调的情况下取得本赛道的最优性能。

“UCF UrbanTwin Sim2Real LiDAR挑战赛V2X-Real赛道”聚焦路侧激光雷达三维感知中的仿真到真实迁移问题,要求参赛队伍仅使用自主生成的合成LiDAR点云及标注训练检测模型,并在真实路侧隐藏测试数据上完成车辆、行人和卡车等目标的三维检测。该竞赛由美国中佛罗里达大学相关研究团队组织,是面向自动驾驶数字孪生、车路协同感知和三维视觉的重要国际赛事。赛事同时从检测精度和合成点云真实性两个维度进行综合评价,重点考察算法在不使用真实训练标注条件下缩小仿真数据与真实数据域差异的能力。由2025级硕士研究生“罗蒲、许琮、李玉梅”和博士研究生“郝佳瑶”组成的学生队伍获得该赛道亚军奖项。
(罗蒲、许琮、李玉梅、郝佳瑶)
亚军方案:针对合成与真实LiDAR在场景几何、采样密度、回波模式和目标尺度等方面的差异,提出多源协同训练与类别感知融合方案。首先以高保真道路数字孪生点云为基础,引入距离图扩散生成方法改善激光雷达采样模式,并通过固定点数重采样稳定点云密度;针对行人尺度和稀疏观测差异,进一步设计尺寸对齐与结构化稀疏增强策略,形成兼顾几何、采样、密度和目标形态的多源训练数据。随后采用DSVT构建统一三维检测框架,训练采样适应、密度稳定、形态一致性和车辆定位校准等专家模型,并针对车辆、卡车和行人采用不同的类别感知融合路径。最后利用测试点云局部几何信息对预测框中心进行无标注校正,进一步提升真实场景下的三维定位精度与迁移稳定性。该方案突破了合成与真实LiDAR多重域差异适配难题,实现了数据生成、协同训练、类别融合与几何校正的一体化设计,为真实道路场景下的Sim2Real三维感知提供了有效解决方案。
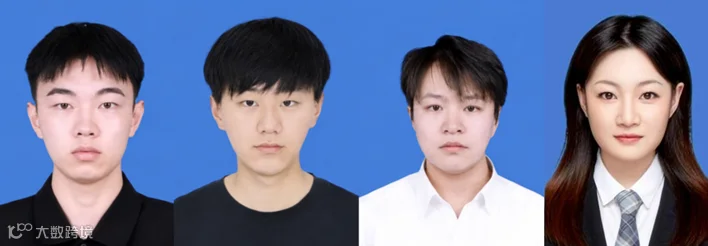
“ECCV 2026 多模态身份遗忘挑战赛:Task 1 人脸身份遗忘(Face Identity Unlearning)”聚焦生成模型中的选择性身份遗忘,要求参赛者在有效擦除指定人脸身份的同时,保留相似非目标身份、姿态与表情等非身份属性以及模型的整体生成质量,竞赛支持使用 CelebA 和 FFHQ 等公开数据集,采用综合目标身份擦除准确率与保留身份识别准确率的 ERB 指标进行排名。该竞赛由来自印度理工学院焦特布尔分校、Meta AI等机构的研究人员共同组织。由2025级硕士研究生“赵振宇、翟子涵”和博士研究生“贺晶、王一晴”组成的队伍获得该赛题亚军。

(赵振宇、翟子涵、贺晶、王一晴)
亚军方案:队伍提出了一种面向扩散式人脸生成模型的轻量级身份遗忘方案。该方案以 Arc2Face 为基础模型,采用最大差异锚点选择策略,从保留身份集合中选取与目标身份在 ArcFace 特征空间内余弦相似度最低的身份作为锚点,并将目标身份嵌入对应的生成结果引导至该锚点身份,从而实现对指定身份的定向遗忘。训练过程中,方案联合使用遗忘损失与保留损失,同时仅微调 UNet 交叉注意力模块中的键、值投影层,其余参数保持冻结,有效降低了训练成本。该方案实现了目标身份的有效擦除,并改善了身份擦除与非目标身份保留之间的综合平衡性能。

“ECCV 2026 CoIN Chanllenge”聚焦交互式多模态图像匹配任务,要求参赛系统根据隐藏目标的文字描述和依次出现的候选图像,判断候选图像是否与目标匹配;信息不足时,系统向 Oracle 提出有效问题,并结合反馈作出判断。比赛提供了包含隐藏目标图像、目标文字描述和候选图像序列的交互式评测数据。每个任务包含一个固定的隐藏目标和多个依次出现的候选图像,候选图像可能与目标匹配,也可能属于干扰项。目标描述涵盖类别、颜色、场景和视觉特征等不同信息类型,要求参赛系统在有限交互次数和判断成本下,准确识别与隐藏目标相匹配的候选图像。本次挑战旨在考察多模态模型在视觉理解、信息推理和交互式决策场景中的综合能力。该挑战由意大利罗马第一大学博士生 Edoardo Zorzi、意大利特伦托布鲁诺·凯斯勒基金会高级研究员 Yiming Wang 联合组织。由2025级硕士研究生”廖朝阳、周晓鹏、郭雨洁”和博士研究生“张京”组成的学生队获得该比赛的亚军奖项。
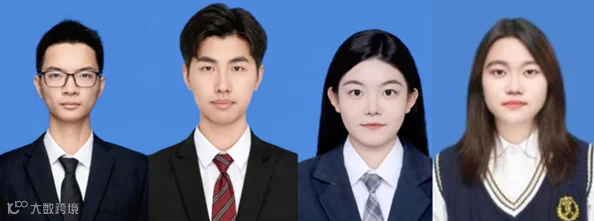
(廖朝阳、周晓鹏、郭雨洁、张京)
亚军方案:针对交互式多模态图像匹配任务,队伍采用“多模态模型+分层记忆+证据约束+规则控制”的混合架构。系统首先利用多模态模型分析候选图像,提取颜色、结构、组件数量、布局及环境等关键视觉特征,并判断是否需要继续提问。在此基础上,构建了分层记忆机制,将记忆划分为目标级和候选级:目标级持续保存目标描述、Oracle反馈及已确认特征,候选级记录当前图像分析与匹配状态。候选切换时仅更新候选级信息,从而实现目标知识复用,并减少候选间的信息干扰。同时设计证据约束机制,对多轮提问与回答进行结构化记录,综合评估证据可靠性。若存在明确冲突,则判定候选不匹配;若目标描述较宽泛,则需多个相互独立且有证据支撑的特征一致后再作出肯定判断,证据不足时继续提出高区分度问题。该方案提升了系统在信息不完整、候选连续切换和多轮交互场景下的判断稳定性与抗干扰能力,使决策过程更加清晰、可追溯,并兼顾准确性、可靠性与可解释性。

“ECCV 2026 DriveX Workshop UrbanTwin Sim2Real LiDAR Challenge — LUMPI Track”聚焦路侧 LiDAR 感知中的 Sim2Real 迁移问题,要求参赛者在不使用真实测试标签的前提下,生成面向 LUMPI 真实分布的合成 LiDAR 数据,并仅基于自生成合成数据训练三维目标检测模型,最终在真实保留测试帧上提交检测结果。该赛题综合考察合成点云的分布真实性与真实场景三维目标检测性能,评价指标由 3D mAP 与点云分布相似性指标共同构成,包括 Chamfer Distance(CD)、Maximum Mean Discrepancy(MMD)、Earth Mover’s Distance(EMD)和 Fréchet Point-cloud Distance(FPD)等。赛事由 UCF Urbanity Lab 主办,是第六届 DriveX Workshop @ ECCV 2026 的挑战赛道之一。由硕士研究生“罗蒲、许琮、李玉梅”和博士研究生“谢兴霖”组成的学生队伍获得该赛题亚军。
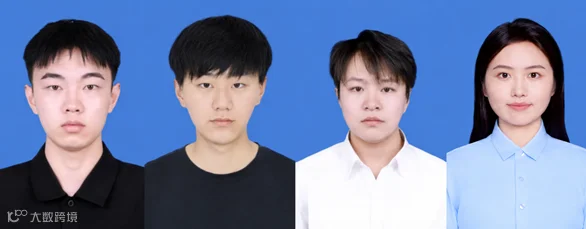
(罗蒲、许琮、李玉梅、谢兴霖)
亚军方案:针对UT-LUMPI合成点云与真实LUMPI路侧LiDAR在点云密度、径向采样、目标形态及类别分布等方面的差异,队伍提出密度对齐的多源合成训练与类别感知融合方案。首先,以UT-LUMPI数字孪生点云为基础,将合成点云重采样至与测试数据一致的50k点规模,并引入RangeLDM生成数据,改善稀疏、不规则的回波采样;针对Bicycle、Motorcycle、Bus、Truck、Van等长尾类别及Person等小目标,采用稀有类别Copy-Paste和行人专项增强,构建兼顾几何、密度、采样与类别分布的多源训练数据。随后,采用DSVT构建统一三维检测框架,训练多类角色模型,并引入Car、Bus的PointPillars专家模型,通过类别级路由、非对称置信度融合、残余召回补充及类别覆盖审计,降低模型相关误差,同时对Bicycle和Person进行尺寸校准。最后,针对点云真实性设计径向密度匹配、弱仿射校准和多版本混合策略,实现检测性能与真实性优化解耦。该方案形成了从分布对齐、多源数据构建到角色化检测、类别感知融合和真实性优化的一体化流程,为仅依赖合成数据的真实路侧LiDAR Sim2Real三维感知提供了有效方案。

“ECCV 2026 力预测挑战赛”聚焦于从第一视角视频中理解人–物交互过程并预测接触力,要求参赛者仅根据夹持器模态下的头戴式 RGB 视频及公开元数据,分别预测交互过程中的峰值合力和接触阶段机械功。赛题基于 Hoi! 多模态数据集,该数据集包含 3,048 段交互序列、381 个可动对象、38 个室内环境和4种操作载体,并同步采集第一视角、第三视角、力/力矩及触觉等多源信息。赛题由 Hoi! 项目及 ECCV 2026 “Force-Grounded, Cross-View Articulated Manipulation”研讨会团队组织,组织者来自苏黎世联邦理工学院、弗赖堡大学、波恩大学、微软和 Meta 等机构。由2025级硕士研究生“李正阳、杜政霖、文怡”组成的学生队伍获得该赛题亚军,由2025级硕士研究生“王英鑫、刘佳宁、任苡雯”组成的学生队伍获得该赛题季军。
亚军方案:针对从视觉信息间接估计物理量时存在的训练样本有限、场景分布差异明显、短时接触事件难以捕捉以及视频全局池化容易丢失时序信息等问题,队伍提出了一种基于冻结 DINOv2 的轻量级时序回归方案。该方案首先从每段交互视频中均匀采样16帧,并使用冻结的 DINOv2 ViT-L/14-Reg 编码器提取高质量视觉特征;随后将视频划分为四个有序时序片段,联合计算片段均值、时序标准差、时序最小值及视频持续时间、帧数和帧率等辅助信息。对于峰值力预测,队伍采用 PCA 降维与 Ridge 回归构建双分支融合模型;对于机械功预测,则融合时序 PCA–Ridge 模型和基于全局 DINOv2 特征的 CatBoost 模型。同时,队伍设计了留一厨房交叉验证、目标场景样本加权、FP16 特征提取和逐帧特征缓存等策略,并通过固定随机种子、模型权重哈希及模块化脚本保证实验可复现。该方案有效提升了模型对交互时序和物理属性的建模能力,为小样本、跨场景的视觉力与功预测提供了一条稳定、高效且便于复现的技术路径。
“ECCV 2026 iMED 挑战赛:新视图合成” 聚焦于复杂可变形外科场景中的内镜新视图生成,要求参赛者依据源内镜视角下的RGB图像、深度信息及相机位姿等观测数据,推断并合成另一留出内镜视角下的目标图像。赛事提供由多内镜同步采集的20个手术场景序列,评测过程强调跨内镜、跨视角条件下的模型泛化能力,综合考察参赛方案对组织非刚性形变、视角与尺度变化等因素的建模与恢复能力。该赛事由伦敦大学学院、范德比尔特大学和Intuitive Surgical等单位联合组织。由2026级硕士研究生“马晓恒、全鹏远”和博士研究生“张京、贺晶”组成的学生队伍获得该赛题季军奖项。
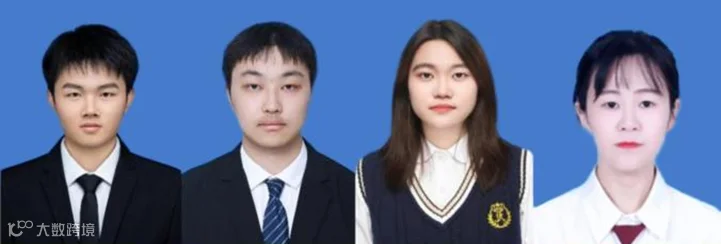
(马晓恒、全鹏远、张京、贺晶)
季军方案:队伍提出一种几何引导和覆盖率感知的新视图生成方法。首先利用源视角RGB、深度信息和相机参数建立目标视角的几何投影,再将投影图像、源图像、归一化深度和覆盖率信息融合,输入轻量级U-Net网络预测目标视图残差,并在高覆盖率区域施加弱保守约束,减少重影和过度修正,同时对齐官方上采样与融合流程,得到高质量的新视角图像。该方案突破了复杂内镜场景中视角变化、遮挡空洞等不完整条件下稳定生成高质量新视图的技术难点,为内镜多视角视觉感知与术中场景重建提供了高效、稳定的技术方案。


西安电子科技大学人工智能学院焦李成教授团队深耕遥感领域三十余载,构建了坚实的理论基础与丰富的工程实践体系,并在计算机视觉与遥感相关的多项国际顶级会议与竞赛中取得了一系列重要突破。团队长期致力于指导学生参与国内外高水平专业竞赛,屡创佳绩。围绕计算机视觉与模式识别领域的前沿挑战,团队持续探索并提出了一系列具有创新性的解决方案,在关键核心技术上实现了突破性进展。同时,依托“以赛促学”的培养机制,学生在真实任务驱动的实践过程中不断提升科研能力与学术交流水平,这一模式也已成为学院创新型人才培养体系的重要组成部分。该培养模式不仅有效促进学生对学科知识的深入理解与科研兴趣的激发,也显著强化了团队协作能力与解决复杂问题的综合素质。近年来,在 IGARSS、CVPR、ICCV、ECCV 等国际顶级会议及相关竞赛中,团队指导学生累计获得百余项冠亚季军奖项,充分体现了卓越的人才培养成效与学科建设水平。
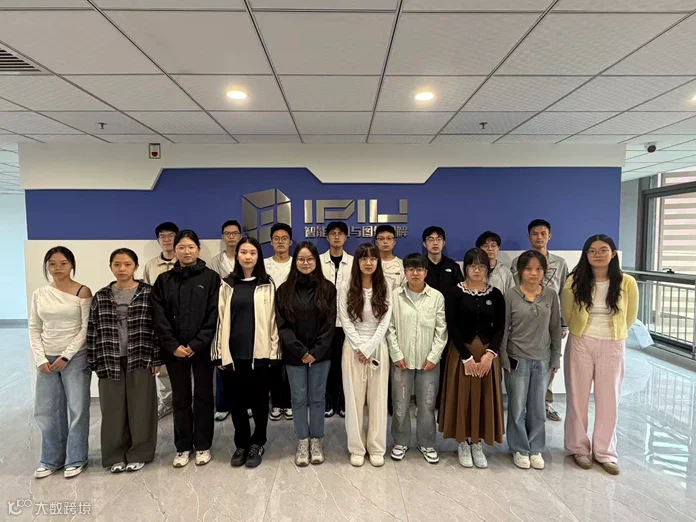
(2025级硕士研究生参赛人员合影)

(2026级硕士研究生参赛人员合影)

END

本文系学术转载,如有侵权,请联系CVer小助手删文
后台回复:绘图神器,即可下载绘制神经网络结构的神器!
何恺明在MIT授课的课件PPT下载
在CVer公众号后台回复:何恺明,即可下载本课程的所有566页课件PPT!赶紧学起来!
CVPR 2025 论文和代码下载
在CVer公众号后台回复:CVPR2025,即可下载CVPR 2025论文和代码开源的论文合集
CV垂直方向和论文投稿交流群成立
扫描下方二维码,或者添加微信号:CVer2233,即可添加CVer小助手微信,便可申请加入CVer-垂直方向和论文投稿微信交流群。另外其他垂直方向已涵盖:目标检测、图像分割、目标跟踪、人脸检测&识别、OCR、姿态估计、超分辨率、SLAM、医疗影像、Re-ID、GAN、NAS、深度估计、自动驾驶、强化学习、车道线检测、模型剪枝&压缩、去噪、去雾、去雨、风格迁移、遥感图像、行为识别、视频理解、图像融合、图像检索、论文投稿&交流、PyTorch、TensorFlow和Transformer、NeRF、3DGS、Mamba等。
一定要备注:研究方向+地点+学校/公司+昵称(如Mamba、多模态学习或者论文投稿+上海+上交+卡卡),根据格式备注,可更快被通过且邀请进群

▲扫码或加微信号: CVer2233,进交流群
       CVer计算机视觉(知识星球)人数破万!如果你想要了解最新最快最好的CV/DL/AI论文、实战项目、行业前沿、从入门到精通学习教程等资料,一定要扫描下方二维码,加入CVer知识星球!最强助力你的科研和工作!


           ▲扫码加入星球学习


            ▲点击上方卡片,关注公众号


            整理不易,请赞和在看

