

Diogo Almeida 参与发明 ChatGPT 之后,问了自己一个问题:聊天模型已经超越人类了,AGI 为什么还没来?
他在 OpenAI 做了让语言模型遵循指令的核心研究,回头看却觉得方向可能走偏了。RLHF 让模型擅长讨好人类,但也种下了过度自信、模式坍缩和幻觉的根。这些东西对聊天可以容忍,对自动化系统不行。
两年隐身开发后,Almeida 的 TypeSafe AI 发布了 Jev。一个不写代码、不聊天、不生成任何文本的模型。它只做三件事:选哪个、打几分、是不是。然后附上一个置信度概率,告诉程序自己有多大把握。
Almeida 说得很直接:20 到 200 倍速度提升,40 到 400 倍成本下降,输出 token 免费。他称之为「AI 经济革命的最短路径」。
48 小时内,该模型迅速爆红出圈,社区冒出了 14 个开源项目。有人拿它做浏览器 Agent,有人让它控制火箭着陆,Vercel 直接把路由集成进了 eve 框架。
它到底是什么
Jev 的定位出奇简单:一个能读懂自然语言的超级分类器。
输入是非结构化文本或 JSON,输出是带概率的定型决策。不做文本生成。输出空间在 API 定义那一刻就锁死了,永远不出类型错误。Almeida 在博客里写得直白:LLM 再聪明,tool call 里的幻觉对自动化系统就是 deal-breaker。Jev 的 schema 匹配是数学上保证的,0%。
TypeSafe 管它叫 System One Model,名字来自卡尼曼《思考,快与慢》的 System 1,对应 LLM 那种逐 token 生成的 System 2。Jev 这个词取自 William Stanley Jevons,提出 Jevons 悖论的那个经济学家:蒸汽机效率提升后煤炭总消耗反而暴增,因为更便宜的能源解锁了更多用途。Almeida 预计 AI 会走同样的路。

三个基本操作:
Noul:判断一个条件是 true 还是 false,返回概率。比如「这个 ticket 紧急吗?」,返回 {yes: 0.92, no: 0.08}。
Choice:从一组选项中选一个,返回完整概率分布。比如「该转给哪个部门?」,返回 billing: 0.71, technical: 0.18, sales: 0.11。单次最多 255 个候选。
Score:在一个有序尺度上打分。比如「紧急程度 1-5」,返回 {score: 4.2} 加每级分布。
Almeida 的总结:一个 frontier-intelligence 函数调用。非结构化状态进去,类型化概率决策出来。
它为什么这么快
核心不是模型训练,而是推理方式。
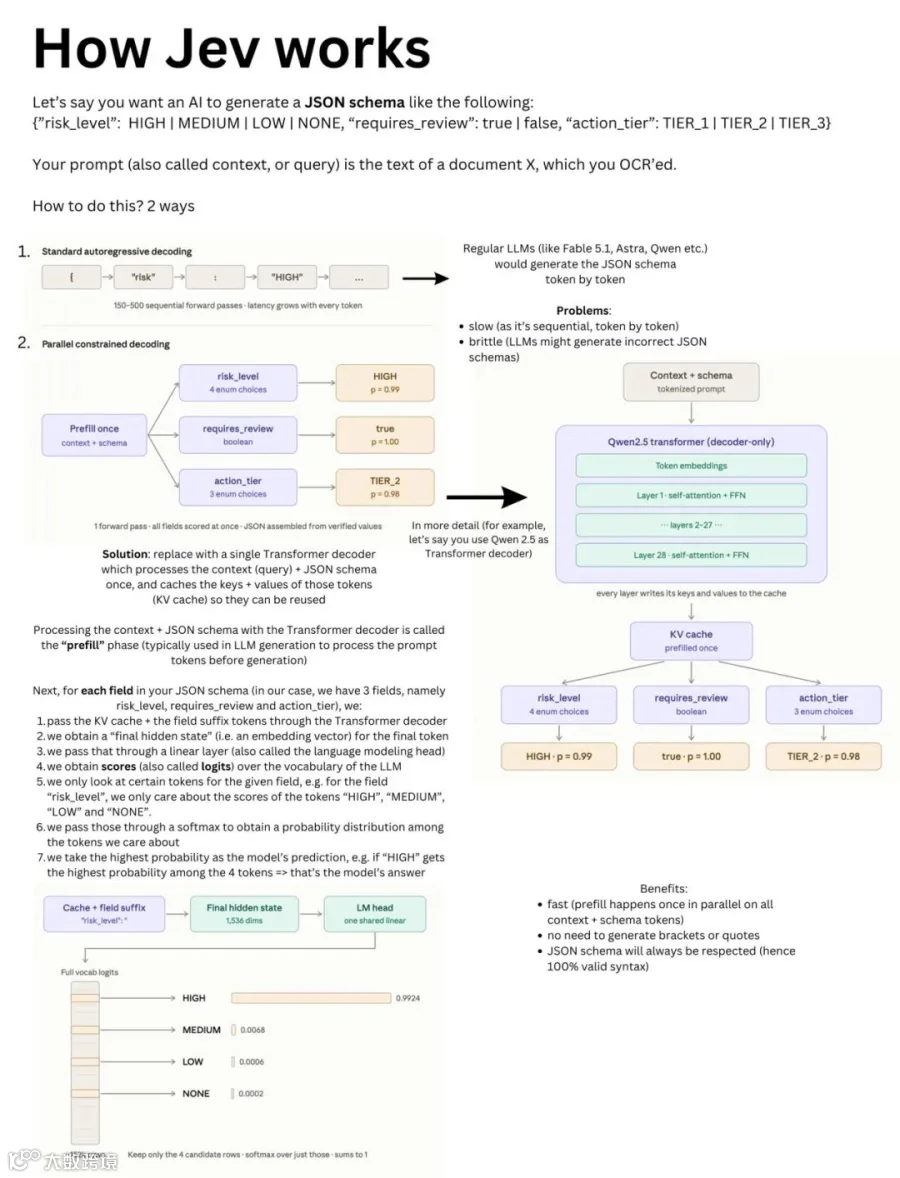
标准 LLM 做结构化输出时,一个 token 接一个 token 地自回归生成 JSON,然后程序再解析。生成 {"is_urgent": true, "department": "billing"} 可能要 150 到 500 次顺序推理。不仅慢,偶尔还会出非法 JSON。
Jev 的做法完全不同:
-
上下文和输出 schema 一起做一次 prefill,生成 KV-cache -
给每个字段创建并行分支,复用这份 KV-cache -
每个分支只看自己那几个候选 token 的 logits,其余全 mask -
Softmax 归一化得到概率分布,取最高的
不往外蹦字,一口气读完上下文,同时回答所有问题。把生成问题变成了并行分类问题。
Harsha Gundala 用 Qwen-2.5-1B 做了开源复现。28 字段的企业工单分类:自回归基线 1,900ms,并行 constrained decoding 270ms。7 倍加速,100% schema 合规。他自嘲:「他们隐身开发了两年,我隐身开发了两小时。」Sam Snelling 也开源了 System One Lite,MLX + 本地模型。
推理技巧跟模型架构无关,任何开源 LLM 改推理引擎都能做到。Jev 真正的壁垒是 TypeSafe 用 RLCD(Reinforcement Learning for Calibrated Decisions)专门训练了一个小模型,让它在「做判断」这件事上比通用 LLM 更准、信心更诚实。
RLCD 这个名字值得展开。RLHF 优化人类偏好,RLVR 优化可验证奖励,RLCD 优化的是校准。模型输出的概率和真实准确率对齐:高置信度意味着高准确率,低置信度意味着该把人叫进来。
一个被反复转引的细节:Almeida 在回复里说,生成式 AI 时代之前,模型校准本来就是 ML 的基本功。不校准怎么放进系统里?
速度、成本,还有「输出免费」
TypeSafe 自建了 4 组自动化工作流评测。给 LLM 用了 System One 适配器包一层确保格式兼容,以 GPT-6 Astra 和 Fable 5.1 的平均值做参考答案。
结论:Jev 最高比 Claude Sonnet 5 快 193.6 倍,比 Claude Opus 5 便宜 444.6 倍。
定价公开。输入 token 每百万 $0.042,输出 token 免费。Almeida 说不是补贴,长期只会降。逻辑简单:Jev 根本不生成 token。
端到端 70ms 到 500ms。Almeida 在推上问:「为什么 SaaS 基本还跟 2019 年一样?」他的答案是延迟。现在延迟降了两个数量级,AI 可以进代码内循环了。
官方 Demo
Almeida 发布视频里带了两个 demo,团队最喜欢的。
Doom。Jev 以约 10 次/秒的频率实时控制角色。同时做多维度判断:要不要开火、当前最高优先级目标是什么、此刻该往哪闪避、怎么移动。所有判断在约 100ms 内并行完成,约 $7/小时。
Jev 判断要不要开火(置信度 0.82)、当前最高优先级目标("restore health" 置信度 0.57)、该往哪闪避("dodge_left" 置信度 0.43)。Almeida 说之后会办黑客松让大家改着玩。
Wikiracing。从「Baseball」跳到「Sun」,每一步在成百上千个链接中选一个。Jev 对阵 GPT-5.6 Terra、Claude Haiku、Claude Sonnet(非推理模式)。
Jev 更快、步数更少。高基数选择场景下不幻觉的优势会滚雪球。超过 255 个候选时用两阶段处理:先独立打分再精选。
14 个项目,社区在玩什么
0xLogicrw 整理的列表是目前最全的汇总。两天之内冒出来。
模型路由:最早被验证的用例
路由的痛点很清楚:简单任务烧大模型太贵,靠规则判断难度又太脆。Jev 用自然语言理解加概率输出来做,一次前向传播决定交给谁。
jev-codex-router 先让 Jev 判断每轮编程任务有多难,再自动决定交给便宜模型还是强模型。237 个真实 turn 回放,成本降低约 60%。
jev-router(Pratyush Garg)给 Claude Code 和 Codex 做了完整方案。Fast、Balanced、Strong、Long 四个 tier,每轮开始时路由一次,同一轮工具循环复用。作者自测 token 用量降了 43%。/jev-explain 能展示 Jev 的选择理由:复杂度 0.82、推理需求 0.91、工具复杂度 0.64。
Vercel 的动作最快。eve 框架内置了 auto 功能,默认用 typesafe-ai/jev 做评估器,从配置的模型列表自动选择。还提供 evaluate 函数,可以在自定义工具里直接调 Jev 做 choice、score、noul 判断,甚至做 tool approval 自动审批。Vercel AI Gateway 上 model ID 就是 typesafe-ai/jev,不需要等 waitlist。
Riley Brown 用 eve 搭了一个 Agent,前端实时展示 Jev 每次选择。Agent Native 放出完整 prompt,复制粘贴就能让 Claude 或 Codex 自己搭一套。
浏览器自动化
jev-ultrafast(Browser Use 团队)。Jev 每步判断做什么、点哪个元素,需要输入文字时才调小模型。Google Flights 搜航班完整跑完 7.1 秒。Agent 主循环里没有截图,Jev 直接消费结构化 DOM 状态。
编程工具链
Winnow 给 Claude Code 做上下文垃圾回收。Read、Bash、Grep 输出太长时,先让 Jev 判断哪些内容跟当前任务有关。
Jev Review 做代码审查前置筛选,先判断 correctness、security、reliability,再把重点问题交给更重的模型。
Blink 在代码库里做语义寻路。每到一个目录层,Jev 判断哪些文件最可能跟问题有关,把更多搜索资源分配过去。
SemDecide 把 Jev 做成 Unix 命令行工具,直接塞进脚本和 CI。
游戏与物理仿真
1v1 Jev 做了一个 FPS,约 9Hz 判断移动、瞄准、射击、跳跃。
Utkarsh Agrawal 的实验更离谱。MuJoCo 里搭了一个 Falcon 9 级火箭:42 米助推器、425 吨、9 台发动机、真实大气、马赫相关阻力、风速、燃料消耗。Jev 全权控制发射到着陆。没有自动驾驶脚本,没有预设轨迹,代码里没有安全否决。决策频率约 1Hz,输出延迟约 0.4 秒。火箭每 0.8 秒就会变得不稳定一次。
12 次实验后助推器成功着陆。245 次 API 调用,$0.04。Jev 自己在着陆段选了 5 台发动机点火。
量化交易
Prism 让 Jev 判断流动性池的 toxic flow、市场压力、均值回归可能性。默认 shadow/advisory 模式,不直接驱动交易。
Agent 集成与桌面自动化
typesafe-mcp(Go)和 jev-mcp(Node.js)把 Jev 接进了 Claude Code、Claude Desktop 和 Codex。后者封装了事实核验、Prompt Injection 检测和语义排序。
jev-desktop 读取 Accessibility Tree,Jev 判断该操作哪个控件。neo4jev 在知识图谱上做概率寻路。
争议和回应
Niels Rogge 发推吐槽:1200 万次观看就为了一个 JSON 分类器?我们确实在一个泡泡里。
从技术本质看,Jev 做的就是拿预训练模型的编码能力在固定 schema 上做并行分类,跟 BERT 时代的 token 分类没本质区别。
但反驳也有道理。自回归 LLM 在这个领域表现其实很差,伪置信度输出既不准也不便宜,但差得刚好让人继续用。Jev 的真正价值不是分类本身,而是把这件事做到足够快、足够便宜、足够可靠,让它能在代码里被当做函数调用。
Almeida 博客的 FAQ 也坦诚:Jev 不是小号 LLM,用了全新架构、全新采样器、全新训练方法。目标不是传统 benchmark 跑分,是造一个软件能依赖的接口。
一个模式
14 个项目一个模式:Jev 反复做「要不要、选哪个、打几分、下一步干什么」的快速判断。需要生成代码、写文章、复杂推理时,交给传统大模型。
以前 Agent 决策层靠 LLM 生成文本实现。让模型输出一个 JSON 告诉你下一步干什么,然后解析它。一个适合写文章的工具硬做结构化判断。
Jev 把决策和生成了剥离。输出 token 免费这件事也是最精准的商业信号:TypeSafe 赌的是决策调用量会远超生成调用量。
如果 Almeida 的判断是对的,AI 自动化需要的不是一个更强的聊天模型,而是一个软件能依赖的接口。就像 Jevons 悖论说的:效率每提一个数量级,总用量反而暴涨。一个输入 $0.042/MTok、输出免费、70ms 响应的判断原语,可能只是开头。
目前 Jev 还在早期访问阶段,waitlist 批得很快。不想等的可以直接通过 Vercel AI Gateway 调用,model ID:typesafe-ai/jev。
关注公众号回复“进群”入群讨论