


为什么AI第一个字很慢,后面却能连续输出?
一次回答包含两种完全不同的计算:Prefill集中处理输入,Decode复用缓存并逐Token生成。
核心判断:Prefill决定什么时候开口,Decode决定开口以后说得是否流畅。
学生拿到一张试卷,通常会先把题目、材料和条件读完,再开始逐步写答案。
大模型回答问题,也可以先这样理解:它先集中处理整段输入,再一个Token一个Token地生成回答。 前一段叫Prefill(预填充),后一段叫Decode(解码)。
这个类比有一处需要说清:大模型不是在Prefill阶段已经想好整段答案。它只是完成输入侧的计算,把后续会反复用到的信息写进KV Cache,并得到第一组候选Token分数。真正的回答,仍要在Decode阶段一步步生成。
这两个阶段运行的是同一套模型权重,计算形态却很不一样:
• Prefill一次处理大量输入Token,容易把GPU计算单元用起来;
• Decode对单个请求每轮只生成一个新Token,更依赖显存带宽与KV Cache读取;
• Prefill主要影响多久看到第一个Token,Decode主要影响后面的输出是否流畅。
因此,一次大模型回答并不是同一种计算从头跑到尾,而是两种负载接力完成。
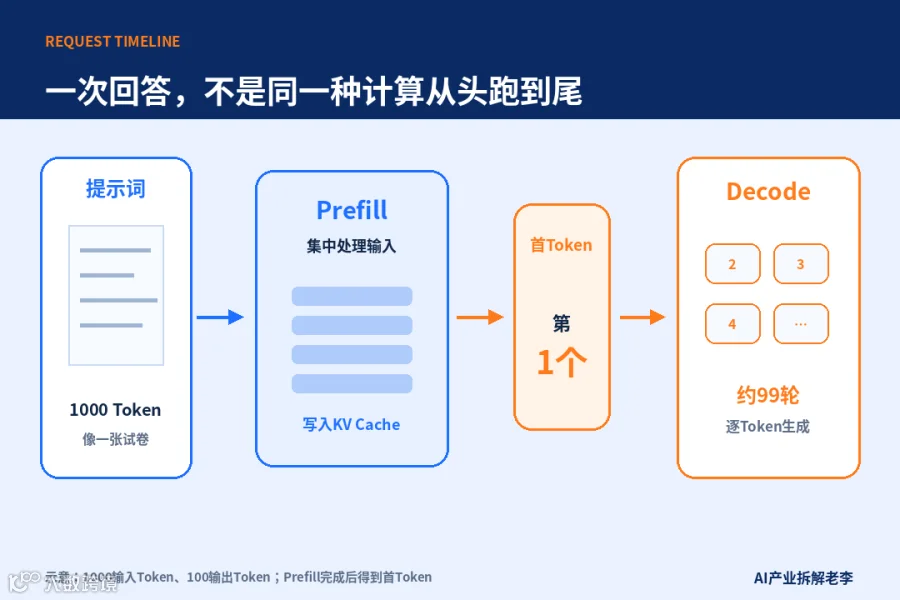
图1:以1000个输入Token、100个输出Token为例。Prefill集中处理输入并得到首个输出Token,随后还要进行约99轮Decode。数字仅用于解释机制。
一、Prefill:先把整张“试卷”读完
假设用户提交了一段1000个Token的提示词。模型不会把这1000个Token逐个送进GPU、等待1000轮,而是把它们组成一个序列,尽可能并行地送过每一层Transformer。
在每一层里,输入Token都会产生Q、K、V,注意力机制再计算它们之间的关系。由于自回归模型使用因果遮罩,每个位置只能看到自己和前面的内容;但这些位置的计算可以组成大矩阵,在GPU上同时展开。
Prefill阶段会完成三件事:
1. 理解输入。 让提示词中的每个位置经过Embedding、注意力层和前馈网络;
2. 建立缓存。 把各层、各位置的K和V写入KV Cache,供后续生成复用;
3. 产生首个Token。 最后一个输入位置经过LM Head得到logits,再由采样规则选出回答的第一个Token。
如果把提示词比作试卷,KV Cache更像模型留下的一套“计算笔记”。它不是自然语言摘要,也不会把整段答案预先写好;它保存的是各层注意力后续还会用到的中间状态。

图2:Prefill让整段输入通过Transformer,各层同时为输入位置建立K/V缓存;最后一个输入位置产生首组logits并选出首Token。
二、Decode:为什么回答必须逐Token生成
首个Token选出来后,它会被追加到原有上下文中。模型接下来要回答的问题变成:
> 已有提示词 + 刚刚生成的Token,下一步最可能是什么?
这时进入Decode阶段。每一轮只为最新Token计算新的Q、K、V;历史Token的K和V不再重复计算,而是直接从KV Cache中读取。新的Q再和全部历史K进行匹配,用历史V汇总出当前结果,最终得到下一组logits并选出下一个Token。
随后,这个新Token又会成为下一轮上下文的一部分。模型重复同样的过程,直到选中EOS、EOT等结束标记,或者达到系统设置的输出长度。
因此,对一个标准自回归模型来说,第20个输出Token依赖前19个已经生成的Token,第21个又依赖前20个。单个请求内部存在前后依赖,不能像Prefill那样一次并行生成整段回答。
如果总共输出100个Token,Prefill结束时已经得到首Token,后面还要执行约99轮Decode。每一轮虽然只新增一个Token,却仍要让它穿过全部Transformer层。
服务系统可以把许多用户当前要生成的“下一个Token”组成Batch,一起送进GPU。这样能提高利用率,但只是在不同请求之间并行;同一个请求仍然要按顺序往下生成。
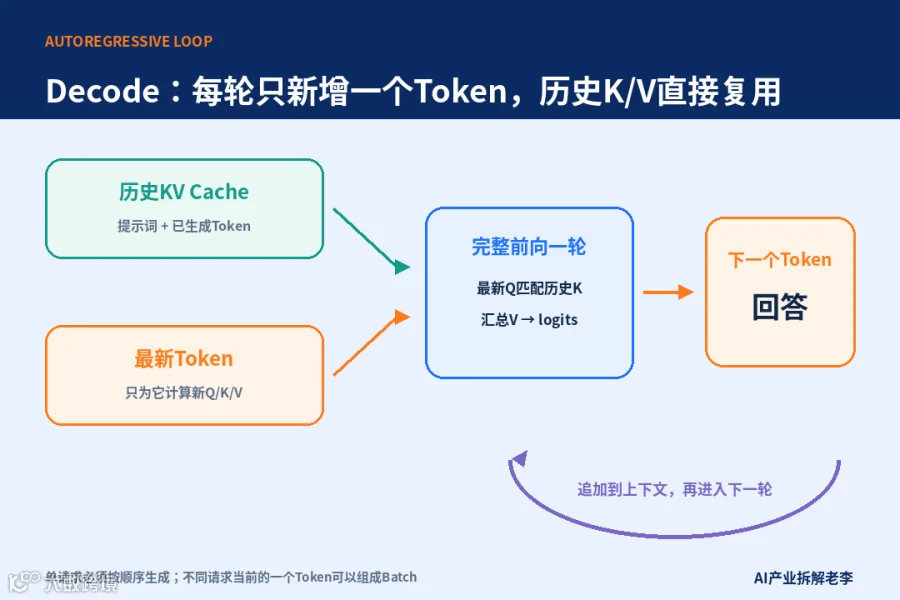
图3:Decode每轮只计算最新Token,并复用历史K/V;本轮选出的Token会进入下一轮,形成无法在单个请求内部完全并行的生成链。
三、同一套模型,为什么形成两种GPU负载
Prefill和Decode都会经过相同的Transformer层,差别来自一次计算中包含多少Token,以及每读取一份数据能完成多少运算。
Prefill一次处理大量Token,矩阵较大,同一份权重数据可以参与更多运算,通常具有更高的计算强度。GPU中的矩阵计算单元更容易被充分使用,所以业界常把Prefill概括为计算密集型阶段。
Decode则不同。对单个请求而言,每轮只有一个新Token,却要反复读取模型权重,并读取随上下文增长的KV Cache。搬运的数据很多,能并行执行的计算却较少,因此通常更容易受HBM显存带宽限制,被概括为访存密集型阶段。
这是一种常见规律,不是绝对结论。Batch大小、上下文长度、模型结构、量化精度、硬件和算子实现都会改变瓶颈。并发请求足够多时,Decode也可以形成更大的矩阵;输入很短时,Prefill也未必能把GPU算力完全用满。
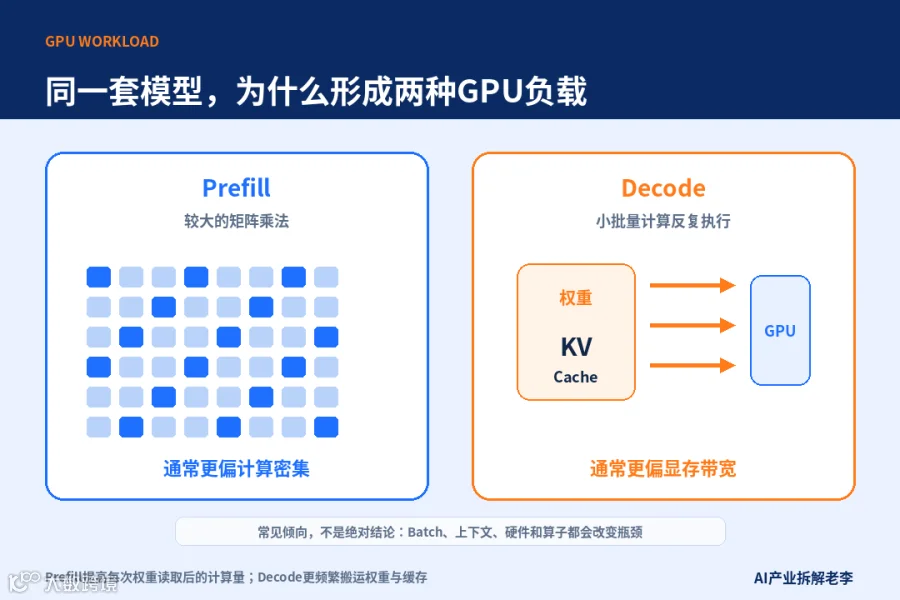
图4:Prefill更容易形成大矩阵并提高计算利用率;Decode每轮处理的新增Token少,需要反复读取权重和KV Cache,通常更依赖HBM容量与带宽。
四、首字慢、后面卡,分别看什么指标
用户对一次回答的体感,至少要拆成两个指标。
TTFT(Time To First Token,首Token延迟),是从请求发出到看到第一个输出Token的时间。它不仅包含Prefill,还可能包含排队、调度、分词、网络传输和第一次采样;但在输入较长时,Prefill通常是其中的重要部分。
TPOT(Time Per Output Token,每个输出Token耗时),常用来描述首Token之后相邻输出Token的平均间隔。有些系统也称它为ITL(Inter-Token Latency,Token间延迟)。TPOT越低,流式回答看起来越顺畅。
一段回答的总延迟,可以粗略理解为:
> 总延迟 ≈ TTFT +(输出Token数 - 1)× 平均TPOT
这只是帮助理解的近似式。真实服务中,每轮调度、Batch变化和网络抖动都会让Token间隔上下波动。
由此可以区分三种情况:
• 输入很长:Prefill工作量增加,首Token通常要等更久;
• 输出很长:Decode轮数增加,总生成时间和服务成本随之增长;
• 上下文很长:不仅首Token更慢,后续每轮Decode还要读取更多KV Cache。
所以,“首字慢”和“后面卡”不是同一个问题。前者优先检查排队与Prefill,后者更需要看Decode调度、HBM带宽和并发负载。

图5:TTFT覆盖请求提交到首Token出现;TPOT描述后续Token之间的间隔。长输入主要抬高Prefill工作量,长输出主要增加Decode轮数。
五、为什么推理系统开始分别优化两阶段
如果Prefill和Decode混在同一批GPU上运行,一个很长的输入可能占用较长计算时间,让已经开始生成的其他请求暂时等候。用户看到的结果是:新请求的首Token慢,正在输出的请求也可能突然停顿。
现在常见的优化方向有两类。
第一类是Chunked Prefill(分块预填充)。 系统把一段很长的Prefill拆成较小的块,穿插到Decode任务之间。它不改变模型的生成逻辑,主要是把一大段连续计算拆开,减少长输入对流式输出的阻塞。
第二类是Prefill-Decode分离部署。 Prefill放在更适合大矩阵计算的资源上,Decode放在更重视显存容量、带宽和并发调度的资源上。Prefill完成后,再把KV Cache传给Decode节点。DistServe、Splitwise以及TensorRT-LLM的相关实现,都沿着这个方向探索。
分离部署也有代价。KV Cache可能很大,跨GPU或跨节点传输会占用互联带宽;路由、故障处理和缓存管理也更复杂。输入很短、流量较低或网络条件不合适时,拆开未必更快。
真正的优化目标不是形式上的“分离”,而是让首Token延迟、逐Token速度和单位GPU吞吐量同时满足业务需求。
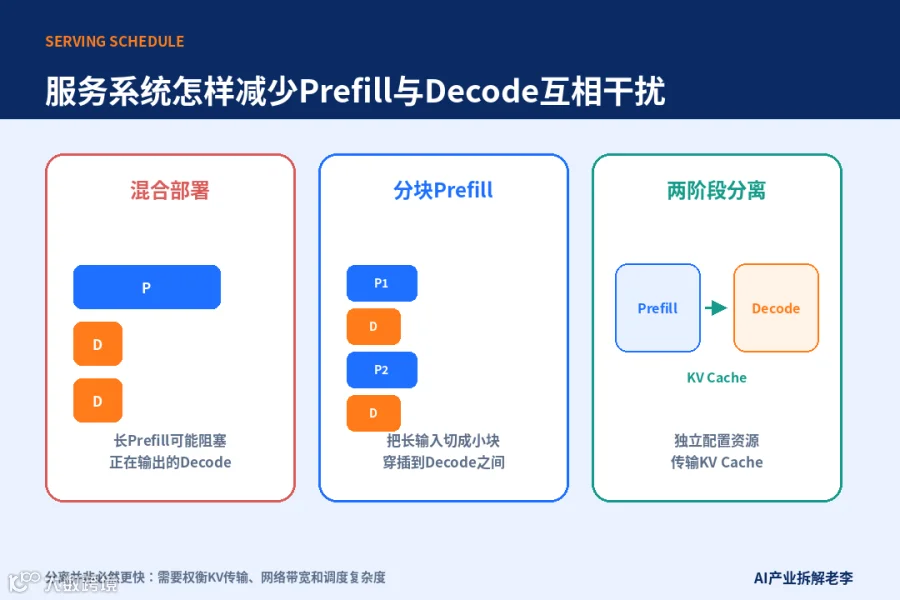
图6:混合部署容易产生Prefill与Decode干扰;分块Prefill把长任务切开;分离部署允许两阶段独立配置资源,但需要传输KV Cache。
六、从一条回答,看见AI Infra的真实边界
现在再回到那张试卷:
• Prefill负责把题目和材料集中处理,建立后续可复用的计算状态;
• Decode根据已经生成的内容,一步步写出后续Token;
• KV Cache连接两个阶段,Prefill负责写入,Decode负责持续读取和追加。
这也是为什么评价一套大模型推理系统,不能只看芯片峰值算力。Prefill需要矩阵计算能力,Decode还要看HBM容量与带宽;继续扩展到集群,还要看互联、算子、并行策略和调度系统。
对国产AI算力也是如此。单卡参数决定能力上限的一部分,能否让两种负载都高效运行,才决定模型最终能以多快的速度、多低的成本服务真实用户。
下一篇继续沿着这条链往下拆:Prefill写下、Decode反复读取的KV Cache,为什么会随着对话变长迅速占用显存?
> 看懂 AI 产业,看见新机会。
关注「AI产业拆解老李」,继续从一个提示词出发,拆开大模型背后的推理系统。
如果身边有人分不清“首字慢”和“生成慢”,可以把这篇转给他。