



戴 WHOOP 的人,多少有点爱“炫耀”。
在 WHOOP 用户的世界里,连睡觉都可以拿来比赛。早上醒来,先看看自己今天是绿了、黄了还是红了。Recovery 90% 以上,当然得在群里炫耀一下;一觉醒来只剩 1%,也同样值得截图留念——甚至有人专门组建了“1% club”。
睡得好可以晒,练得狠可以晒,宿醉后的惨烈低分也能晒。WHOOP 又很懂得顺水推舟,App 里的 Teams、排行榜和群聊让成员互相查看 Strain、Recovery 和 Sleep,比较每天、每周甚至每月的表现。一组原本非常私人的生理指标,就这样变成了可以讨论、比较,甚至带点竞技意味的社交内容。
这也让 WHOOP 和 Oura 形成了一个很有意思的对照。两家公司提供的核心价值其实很接近。WHOOP 用腕带持续记录心率、HRV、睡眠、压力和运动负荷,Oura 则通过戒指追踪睡眠、心率、压力、活动和血氧等身体指标,两者最终评估的都是用户的身体状态。

但两种产品长出了很不一样的用户文化。WHOOP 更 pro-social。它从产品设计上就在鼓励人们组队、排名、比较,再通过群聊讨论。你今天 Recovery 92%,你的朋友只有 48%,这组原本毫无社交属性的生理指标,突然就变得有点像跑步配速、健身重量,甚至游戏积分。
Oura 更接近一种 private、introspective 的产品。它当然也有 Circles,用户可以和亲友分享 Readiness、Sleep 和 Activity 三项分数,但一个 Circle 最多 20 人,互动主要是表情回应,目前连完整聊天功能都没有。
两者的差别看起来只是产品设计,却指向了健康消费里一个很有意思的变化——身体健康数据俨然已经变成了一种社交货币。而分数,是这种社交货币成立的关键。
如果你晒出你的 HRV(Heart Rate Variability,心率变异性)是 48 毫秒,可能根本没人能看懂;但如果你晒你今天的 Recovery 93% ,绿色截图一发,所有人立刻都知道你今天状态真棒。
过去十年,可穿戴设备一直在努力增加可以测量的东西。步数之后有心率,心率之后是血氧、睡眠阶段、HRV、压力和训练负荷。传感器越来越多,最后却制造出了另一个问题——普通消费者面对几十条曲线,很难知道这些数字到底有什么用。
所以 WHOOP、Oura 这类产品真正做对的一件事,是替用户把复杂的数据压缩成容易理解的结果。你不需要知道昨晚 HRV 为什么比自己的 30 天均值低 7%,只需要知道今天 Recovery 是红的,得多加注意。

现在,苹果(Apple)也正式加入了这场比赛。上周发布的 Apple Watch Series 12 和 Ultra 4 首次加入 Readiness。系统综合近期活动、训练负荷、身体指标和睡眠,每天给出一个 0 到 10 分,再对应 Recover、Pace Yourself、Ready 或 Go For It 四种建议。新一代 Apple Watch 同时把日常心率采样提高到每 5 秒一次,HRV 最快可以每 5 分钟测量一次,但这些更复杂的采集最终都服务于一个目的,那就是让你更清楚地知晓自己的身体状态。
这个变化比多增加一个健康指标更值得关注。WHOOP 的 Recovery、Oura 的 Readiness,以及现在 Apple Watch 的 Readiness,本质上都在做同一件事。设备在后台测得越来越复杂,消费者真正面对的界面却越来越简单。过去专业运动员需要结合训练量、睡眠和恢复数据做判断,现在普通人在上班之前看一眼手腕,就知道今天是不是该悠着点儿。

这套产品逻辑已经被证明可以做成一门相当不错的生意。到 2026 年 7 月,WHOOP 全球会员已经超过 300 万,最近新增的 100 万会员只用了 7 个月。公司 2025 年收入增长超过一倍,到年底年化经常性收入已经达到约 10 亿美元。
硬件在这里更像一个持续收集信息的入口。WHOOP 戴得越久,系统越能建立起稳定的个人基线,知道你平时睡多久、运动后恢复多快、HRV 通常落在哪个区间。相比用了三年也不会更了解你的耳机,健康设备的价值会随着长期数据积累继续增加,这也带来了一种普通消费电子少见的用户黏性。

而可穿戴设备收集的数据越来越多的同时,产品本身却在尽量减少用户需要主动查看和操作的部分。WHOOP 从一开始就没有屏幕,Oura 干脆把设备做成一枚戒指。谷歌(Google)今年推出的 Fitbit Air 也采用无屏设计,设备在后台持续记录心率、HRV、血氧和睡眠,用户主要通过手机查看结果。
相比不断增加通知、图表和提醒,越来越多品牌开始把复杂的采集留在后台,只在真正需要的时候给出一个分数或结论。毕竟,设备可以 24 小时记录身体,但用户不可能 24 小时盯着数据。
这也和最近健康行业里出现的“反优化”趋势形成了一个有意思的呼应。越来越多消费者开始厌倦每天研究睡眠分数、血糖曲线和各种身体提醒,希望少一点追踪,多一点对自身感受的关注。
另一群人截然相反,他们觉得 WHOOP 给出的一个 Recovery 分数还不够,还想知道为什么今天只有 62%,最近为什么一直睡不好,工作安排是不是正在拖累训练状态。他们就是最近被称为“Datamaxxers”的一群人。
过去几年互联网里涌现了各种 maxxing。有人 looksmaxxing,研究怎么把外貌优化到极致;有人 sleepmaxxing,想方设法提高睡眠质量。Datamaxxers 想优化的范围更大,他们把睡眠、运动、心率、HRV、饮食、屏幕时间一起记录下来,有些人还会加入工作日历、聊天记录,甚至医疗信息,再交给 AI 寻找规律。
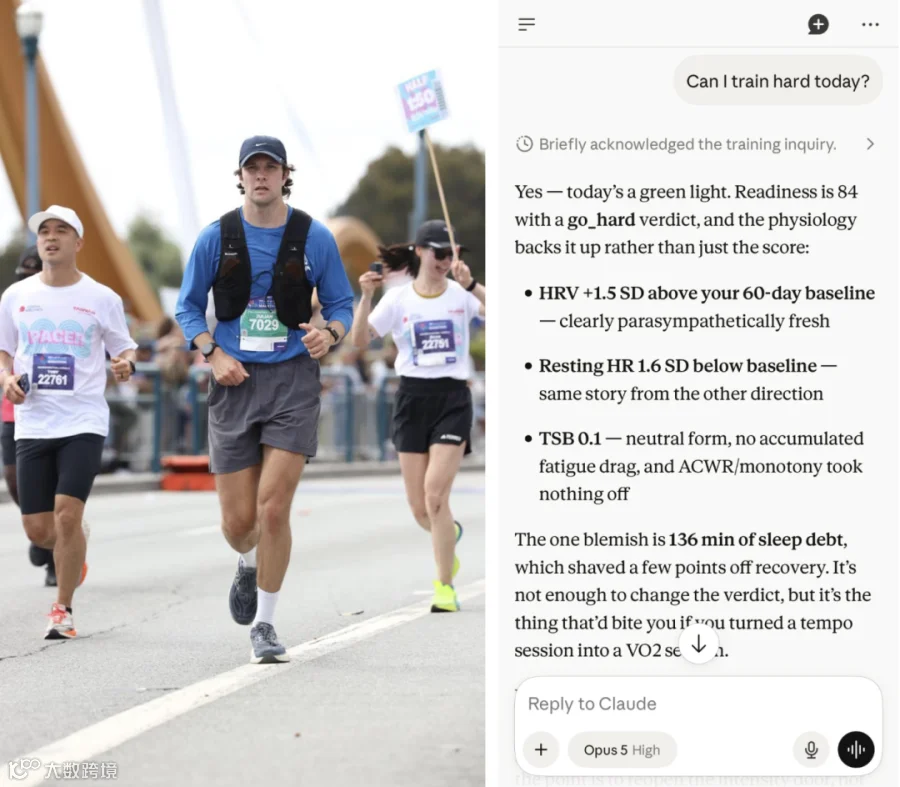
25 岁的软件工程师 Julian Flieller 过去训练马拉松时,一直会看手表和其他设备给出的各种身体数据。但这些数字经常只会增加困惑。比如设备告诉他今天的 HRV 是 60,他知道这个指标和恢复状态有关,却很难判断 60 对自己来说到底算好还是坏,更不知道接下来应该怎么调整训练。
现在,他开始把这部分工作交给 Claude。Claude 会读取他的运动、睡眠和其他生理数据,再结合最近的工作安排判断状态。如果前几天睡得不好、工作特别忙,或者训练负荷已经偏高,Claude 会据此调整训练建议。
这正是过去十年可穿戴设备一直没完全解决的问题。硬件早就会记录,消费者真正缺的是解释。
这也是 Datamaxxing 和早期 Quantified Self 最明显的区别。过去的量化自我更像长期记账,数据主要用来回顾。而 datamaxxers 关心的是这些变化为什么发生。
问题在于,答案往往散落在不同地方。Oura 知道你昨晚睡得怎么样,Garmin 知道你跑了多少公里,Strava 知道路线和配速,Google Calendar 知道你一天开了多少会。每个 App 都掌握一部分信息,却很难单独解释完整的生活状态。原来只有技术爱好者愿意自己导数据、写脚本、搭 dashboard。现在,大公司正在把这些麻烦步骤省掉。
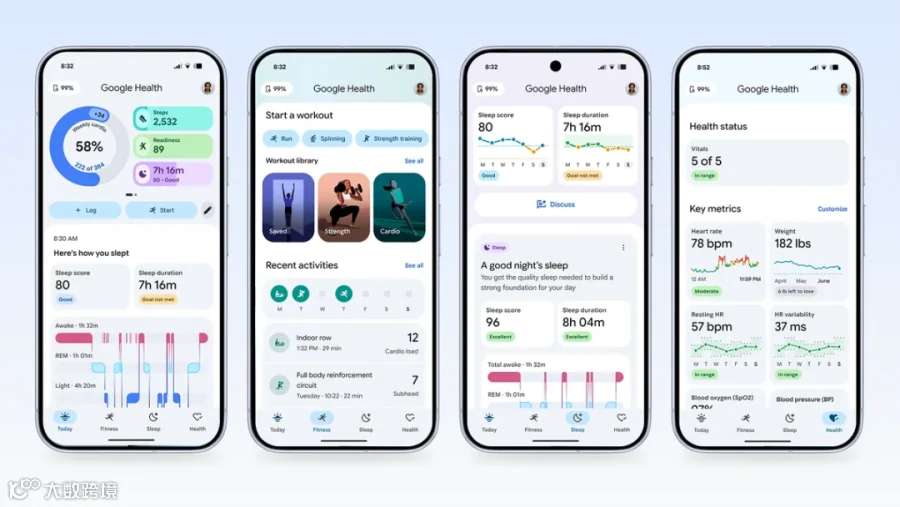
2026 年 5 月,谷歌(Google)把 Fitbit App 更名为 Google Health,并把 Gemini 驱动的 Health Coach 放到产品核心。用户可以把可穿戴设备、营养记录和医疗档案放进同一个入口,再直接询问最近的身体变化。谷歌还计划接入 Apple Watch、Garmin、WHOOP 和 Oura 等第三方设备。

微软(Microsoft)的 Copilot Health 进一步把医疗记录也接进来。用户可以导入病历和化验结果,同时连接 Apple、Oura、Fitbit 等设备。OpenAI 的健康产品也在沿着类似方向发展,让用户把 Apple Health、医疗记录、饮食和运动信息放进同一个对话里。
怎么把这些数据解释清楚,成了 AI 最有吸引力的地方,同时也是最容易出错的地方。人体状态很少只有一个单一原因,而 AI 最擅长把零散信息整理成一个完整故事。数据一多,答案反而容易显得可信起来。
The Verge 此前测试 Strava、WHOOP 和 Oura 的 AI 功能时就发现,不少所谓个性化分析,只是把已有的数据重新说成一句完整的话。系统知道用户当天跑得比平时少,也掌握长期训练记录,却未必真的理解受伤、高温或者生活变化为什么影响了表现。而当 datamaxxers 把睡眠、运动、工作和医疗信息全部一股脑喂给模型,他们更容易把 AI 给出的流畅回答当成可靠的解释。
更麻烦的是,数据还会反过来影响行为。
Vox 一名记者曾经同时使用 Apple Watch、Oura、WHOOP 和连续血糖仪生活半年。频繁出现的数据提醒让她越来越在意每一次血糖波动,开始改变正常饮食,甚至为了避免数字变差而回避一些食物。
WHOOP 用户晒 Recovery 的底层逻辑也是相似的。早上醒来明明觉得精神不错,一看 Readiness 只有 3 分,可能立刻开始怀疑自己是不是完蛋了;而一个 95% 的 Recovery,可能立刻让人振奋起来觉得可以大干一场。
再往前一步,“判断”就变成了“建议”。“今天少跑一点”“晚上早点睡”“下午别喝咖啡”“连续几天状态不好,最好去看医生”……到了这里,普通健康管理和医疗判断之间的边界也会越来越模糊。问题在于,AI 目前还远没有稳定理解长期身体数据的能力。

今年 9 月发布的 WearableQA 专门测试了大模型处理真实可穿戴数据的表现。研究团队使用 200 名真实用户最长 500 天的连续数据,围绕可穿戴设备、血液指标和人口统计信息设计了 4084 道问题,再测试 14 个商业和开源模型。最终准确率从 19.6% 到 72.9% 不等,大多数模型都没有超过 60%。
《华盛顿邮报》记者 Geoffrey Fowler 也做过一个实验。他把自己十年的 Apple Watch 数据交给 ChatGPT Health,包括约 2900 万步和 600 万次心跳记录,然后让 AI 给自己的心脏健康打分,ChatGPT 给出了一个令人震惊的 F。
Fowler 随后把结果拿给自己的医生和心脏病专家 Eric Topol。医生认为他的心脏病发作风险实际上很低,甚至直接把这份分析批判为“毫无根据”。更麻烦的是,同样的问题重复问几次,ChatGPT 给出的评分还会在 F 到 B 之间横跳。数据足够多,很容易让一份分析显得格外有分量,却并不意味着结论真的更可靠。这也是 datamaxxing 里最容易让人产生错觉的地方,大模型太擅长把零散信息整理成一个听起来合理的故事了。
监管的边界也因此越来越难划清。今年美国食品药品监督管理局(FDA)放宽了对部分低风险健康和健身产品的监管,只要产品停留在普通 wellness 场景,不声称能够诊断或治疗疾病。但 WHOOP 此前推出血压估算功能时,就曾因为越过普通健康管理的边界收到 FDA 警告。后来 WHOOP 修改了产品和表述,FDA 才根据新政策停止进一步执法。
不过这并不会阻止行业大趋势继续往前走。毕竟健康消费最诱人的地方,本来就在于人们永远想更了解自己。
