

2026华为全联接大会重磅官宣,新一代旗舰AI芯片昇腾960正式亮相!
相比此前官方公布的路线图,昇腾960研发进度大幅提前,单卡性能全面翻倍,搭配全球首款NPO近封装光学超节点。

版本划分+落地时间:双版本精准适配训练/推理
本次昇腾960摒弃单一版本设计,针对性推出训练、推理双版本,落地节奏全面提速,打破原有迭代规划:
昇腾960DT(风冷训练版):2027年Q1就绪、Q2正式上市,较原计划提前3个季度,主打超大模型预训练、AI科学计算等高负载算力场景。
昇腾960PR(液冷推理版):2027年Q3上市,较原计划提前1个季度,聚焦大规模在线推理、多模态内容生成、长文本交互等落地场景。
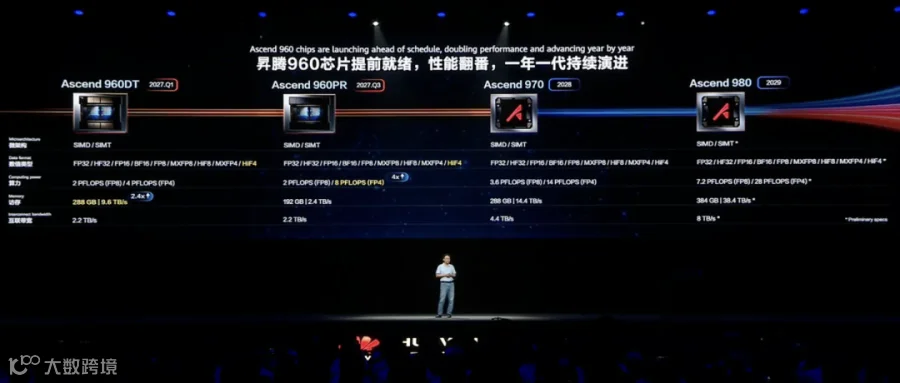
同时华为官宣昇腾迭代节奏:坚持一年一代,后续将推出昇腾970(2028年)、昇腾980(2029年),依托自研「τ(韬)定律」,实现算力、带宽、内存全维度持续翻倍升级。
单卡核心参数:全维度翻倍,对标顶级AI算力
相较于上一代昇腾950,昇腾960实现算力、显存、互联带宽全方位翻倍,单卡硬件参数拉满,可轻松适配万亿、十万亿级大模型基础算力需求:
核心算力:FP8精度2 PFLOPS,FP4精度4 PFLOPS,低精度算力大幅提升,完美适配大模型轻量化训练与高速推理
显存配置:最高288GB HBM高带宽显存,显存带宽高达9.6 TB/s,有效解决超大模型显存溢出、加载卡顿问题
互联能力:单芯片互联带宽2.2 TB/s,为多卡集群协同打下高速传输基础
全精度支持:兼容FP32、BF16、FP8等通用精度,搭载华为自研HiF4/HIF8低精度格式,相比通用FP4精度,推理效果更优,兼顾超高算力与模型精度
核心黑科技!Atlas 960 NPO超节点,重塑算力集群架构
当下AI模型进入十万亿参数时代,单芯片性能早已不是瓶颈,万卡集群的互联时延、功耗、稳定性才是制约超大模型训练的核心难题。而昇腾960最大的亮点,并非单卡升级,而是整套颠覆性的超节点系统。
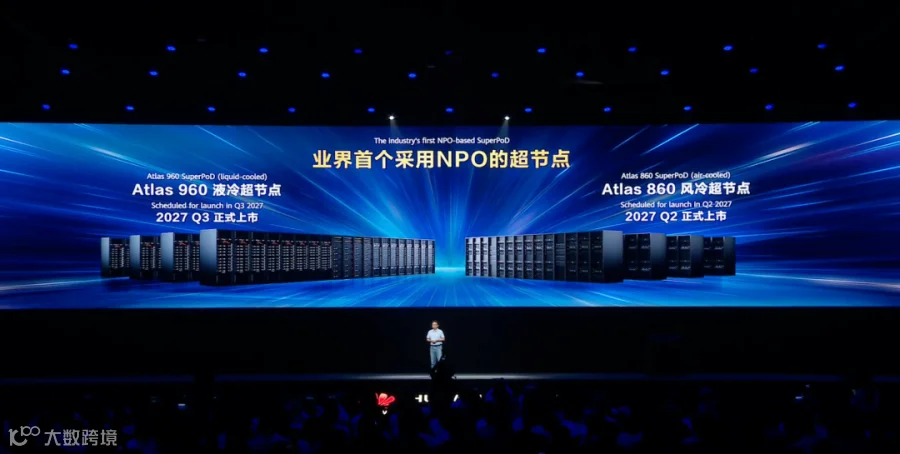
Atlas 960超节点由昇腾960芯片+灵衢UnifiedBus统一互联协议+Hi-ONE NPO光引擎三大核心组成,是全球首个量产落地的NPO近封装光学AI超节点。
1、超节点硬核参数
单节点规模:4096卡满血集群
集群总算力:FP8 8 EFLOPS、FP4 16 EFLOPS
总显存容量:1PB超大统一显存池
集群时延:4096卡互联最低RTT时延仅2μs
扩展能力:多超节点可横向互联,最大支持百万卡集群,完全覆盖十万亿级大模型训练需求
2、两大自研核心技术突破
✅灵衢UnifiedBus统一互联协议
打破服务器物理边界,实现跨设备统一内存编址,搭配「近铜远光」智能架构,让数千颗NPU像单台超级计算机一样协同工作,彻底解决多卡集群通信延迟高、数据同步慢的痛点。
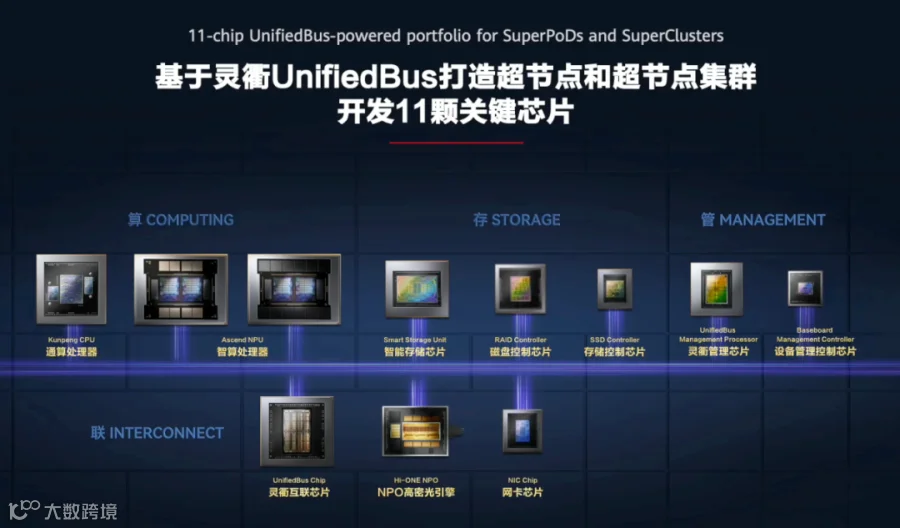
✅ Hi-ONE NPO近封装光引擎(业界唯一)
作为华为独家量产黑科技,这是业内唯一内置光源的NPO光引擎,单引擎传输容量达7.2T。将光引擎贴近芯片封装,大幅缩短电信号传输距离,兼顾高性能与低功耗。
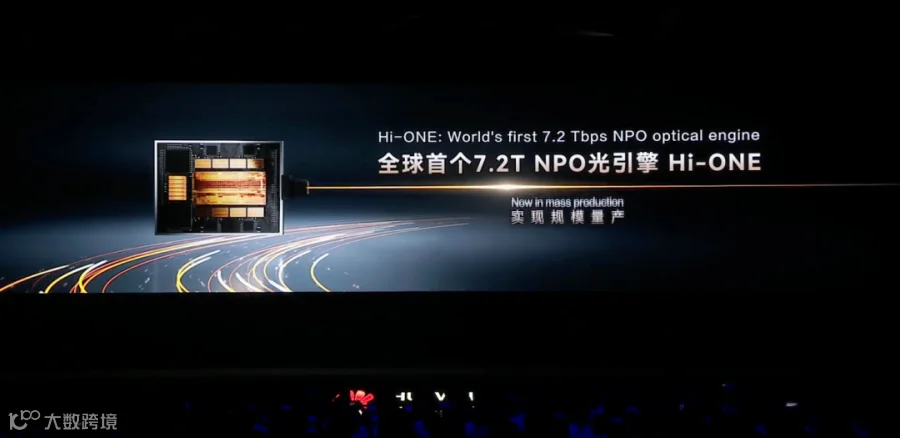
一台4096卡超节点,可通过5500个Hi-ONE光引擎,替代传统48000颗800G光模块,整机功耗直降550kW+,系统可用度提升至99.8%,设备无故障运行时间翻倍,完美适配超长期大模型训练任务。
结语
昇腾960+NPO超节点的落地,标志着国产AI算力迈入系统架构、光电协同、集群调度的高端竞争时代。
从单卡突破到系统革新,昇腾960不仅是一代旗舰芯片,更是国产AI算力弯道超车的核心利器。在全球AI算力竞争白热化的当下,以昇腾为核心的国产算力生态,正在开启全新的AI产业格局。