

今天,智谱发文披露,GLM-5.3 驱动的 Infra Agent,参与优化了承载 GLM-5.3-Flash 的推理系统。工程师与 Agent 共同推进,让模型从初始适配到生产就绪用了不到两周,端到端吞吐达到初始基线的约三倍。目前,GLM-5.3-Flash 的全部生产推理都运行在这套系统上。

图 1:唐杰称GLM-5.3 驱动的 Infra Agent 完成了其中大量工作。
该系统从首次成功运行到生产就绪用时不到两周,端到端吞吐达到初始基线的约三倍。
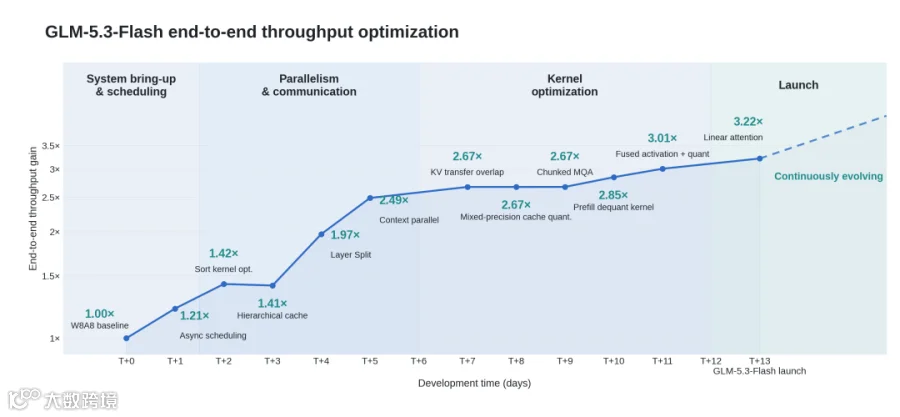
图 2:系统不到两周达到生产就绪,端到端吞吐达到初始基线的约三倍。
异步传输,卡在了发任务这一步
其中一个值得展开的修复,藏在 KV Transfer 里:底层明明支持异步传输,为什么加上这一步,性能还是明显下降?
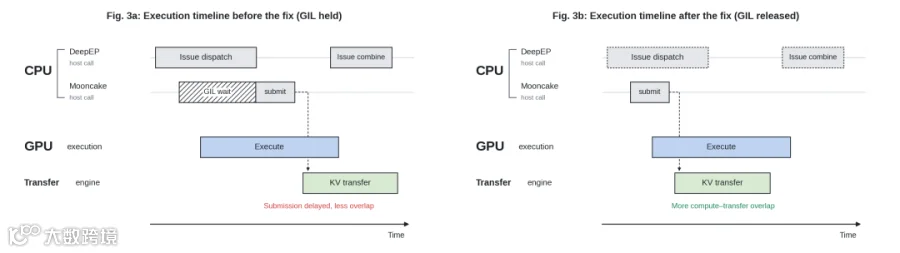
图 3:Z.ai 报告:相关 C++ 调用释放 GIL 后,传输线程得以及时提交任务,同条件下加入 KV Transfer 的性能差距降至 1% 以下。
团队给这项任务设了一条具体的验收线:相同负载下,Prefill + KV Transfer 与只做 Prefill 的性能差距,不应超过 5%。
Prefill 处理输入并生成 KV 缓存,KV Transfer 负责传送这些缓存。传输可以与后续计算重叠,因此,多一道传输不必把整段传输时间都加到总耗时里。
但 Agent 发现,部分场景的差距超过了 20%。
这个异常把排查范围缩小了:同样的负载,只做 Prefill 和加上传输,为什么会相差这么多?需要追的是传输加入以后,执行过程发生了什么变化。
时间线提供了关键线索。本应重叠的计算与传输没有充分重叠,传输任务的调度和提交被拖后了。
继续沿调用链往下追,问题落在 Python/C++ 边界:相关调用执行时,没有释放 GIL。
同一进程里,负责 Mooncake Transfer 的 Python 线程也需要拿到 GIL,才能推进传输任务的调度和提交。锁被其他调用占着,它就无法及时运行。于是,底层虽然具备异步传输能力,上层却迟迟没把任务发下去,原本可以与后续计算重叠的时间被消耗掉了。
异步能力要变成吞吐收益,任务首先得及时提交。
修复动作也落在这个边界上:让相关底层调用在执行期间释放 GIL,使传输线程能够及时获取锁、提交任务。
按照官方报告,在相同测试条件下,修复后 Prefill + KV Transfer 相对单独 Prefill 的性能差距降到了 1% 以下,低于最初设定的 5% 目标。
Agent 需要能查明原因的反馈
只告诉 Agent“吞吐下降了”,计算、传输、调度都有可能成为怀疑对象。这次排查中,有无 KV Transfer 的对照缩小了范围,时间线指向任务提交延迟,线程与调用的信息才进一步指向 GIL。
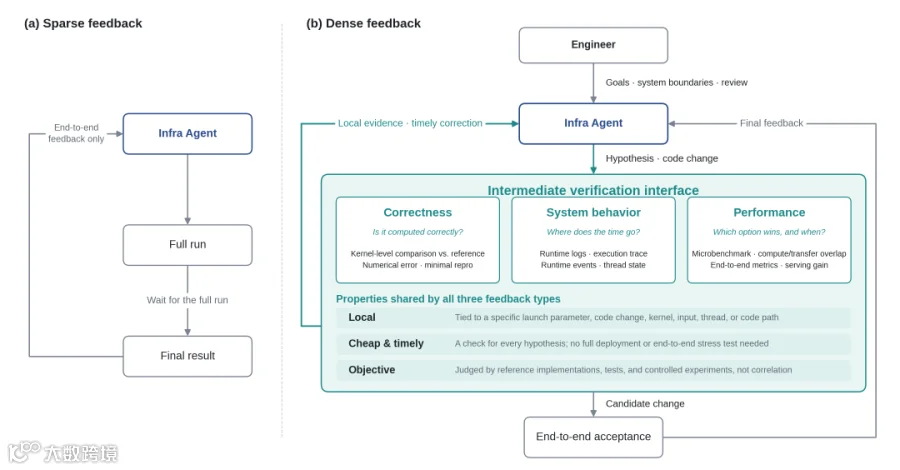
图 4:Z.ai 的反馈循环:工程师设定目标与约束、建设反馈环境并审核关键变更;反馈强调局部、低成本及时和可验证。
Z.ai 将这种做法称为“密集反馈”:让反馈对应具体输入、线程或调用,获取成本低、能及时返回,并能用测试和对照实验验证。关键在于,一次小实验就能回答眼前的问题,让 Agent 决定保留改动、继续定位,还是放弃当前假设。
Z.ai 把这项工作放在递归自我改进(RSI)的方向下讨论。这个案例展示的是:模型已经参与改进承载同系列模型的推理系统,改动可以通过运行结果得到检验。
工程师仍负责设定优化目标和系统约束,建设 Agent 能直接使用的反馈环境,并审核涉及架构、异步并发和生产风险的关键变更。官方明确表示,目前尚未达到递归自我改进。但模型参与改进推理系统、再由这套系统承载模型服务的关系,已经有了具体的工程案例。
参考链接
-
Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure:https://z.ai/blog/glm-built-its-inference-infrastructure -
Z.ai 官方发布推文:https://x.com/Zai_org/status/2100481236364079277 -
唐杰关于 GLM 推理基础设施的推文:https://x.com/jietang/status/2100482019088060470