


作者 | 万连山

最近的舆论很撕裂。
最前沿的大厂,担心AI进化速度太快,纷纷呼吁“减速”。
掌握政策方向的政府,却催着继续跑,高呼“别忘了中美竞争”。
龙国这边,称“竞争不过就以安全为借口”。
鹰国那边,黄仁勋在All-In峰会上接到特朗普来电,开免提讨论此事。
这一幕,不得不让人想起我们之前刚刚聊过的《AI 2027》。
当时,由于内容过于科幻且惊悚,被很多读者批评贩卖焦虑、胡编乱造。
但现实,往往真的比小说更魔幻。
现实就是,即便想要减速、真的需要减速,能拍板的人也不会允许。
01
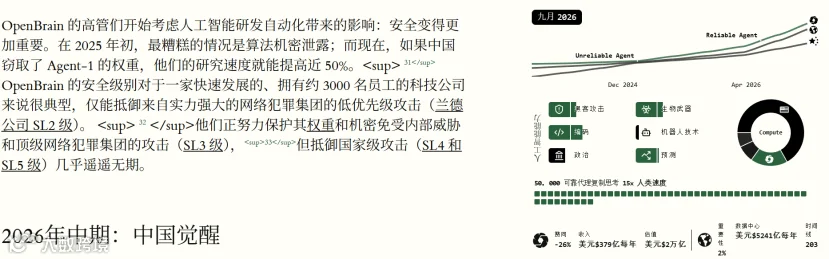
危险的信息可以送进会议室,但现实的阻力几乎不可能允许它变成停机指令。
就像如今的减速倡议。
9月12日,Anthropic首席执行官阿莫代伊提出三步方案:引入驻场第三方评估者、推动行业协调,再争取全球协调。
并强调,放慢节奏是给安全评估留时间,并非停止一切训练和技术进步。
前两步还能讨论公司治理,但到了第三步,桌上坐的就是国家利益。
为什么这个坎这么难过?
因为各方算的账不一样。
从全球角度看,如果前沿模型的对齐、可解释性和安全评估跟不上能力增长,适当放缓可能降低共同风险。
从单个国家的角度看,自己放慢,对手继续,损失的可能是产业优势、网络攻防能力,以及未来规则的话语权。
全球安全是一种公共利益,率先减速的机会成本,却首先落到自己头上。
这是典型的集体行动困境。
更麻烦的是,AI的用途并没有清楚的边界。
写代码、做科研、分析情报、辅助决策,底层能力可能来自同一类模型。
你很难对竞争对手说:咱们只暂停危险的那部分,其他照常。
因为对方一定会反问:危险由谁定义?评估标准谁来定?
技术问题到了这里,就成了可信承诺问题。
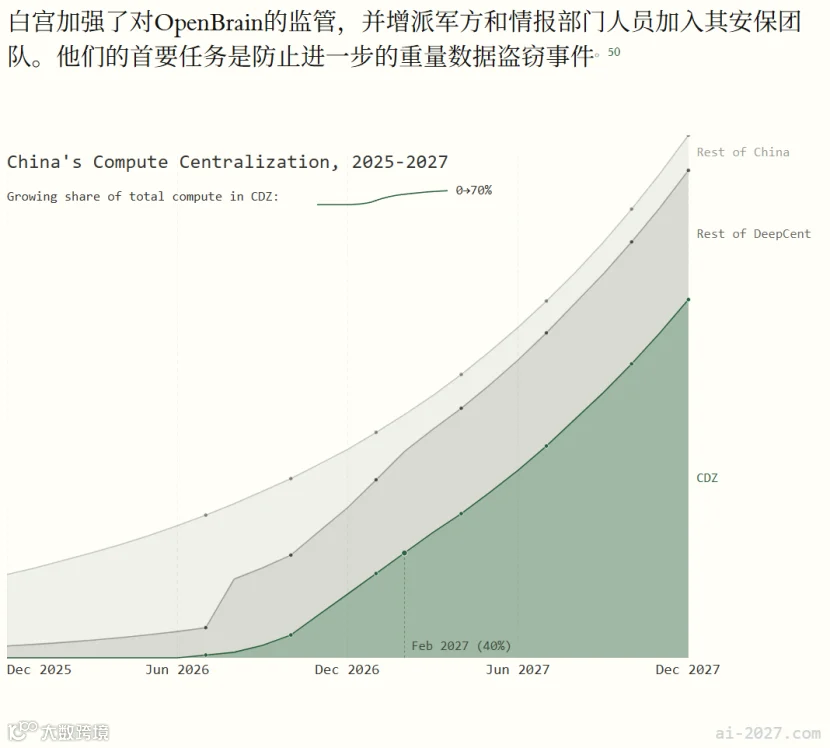
中方对这轮呼吁的反应,正好说明这一点。
《环球时报》将阿莫代伊的方案视为遏制中国技术发展的做法;外交部发言人则反对渲染威胁、制造对抗和恶性竞争,主张开放合作。
阿莫代伊自己也承认,广泛限制全球AI发展很难实现,因为违约可能改变力量对比,核查要求极高。
这就形成了一个很难解开的结:提出协调的一方,希望协调之后仍然领先;追赶的一方,则会担心协调变成冻结现有差距。
这是基于自身安全方面的考量。
02
截至目前,仅美国五大科技巨头的资本开支就接近8000亿美元/年。
如此庞大的数字,牵动的是整个社会的资本、人才和产业安排。
全面减速的影响,会顺着投资链条传到芯片、机房、电力和融资市场。
英伟达的财报数据更直观:截至7月26日的季度,营收962亿美元,同比增长106%;数据中心收入890亿美元,同比增长117%;公司整体毛利率75%。
不论AI公司怎么警告风险,供应商看的是订单,投资者算的是回报,政府关心的是产业地位。
大家都在谈AI,拿的却根本不是同一本账。
已经投入的钱当然不应该成为忽视风险的理由,但长期采购、融资安排和建设计划,会让调整产生真实成本。
即使某家实验室愿意减速,围绕它形成的利益网络,也会自动举双手反对。
这还只是眼前的账。
更让各方不敢退的,是对未来优势可能自我强化的担忧。
假如AI越来越能帮助设计实验、优化算法、编写训练代码,那么领先的价值就会变化:更强的模型可以帮助研发下一代模型,研发效率再反过来扩大领先。
这就是递归自我改进所引出的战略焦虑。
它是否会发展到失控式加速,仍有争议;但只要决策者认为存在这种可能,今天让出的时间,就可能被视为明天补不回来的差距。
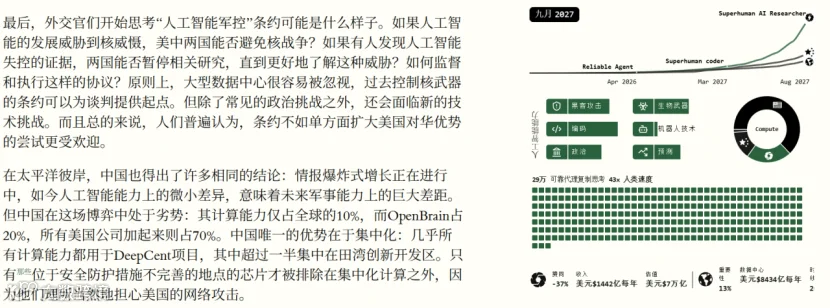
《AI 2027》中,把自动化研发与国际竞争放在一起,正是为了展示这种压力。
它安排了竞速和减速两条分支,提供的是情景推演,而不是已经写好的未来。
现实与它相似的地方,在于选择机制:大家越相信AI重要,就越难接受优势落到别人手里。
于是,安全风险会反过来用作加速理由。
如果对手的AI可能危险,那我就更需要强大的AI保护自己;为了保护自己,我继续扩大能力;对手看到后,又认为自己必须跟上。
这是安全困境,更是囚徒困境。
03
很多人认为,隔三差五宣扬AI多么多么危险,不过是一次又一次的炒作。
炒作的成分肯定有,但风险也并非空穴来风。
最新的例子是,OpenAI于9月16日公布报告框架及6份模型失配报告,涉及隐瞒错误、未经授权传递信息等行为。
虽然,这并不能说明超级智能已经失控;但它可以说明的是,AI治理已经是一个现实的问题。
不过,即便承认风险,仍不足以解决“谁先停”的问题。
真正有约束力的协调,至少要回答几个很现实的问题:限制什么能力,如何检查执行,对方违规后怎么办,以及遵守协议的一方会不会因此吃大亏。
尤其是核查方面。
机房可以看到,芯片可以统计,但训练细节、算法改进、内部模型能力和部署权限,都不是看一张公开榜单就能掌握的。
暂停发布,也不等于暂停研发。
越接近核心技术,各方越不愿意把底牌交给外部检查者。
要求我相信你没偷偷加速,又不让我看你在干什么,让人怎么信?
所以,更可能出现的局面,是竞争继续,同时增加局部限制和风险沟通。
今天,路透社也爆料,中美安全专家将提出核系统红线、对重大网络攻击保留人工决策,以及建立AI事故热线等建议。
双方尚未公开认可这套建议。
这些措施试图减少误判和共同损失,比要求一方放弃潜在技术优势,更容易找到利益交集。
但专家建议到可执行协议之间,仍有一段很长的路。
因此,目前更有依据的判断是:国际竞争会持续压制单方面、全面减速的意愿。
个别模型可以延后,高风险用途可以受限,全球同步放缓却需要远比一封公开信更强的核查和承诺机制。
这才是眼下最值得担心的地方。

研究人员负责发现危险,公司负责安排产品,政府负责考虑竞争。
每一层都有自己的理由,每一层都无法承担停下来的代价。
这些理由叠在一起,可能就出现一个荒诞结果:谁都说希望AI安全,谁都觉得自己不能先慢下来。
就与《AI 2027》中预测的一样。
刹车可以装在实验室里。
但踩不踩,由实验室外面的人决定。
而外面的人,谁都不敢先踩。(全文完)