

浙江大学徐步强投稿
大语言模型正在从简单问答走向更复杂的长程任务。
一个 Agent 可能需要连续读取文件、调用工具、执行代码、访问网页、修改项目,并在多个任务之间持续维护上下文。
上下文一旦不断增长,问题就来了。每一轮请求都可能携带越来越多的历史信息,输入 token、推理延迟和 API 成本也会随之增加。
更麻烦的是,长程 Agent 的成本并不只由 token 数量决定。现在许多模型服务都支持 prompt prefix cache 或 KV Cache。
当连续请求之间共享稳定的 prompt 前缀时,后端可以直接复用已有计算结果,缓存命中的 token 成本远低于重新计算的 token。
但如果系统频繁截断、摘要、重排上下文,哪怕只改变了前缀中的一小部分,也可能让原本可以复用的缓存失效。
这就形成了一个矛盾:上下文变短了,cache miss 却可能变多;token 节省了,整体推理成本反而没有下降。
为此,浙江大学联合HomologyAI 等提出了 TokenPilot,在减少上下文负担的同时,尽可能保持 prompt 前缀的稳定和缓存的连续复用。
目前,该成果已被 EMNLP 2026 Findings 录用。
此外,研究团队已将对应功能作为插件适配到Codex、Claude code、OpenClaw 、 Deepseek-Harness等agent框架中。
以Codex为例,TokenPilot 提供的上下文任务清理功能
01
TokenPilot:上下文管理不能
只追求“更短”
TokenPilot 是一个面向长程 Agent 的上下文与KV Cache管理优化框架。

长程 Agent 的上下文增长与 KV Cache 问题
它不修改基础模型参数,也不依赖重新训练,而是在 Agent runtime 层面管理上下文的进入、组织和退出。
它同时考虑四个问题:哪些信息值得进入上下文?信息进入上下文时应当采用什么布局?历史上下文什么时候可以被移除?如何让连续请求尽可能复用已有的 prefix/KV cache?
TokenPilot 的方法由两个核心部分组成:Ingestion-Aware Compaction 和 Lifecycle-Aware Eviction。
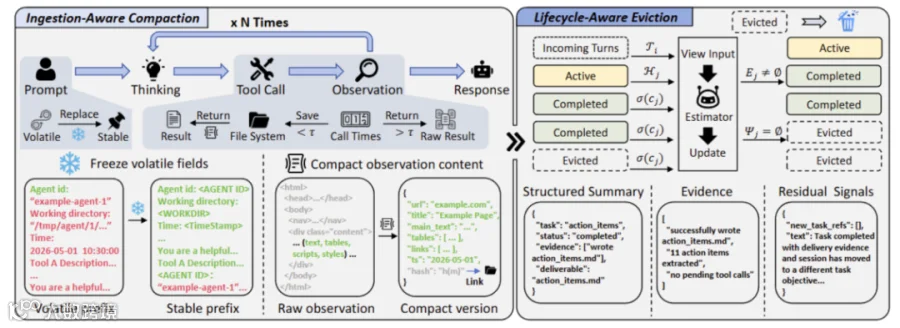
TokenPilot 整体流程
02
信息进入上下文之前,
先进行整理
很多上下文噪声并不是 Agent 真正需要长期保留的信息。例如,工具返回的 HTML 页面可能包含大量标签和样式,终端输出可能携带重复的格式符号、行号和调试日志,某些结构化结果中也可能存在大量低价值字段。
如果这些内容未经处理就进入上下文,它们不仅增加 token,还可能污染之后的 prompt layout。
于是TokenPilot 在信息进入上下文前进行整理,主要包括两类操作。
第一类操作是 Prefix Stabilization,也就是前缀稳定化。Agent ID、工作目录、时间戳和工具 schema 等容易变化的字段,可能导致相邻请求之间的 prompt 前缀不再完全一致。
TokenPilot 会将这些运行时易变信息转换为稳定的占位表示,并规范化工具定义和上下文布局,使后续请求能够更可靠地复用缓存。
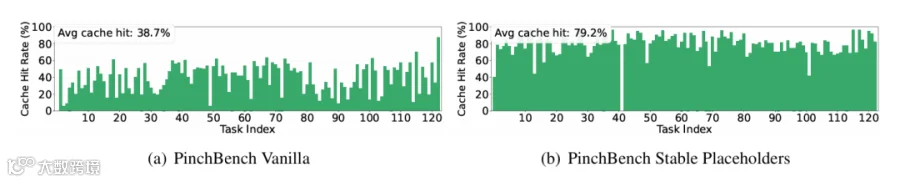
PinchBench 中使用Prefix Stabilization 前后的 cache hit rate 对比
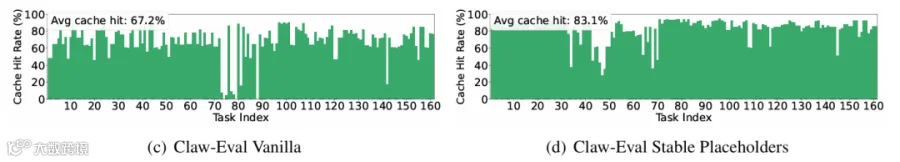
Claw-Eval 中使用Prefix Stabilization 前后的 cache hit rate 对比
第二类操作是 Observation Reduction,也就是观测结果压缩。系统会在工具结果进入后续上下文之前,对 HTML、日志、JSON 和其他结构性噪声进行确定性的压缩和清理。
这里的关键不是“看到内容就删除”,而是把高频、低价值、可恢复的结构性信息从活动上下文中移出,同时保留任务真正需要的语义内容。
在部分任务中,TokenPilot 的 reduction pass 最多移除了约 115k 个字符的 HTML 和网页结构噪声,以及约 883k 个字符的终端日志。
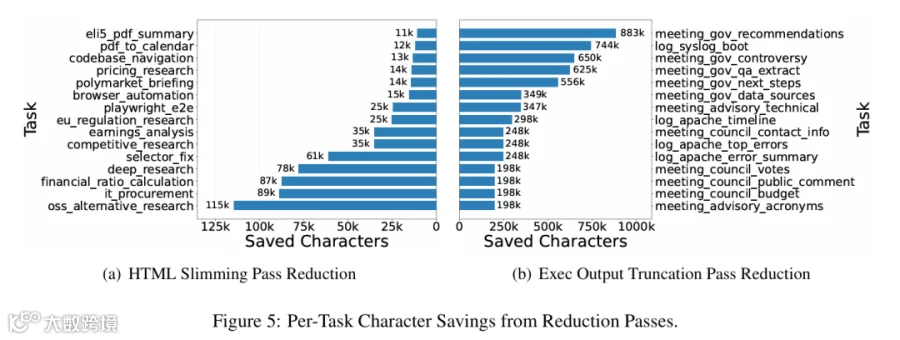
Reduction Pass 削减字符效果详情
如果历史工具结果被直接删除,Agent 后续一旦需要其中的细节,就只能重新执行工具调用,或者从头读取文件。
这种补偿性行为会带来新的工具反馈,反过来又让上下文重新膨胀。
TokenPilot 为此保留了 recovery tool。被压缩的完整 payload 会被保存到外部归档中,活动上下文中只保留紧凑表示和恢复入口。
Agent 在确实需要原始内容时,可以按需恢复,而不是被迫重新执行整个操作。
实验中的组件分析表明,去掉 recovery tool 后,任务效果和成本都会受到影响。Recovery Tool 因此不是一个可有可无的附加功能,而是让 reduction pass 能够安全工作的关键边界。
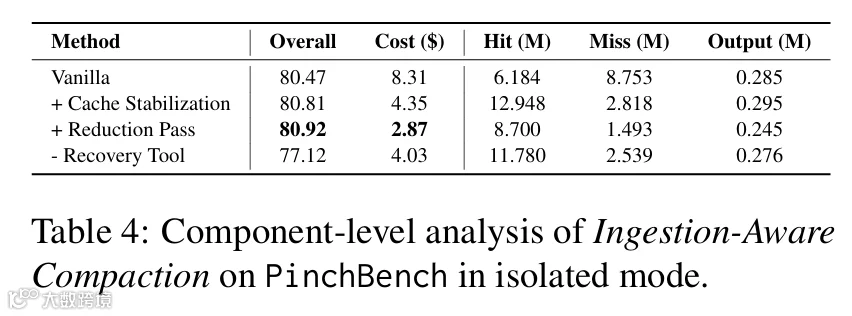
Ingestion-Aware Compaction 组件分析
这张表将 Cache Stabilization、Reduction Pass 和 Recovery Tool 的贡献拆开。
加入 Cache Stabilization 后,成本从 8.31 美元降至 4.35 美元;再加入 Reduction Pass 后降至 2.87 美元。
移除 Recovery Tool 后,成本回升到 4.03 美元,任务分数也从 80.92 降至 77.12,说明工具调用结果进行 Reduction 必须和可恢复机制配合使用。
03
历史上下文什么时候
应该退出
即使每一轮只增加少量内容,长程会话中的历史上下文仍然会持续积累。

长程对话过程中历史上下文累积趋势
TokenPilot 使用轻量的模型估计器判断任务的完成状态和 residual utility,进而为每个上下文片段维护生命周期状态,并根据任务级别的剩余使用价值决定是否移除。
一个片段通常会经历:active -> completed -> evictable。
处于 active 状态的片段仍然参与当前任务,不能被移除;completed 表示任务已经完成,但相关内容可能仍有短期价值。
只有当剩余使用价值进一步降低,并且存在明确完成证据时,片段才会进入 evictable 状态。进入 evictable 状态后,系统才会将其从活动上下文中移出。
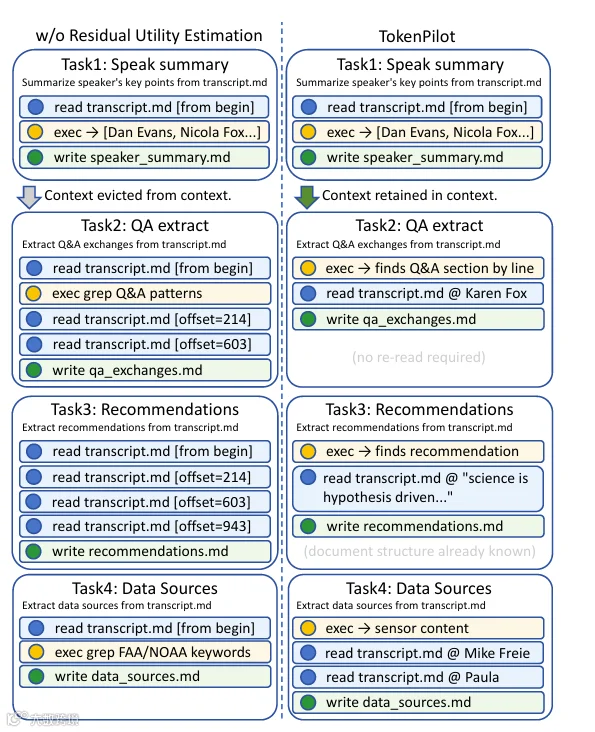
Residual Utility 估计对工具调用行为的影响
我们可以看到在transcript.md的四任务会话里,有残余效用估计的 TokenPilot 在任务完成后保留上下文段,后续任务直接访问相关文档片段。
没有残余效用估计时,任务直接从 active 被判断为 evictable 从而移除出上下文,导致每个任务从头读文件,发出多次顺序 partial read 定位同一内容
TokenPilot 的分析实验比较了不同 turn batch size 频率进行 Residual Utility 估计对上下文窗口、cache hit、cache miss 和 API 调用次数的影响。
当 batch size 为 1 时,系统几乎每轮都可能触发检查和清理。虽然历史上下文下降得更快,但频繁重写会破坏 prompt 的布局连续性,导致更多 cache miss。
当 batch size 过大甚至不进行中途检查时,历史上下文又会积累过多,清理不够及时。
在论文实验中,batch size 为 3 在任务效果、上下文规模、API 调用次数和缓存复用之间取得了较好的平衡。
这说明上下文管理不仅要决定“删不删”,还要决定“什么时候删”。
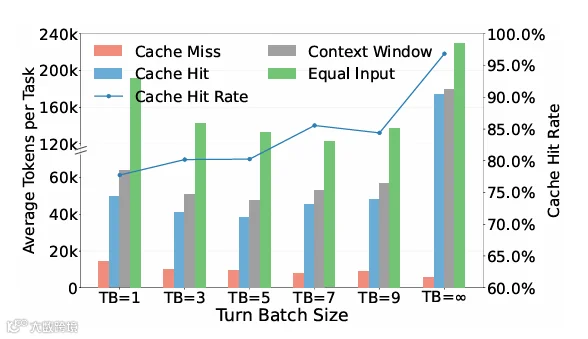
不同 turn batch size 频率判断对任务开销的影响
04
成本大幅下降,任务效果
保持竞争力
TokenPilot 在两个真实 Agent 评测基准上进行了测试:PinchBench 和 Claw-Eval。
实验包含两种模式:
Isolated:每个任务使用独立上下文,用于观察单任务设置下的表现;
Continuous:多个任务在同一个持续会话中执行,用于观察长程上下文增长和跨任务 cache reuse。
在 isolated 模式下,TokenPilot 在 PinchBench 和 Claw-Eval 上分别降低约 61% 和 56% 的推理成本。
PinchBench 上的任务分数从 Vanilla 的 80.5 提升到 81.0;Claw-Eval 上为 63.1,相比 Vanilla 的 64.5 略低,但仍处于相近水平。

PinchBench 主结果
在更能体现长程上下文问题的 continuous 模式下,TokenPilot 在 PinchBench 上将成本从 Vanilla 的约 7.24 美元降至约 2.79 美元,成本降低约 61%。
在 Claw-Eval 上将成本从约 81.52 美元降至约 10.58 美元,成本降低约 87%。
与此同时,TokenPilot 在 PinchBench continuous 上取得约 81.3% 的任务分数,高于 Vanilla 的 79.2%。Claw-Eval continuous 上,TokenPilot 为 60.8%,Vanilla 为 63.4%。
这表明 TokenPilot 的核心目标是显著降低推理成本,同时保持具有竞争力的任务效果,而不是在所有任务上都提高分数。
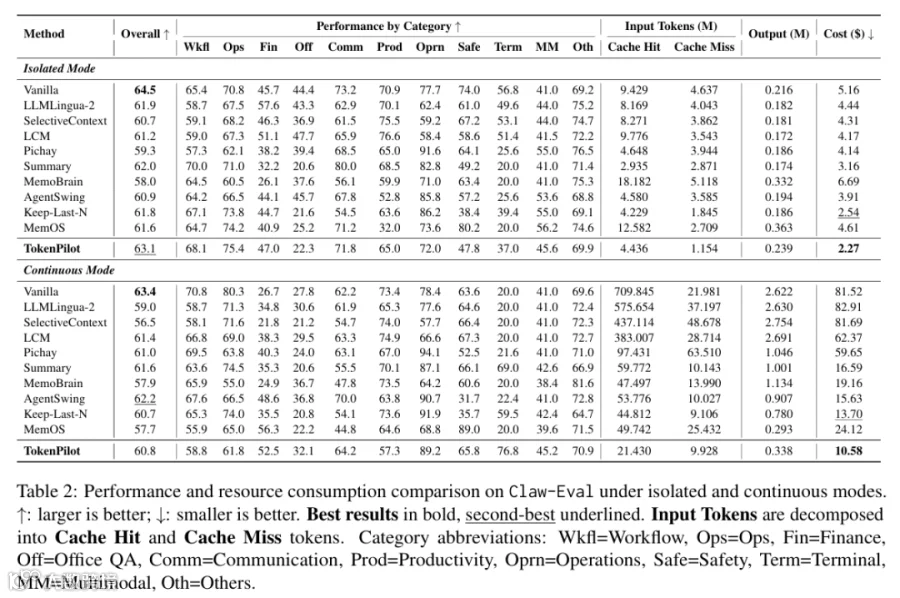
Claw-Eval 主结果
cache miss分别为 1.549M 和 9.928M tokens,明显低于 Vanilla。
05
Cache 命中率:从 38.7% 提升
到 79.2%
TokenPilot 的核心收益不仅在于减少输入 token,还在于让更多输入 token 变成可以复用的 cache hit。
在 PinchBench 上,宏观 cache hit rate 从 38.7% 提升到 79.2%;在 Claw-Eval 上,从 67.2% 提升到 83.1%。
稳定化之后,PinchBench 中大量请求不再停留在 2,048 token 的有限命中,而是迁移到更长的可复用前缀。
Claw-Eval 也从几乎全部 0 token 命中,转为在 6,144、6,656 等稳定前缀长度上获得大量 warm-start hit。
Cache hit rate 的提升并不是简单由减少输入 token 得到的,而是 prompt layout 被稳定下来之后的直接结果。
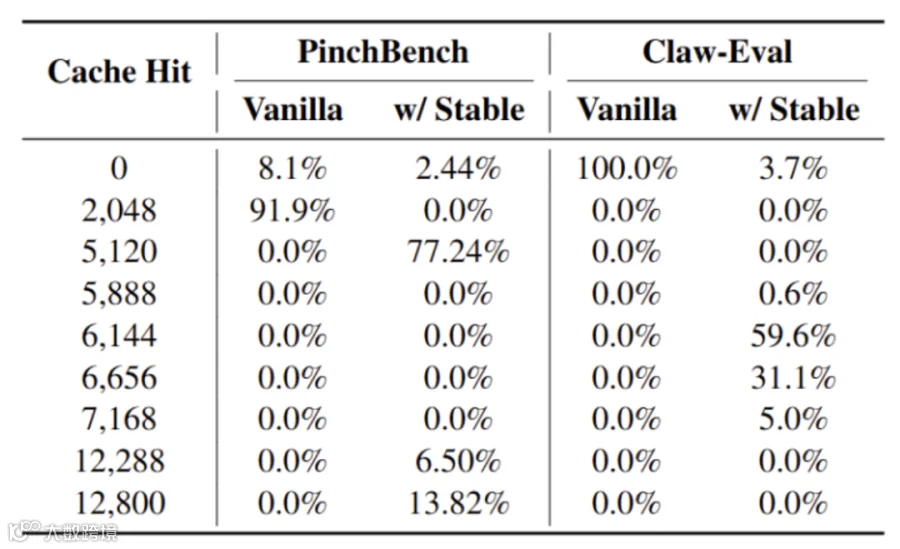
warm-start 前后 cache hit token 的分布
06
每个组件分别贡献了什么
为了回答“TokenPilot 为什么有效”,论文进一步进行了多组分析实验。
1. 渐进式组件消融
从 Vanilla 开始,逐步加入 Global Level 和 Local Level,可以观察到成本、cache miss 和任务分数的变化:
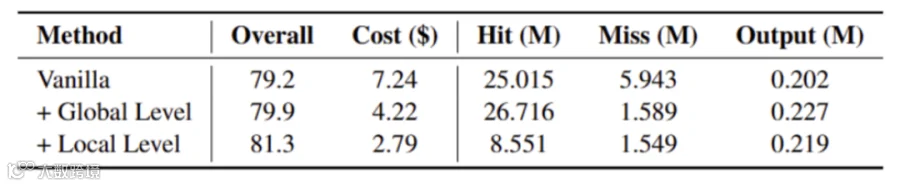
TokenPilot 组件的渐进式消融
加入 Global Level 后,成本从 7.24 美元降至 4.22 美元,cache miss 从 5.943M 降至 1.589M;进一步加入 Local Level 后,成本降至 2.79 美元,任务分数提升到 81.3。
全局稳定化主要保护前缀和缓存连续性,局部生命周期管理则进一步抑制历史上下文增长。
这说明 TokenPilot 的收益来自多个层次的配合:前缀稳定化负责保护缓存连续性,reduction pass 负责减少进入上下文的冗余信息,生命周期移除负责控制历史上下文的长期增长。
2. Prefix Stabilization 单独应用存在上限
论文还将 Prefix Stabilization 单独应用到 Vanilla、Summary 和 Keep-Last-N 等 baseline 上。
结果显示,稳定前缀可以普遍减少 cache miss,但它不能完全解决固定窗口截断的问题。
尤其是 Keep-Last-N,即使任务相关的后续上下文能被良好保持,由于前缀被窗口截断,因此无法恢复完整的 cache reuse。
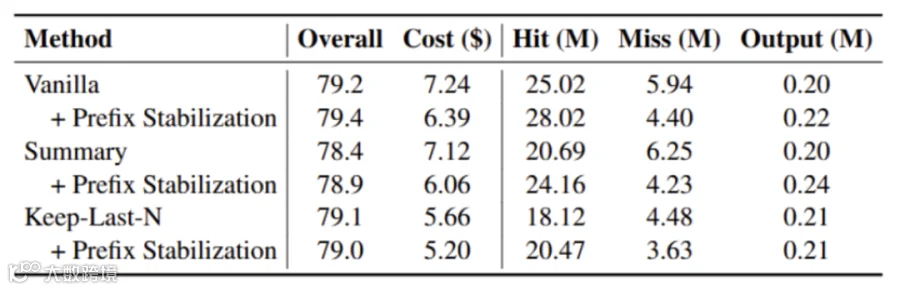
Prefix Stabilization 对其他 baseline 的影响
在 Vanilla、Summary 和 Keep-Last-N 上加入 Prefix Stabilization 后,三种方法的 cache miss 都下降,成本也分别从 7.24 降至 6.39、从 7.12 降至 6.06、从 5.66 降至 5.20。
3. Residual Utility 与简单保留规则的比较
Lifecycle-Aware Eviction 还与几种更简单的 retention signal 进行了比较,包括:最近三轮任务、最近访问过的文件、最近使用过的工具,以及任务类别。
这些规则各自抓住了局部相关性,但并不能直接判断一个任务是否真正完成、历史内容是否还会被再次使用。

不同 retention signal 的对比
在 category-grouped streams 中,Residual-utility 的成本为 4.69 美元;在 mixed-category streams 中,成本为 5.25 美元,均低于表中的其他 retention signal。
它不一定在每个指标上都最优,但在任务保留、上下文清理和缓存成本之间取得了更稳定的综合平衡。
TokenPilot 的核心贡献不是提出一个单独的文本压缩技巧,而是重新定义了长程 Agent 上下文管理的优化目标:
上下文管理既要考虑信息的语义有效性,也要考虑上下文布局对物理KV cache 连续性的影响。
传统方法往往主要关注“上下文中还剩多少 token”。
TokenPilot 则进一步关注“这些 token 是否能够在下一次请求中被缓存复用”,并将前缀稳定化、输入侧压缩和生命周期移除放入同一套 runtime 框架中协同处理。
07
适用范围与 LightRSI
TokenPilot 的直接 cache 收益依赖推理后端支持 prompt prefix cache 或 KV Cache。
对于不支持这类缓存的后端,前缀稳定化的收益会受到限制,但上下文 reduction 和生命周期管理仍然具有独立价值。
此外,continuous evaluation 中的任务排列方式会影响跨任务复用。
category-grouped stream 通常拥有更强的任务和工具连续性,而 mixed-category stream 会带来更多工具 schema 和任务类型变化,因此缓存复用更困难。
LightRSI Logo
TokenPilot 是 LightRSI 面向长程 Agent 的第一个组件,关注的是 Agent 的 Context RSI:在不更新基础模型参数的情况下,持续自我改进上下文的构造与管理策略。
LightRSI 提供承载这类递归改进能力的 runtime,包括状态管理、生命周期、安全边界、可观测性和不同 Agent host 的适配。
作者团队声称后续将在此基础上继续研究 Memory RSI 和轻量 Parameter RSI,分别自动化改进 Agent 的记忆管理策略以及模型参数或参数适配策略。
08
总结
对于长程 Agent,真正高效的上下文管理不能只追求更短的输入。
它还需要尽量保持 prompt 前缀稳定,让已有的 KV Cache 能够被持续复用;同时根据任务生命周期,判断哪些历史内容已经失去价值,避免上下文无限增长。
TokenPilot 通过 Ingestion-Aware Compaction 和 Lifecycle-Aware Eviction,将这两个问题统一到一个 cache-aware runtime 中。
在 PinchBench 和 Claw-Eval 上,TokenPilot 在保持竞争性任务效果的同时显著降低了推理成本,并将宏观 cache hit rate 提升到 79.2% 和 83.1%。
这项工作表明,Agent 的效率优化不仅可以发生在模型参数层,也可以发生在模型之外的上下文管理层。对于越来越长、越来越复杂的 Agent 任务,这可能是实现低成本持续运行的一条重要路径。
END
关注+星标,获取AI前沿进展与开源一线动态