

今天,MiMo负责人罗福莉公布了MiMo-V2.6的最新进展。
过去近半年,团队一直在围绕强化学习进行探索,目前这轮RL训练仍在进行中。
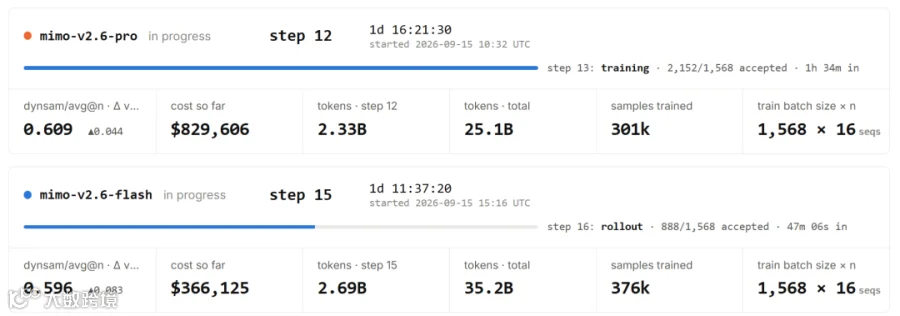
目前,MiMo-V2.6每个训练Step大约处理20亿Token,使用1568个Prompt,每个Prompt进行16次Rollout,整个过程采用异步运行。

这一次,MiMo把训练规模继续往上推,同时扩展了Agent任务环境,并重新设计了评估和奖励计算方式。
MiMo-V2.6采用多任务Agentic RL,在同一轮训练中混合多个测试框架,让模型处理不同类型的Agent任务。
目前,小米已经上线MiMo-V2.6 RL实时训练页面,公开了Pro和Flash两条训练线,可以查看训练Step、Token、Rollout以及部分评测数据,页面数据也会随着训练持续更新。
公开的实时训练指标显示,MiMo-V2.6 Pro每个Step处理约 23.3亿Token,Flash每个Step约 26.9亿Token。
同时这轮RL训练的任务主要集中在编码场景,编码任务约占70%,视觉任务约占13%,一般任务约占12%,聊天强化学习仅占3%。

训练过程中,MiMo还使用了Dynamic Sampler。公开页面显示,Pro和Flash分别对应独立的Dynamic Sampler训练任务。
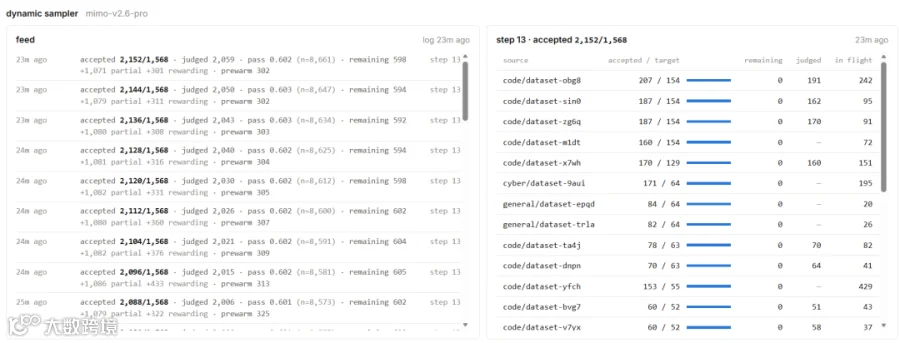
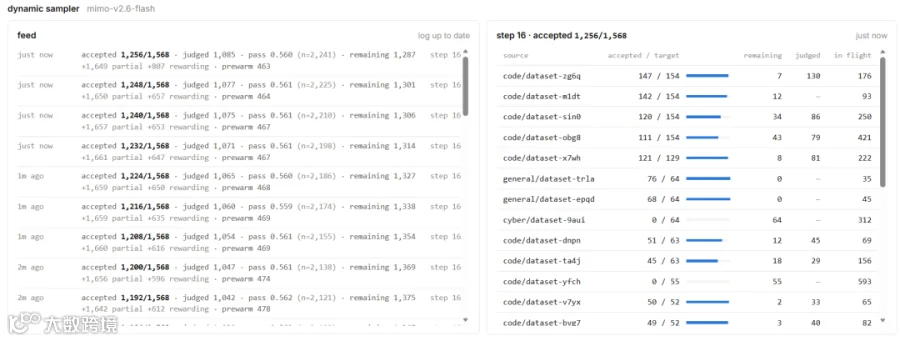
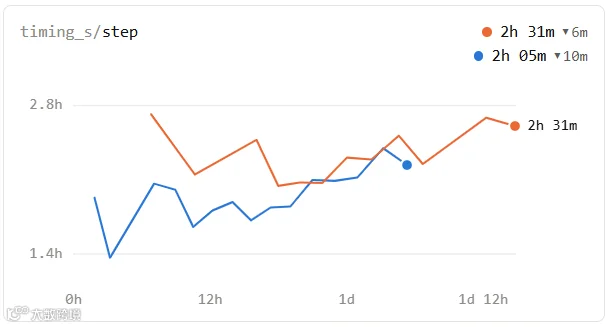
从公开的数据可以看出,一个完整Step,Pro需要约 2小时31分钟,Flash约 2小时5分钟。
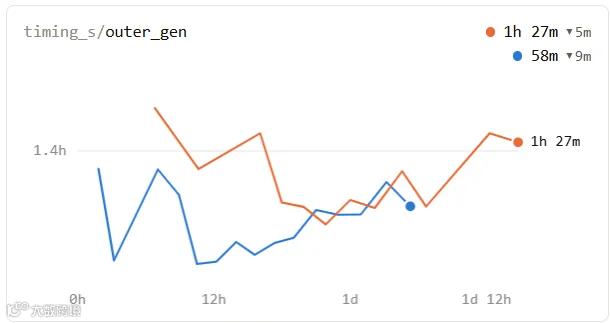
其中,Pro的outer_gen耗时约1小时27分钟,Flash约58分钟;trainer_ops分别约1小时和1小时3分钟。
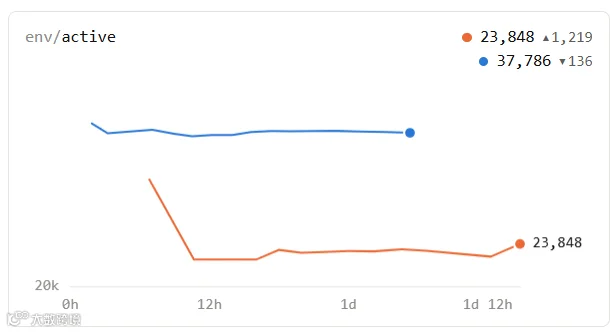
训练中的活跃环境数量达到数万级,Pro当前有 23,848个活跃环境,Flash达到 37,786个。
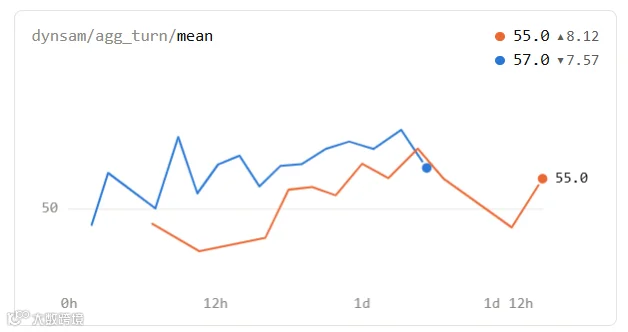
dynsam/agg_turn/mean显示,Pro为55.0,Flash为57.0,平均交互轮数达到50多轮。
奖励数据也被实时记录在训练面板中。
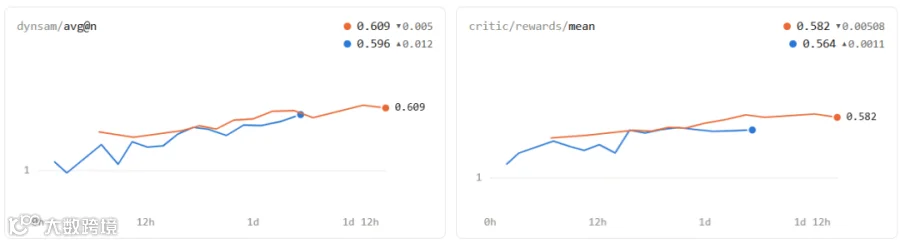
目前Pro的critic/rewards/mean为 0.582,Flash为 0.564;dynsam/avg@n分别为 0.609和 0.596。
dynsam/passrate/zero方面,Pro和Flash均为15.1%;
dynsam/passrate/one方面,Pro为24.8%,Flash为23.5%。

任务变长也直接体现在上下文长度上,当前ctx_total_length/mean显示,Pro平均上下文长度约 93.1K Token,Flash约 107K Token。

任务完成后,奖励如何分配同样是训练中的一个关键问题。
MiMo团队这次加入了Agentic组内信用分配,并结合测试用例和基于量规的奖励,对模型产生的不同执行轨迹进行评估。
同一个任务可以产生多条Rollout轨迹,系统会根据任务最终结果、测试用例以及评分标准,对这些轨迹进行比较,再把结果反馈给RL训练。
目前页面上的数据仍处于实时变化状态,并不代表MiMo-V2.6最终版本的固定指标。
MiMo此次直接公开正在运行的RL训练页面,外界可以实时查看部分训练数据和评测结果。
未来几周,MiMo团队还会逐步公开这轮训练的更多细节。
END
关注+星标,获取AI前沿进展与开源一线动态